Databases in the Agent Era
Agent tạo hàng triệu database ngắn hạn: instant provisioning, scale to zero, copy-on-write branching trên vanilla Postgres và anonymization bằng pgstream.
1. Postgres 40 tuổi: sinh ra cho người, giờ phục vụ agent
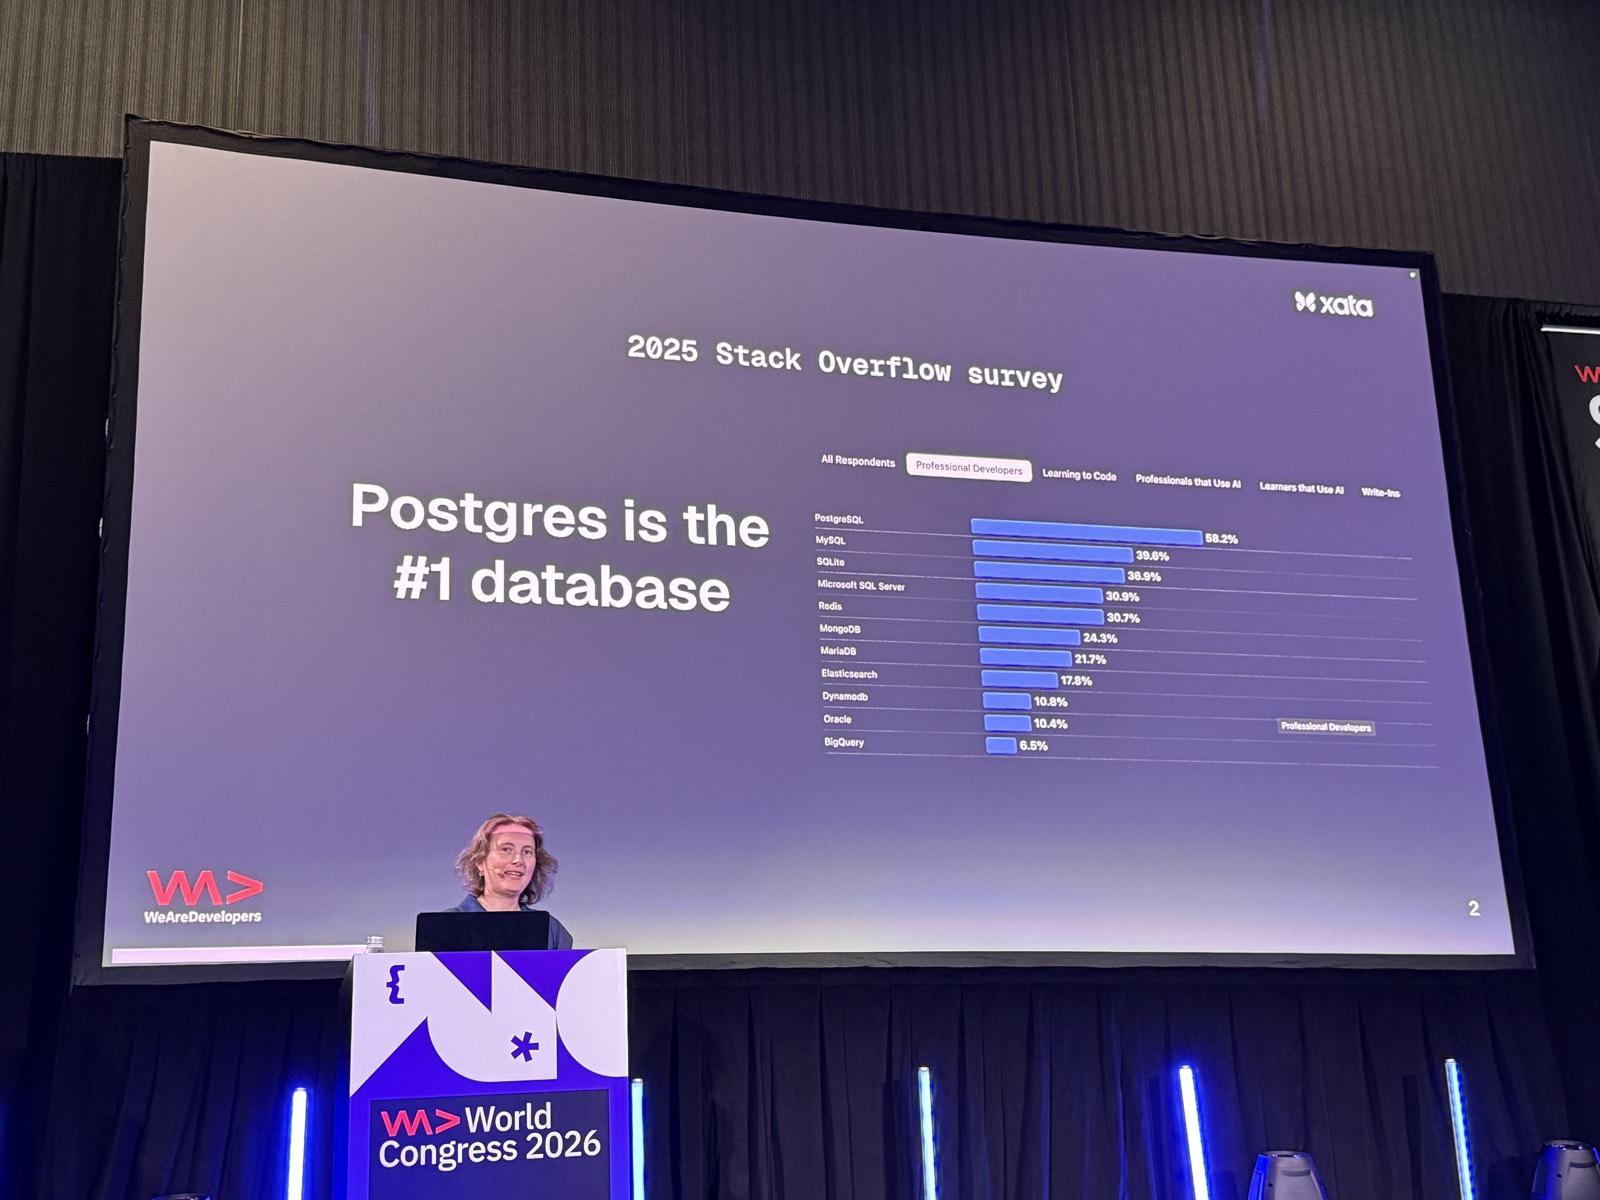
Monica Sarbu mở đầu bằng một con số mà chính chị thấy "incredible": trong Stack Overflow survey năm ngoái (2025), Postgres là database số một. Mấy năm gần đây nó tăng rất nhanh, và giờ đứng ở khoảng 58%. Chị nhấn mạnh survey này lấy nhóm professional developers, tức là người làm nghề thật, không phải người đang học.
Vì vậy trong cả talk, khi chị nói "database" thì hiểu là chị đang nói về Postgres. Và điều chị thấy thú vị: năm nay Postgres tròn 40 tuổi. Khi được thiết kế cách đây 40 năm, nó được build cho con người dùng. Bây giờ nó phải phục vụ agent. Nói cách khác, user persona của database đang đổi, và talk này xoay quanh chuyện đó.
2. The shift is already here: 80% database trên Neon do agent tạo
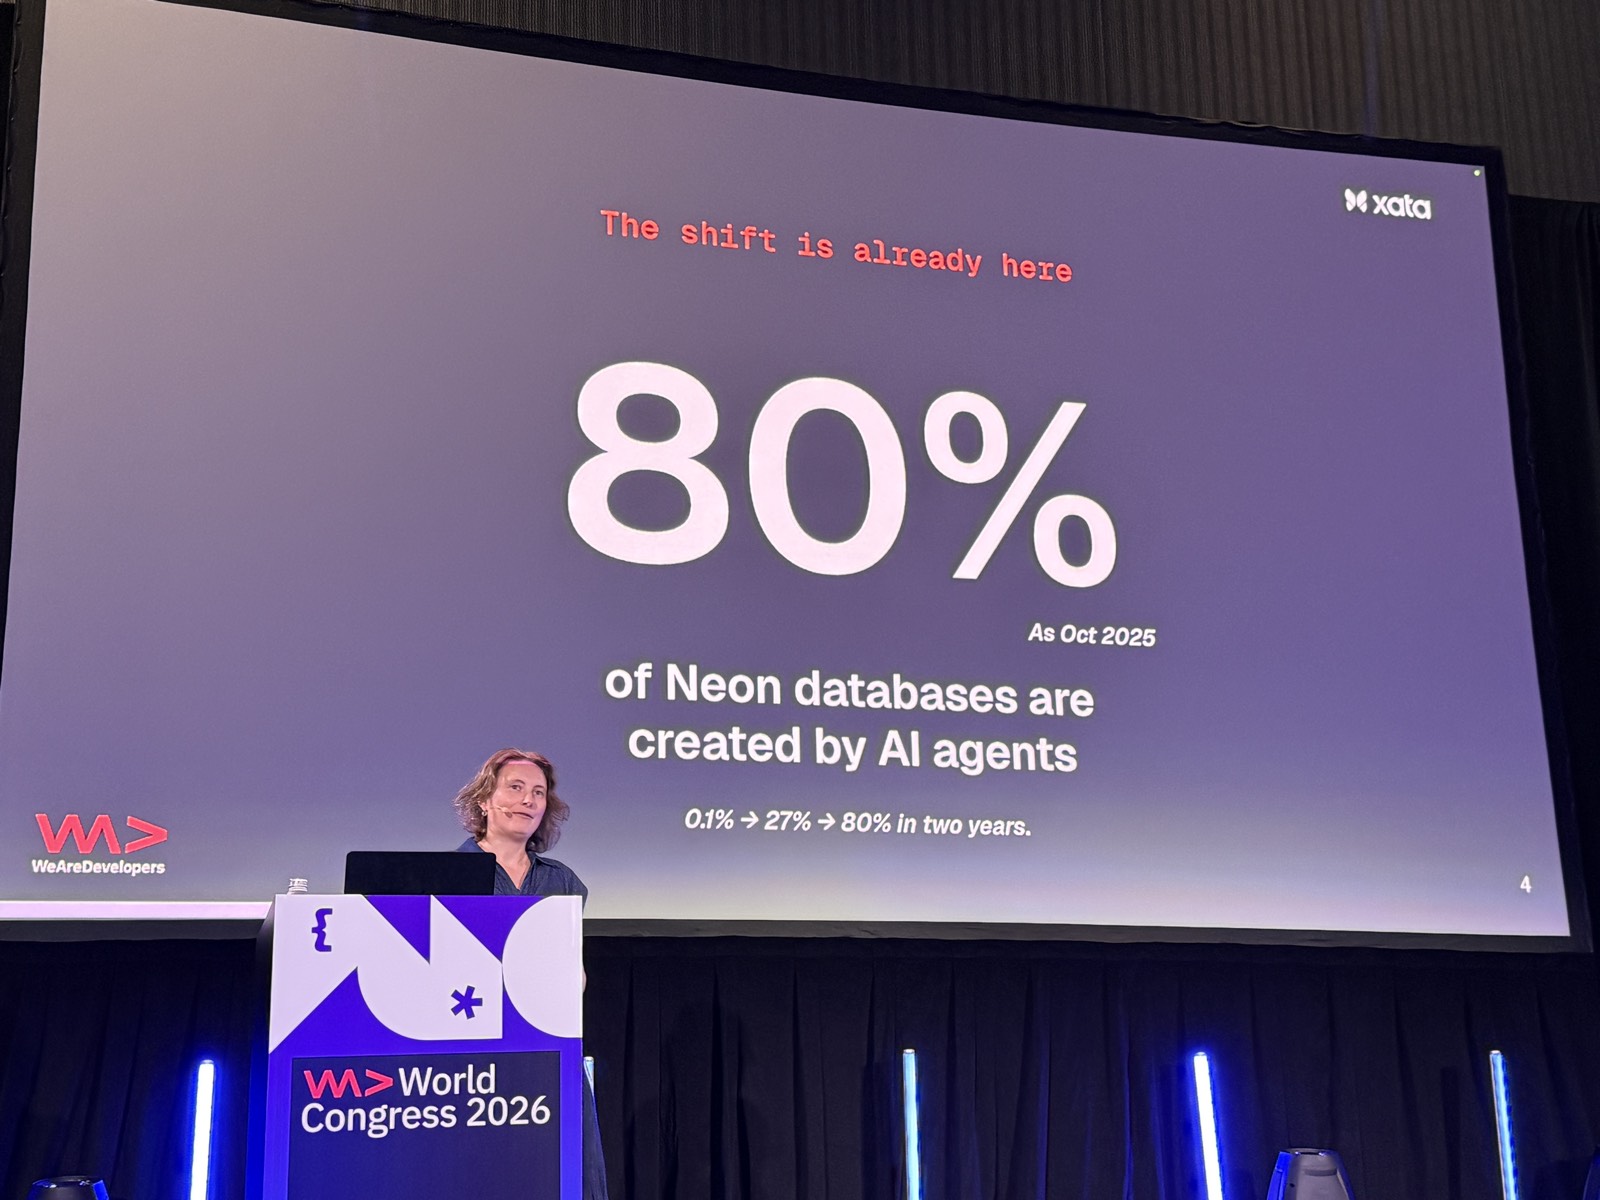
Monica nói rõ: đây không phải chuyện của tương lai, không phải thứ "chúng ta nên chờ đợi". Nó đã xảy ra rồi. Tính tới tháng 10/2025, hơn 80% database được tạo trên Neon (một nền tảng serverless Postgres) là do AI agent tạo, không phải con người. Và con số này đi rất nhanh: từ 0.1% lên 80% chỉ trong hai năm.
Tại sao lại phải bàn chuyện "khác biệt"? Vì agent hành xử rất khác con người khi dùng database:
- Con người query database một cách tuần tự, câu này xong mới tới câu kia. Họ dựng một database rồi giữ nó chạy trong thời gian rất dài.
- Agent chạy nhiều SQL query song song, làm nhiều việc khác nhau cùng lúc, thử nhiều schema change khác nhau rồi bỏ đi. Có cái thành công, có cái không.
- Cách tương tác cũng khác: agent nói chuyện với database qua API, qua MCP, qua skills, không giống một người ngồi trước psql hay một GUI.
Kết luận của chị: agent tạo ra những yêu cầu mới cho database. Trước đây, là người, bạn dựng một database mất vài phút, rồi có một production database chạy suốt nhiều năm mà ai cũng sợ động vào. Giờ thì mọi thứ đang thay đổi, và phần còn lại của talk mô tả chính xác cái gì đã đổi.
3. Ví dụ app hẹn hò cho chó: instant provisioning và scale to zero
Chị bắt đầu bằng một ví dụ. Ngoài kia có rất nhiều AI platform cho phép bạn build một app chỉ bằng cách mô tả nó. Nội bộ Xata làm một bài tập với team marketing: build một dating app cho chó. Monica nói ngay "không phải ý tưởng của tôi, nhưng vui". Họ thử làm trên nhiều platform khác nhau.
Luồng chạy là: một agent tạo app, rồi app đó cần một production database để lưu tất cả những chú chó trong app. Trước đây, bạn có thể chờ một chút cho database chạy lên. Nhưng agent thì không chờ được. Vì vậy trong thế giới agentic, instant provisioning cực kỳ quan trọng: database phải được provision ngay lập tức.
Và quy mô thì rất lớn. Lovable từng nói họ có khoảng 200k project mỗi ngày (TechCrunch, 3/2026). Nếu mỗi project có database riêng, đó có thể là tới 200k database mỗi ngày. Phần lớn trong số đó chỉ là prototype. Hãy tưởng tượng một AI platform sẽ tốn bao nhiêu tiền để chạy chừng đó database mỗi ngày. Nên câu hỏi quan trọng là làm sao chạy chuyện này một cách kinh tế.
Chị đưa ra cách chính: scale to zero. Một prototype không cần có traffic vào database 24 giờ. Khi không ai truy cập database, nó phải scale về 0. Và lần đầu tiên có người truy cập lại, nó phải wake up ngay lập tức, trong khoảng một giây, để dùng tiếp như bình thường.
4. Coding agents build features: mỗi thay đổi code cần một database để test
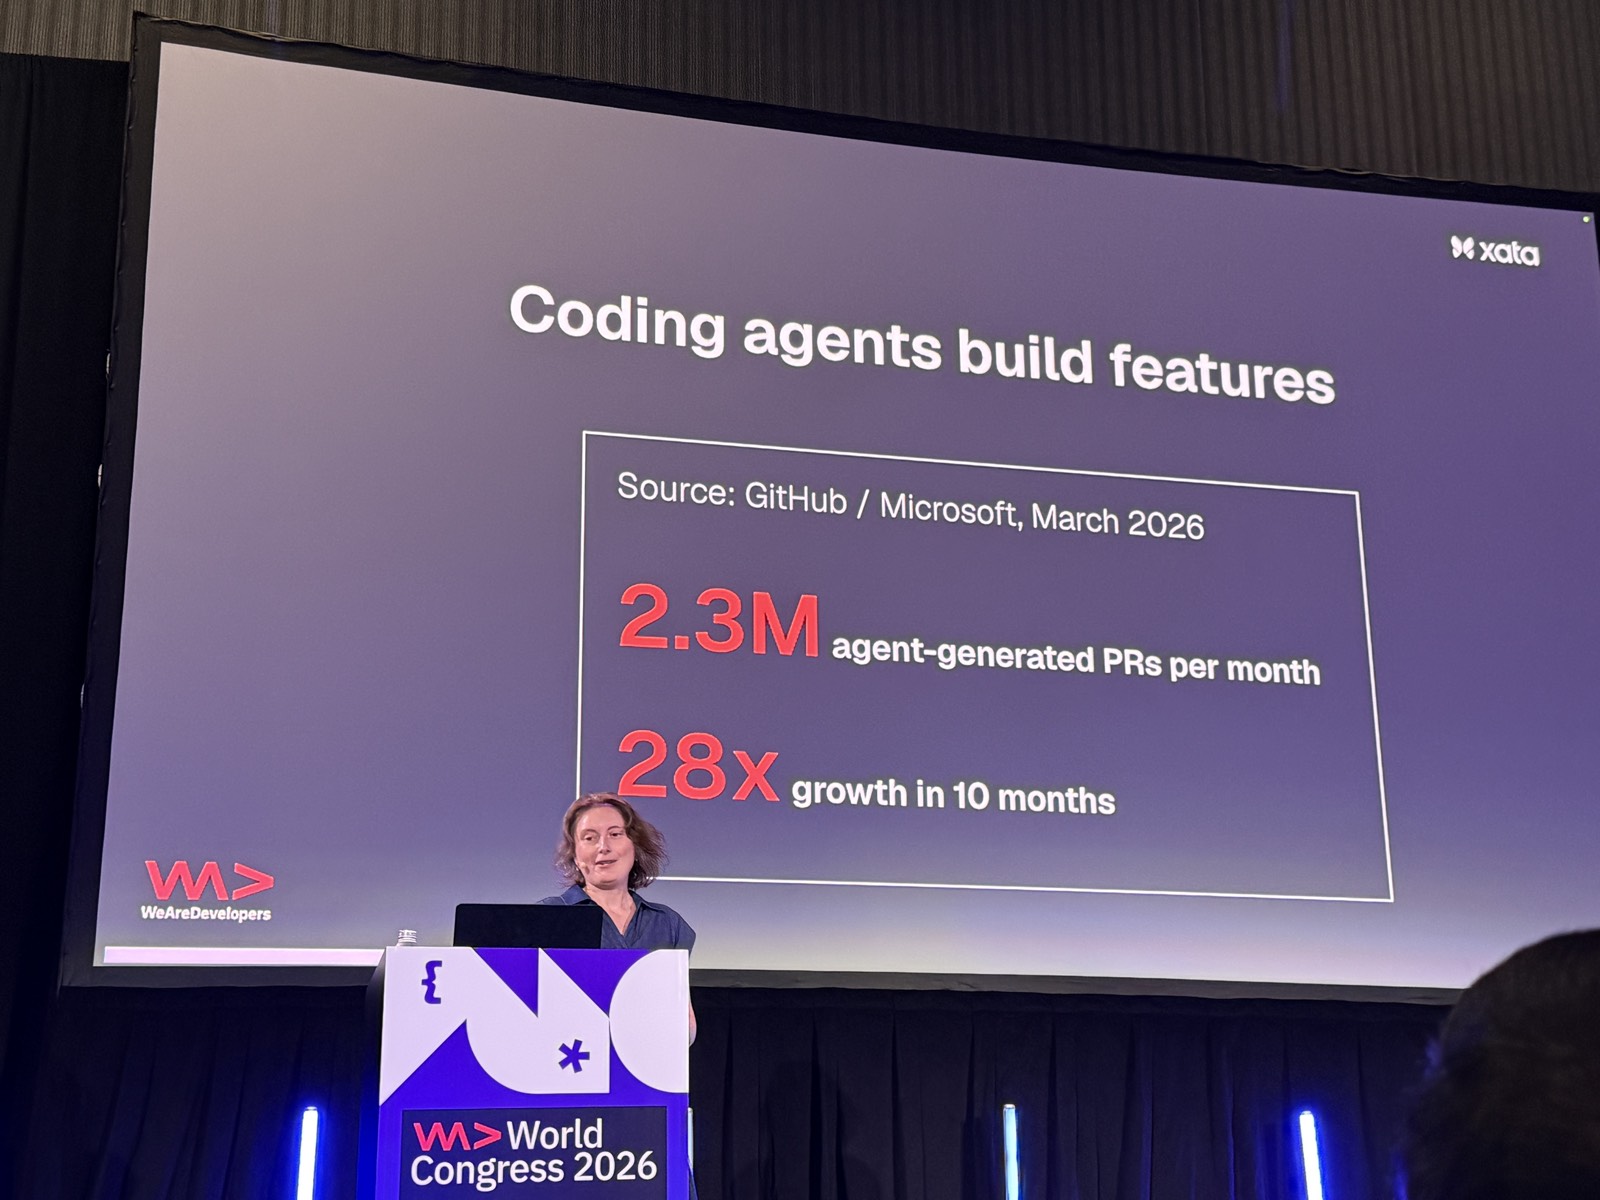
Thay đổi thứ hai: con người không còn tự viết feature nữa, coding agent mới là thứ build feature. Chị dẫn số từ tháng 3/2026: 2.3 triệu PR do agent tạo ra mỗi tháng, tăng khoảng 28 lần chỉ trong 10 tháng. "This is huge."
Từ đó chị đưa ra luận điểm: mỗi code change đều cần một database để test. Rồi chị kéo khán giả về thời trước AI. Nếu bạn còn nhớ: bạn là developer, viết code xong thì hoặc là thử trên Postgres ở máy local, có thể có data, có thể chỉ có hai ba row, và đó đã là "tốt nhất" trước khi merge vào production.
Hoặc, trong kịch bản tốt nhất, công ty bạn có một staging database mà nhiều developer dùng chung. Bạn phải xếp hàng với các developer khác để test thay đổi của mình. Và bạn phải thường xuyên dựng lại staging database, vì khi nhiều người làm nhiều thứ khác nhau cùng lúc (hãy tưởng tượng schema change chồng lên nhau) thì nó bị rối tung. Thế là staging bị tạo lại hết lần này tới lần khác. Monica nói chị đã thấy cảnh này rất nhiều lần.
5. Đưa production cho agent, hay share staging? Cả hai đều hỏng
Còn một lựa chọn nữa: test thay đổi thẳng trên production. Với con người thì đã liều, với agent thì sao? Trong mấy tuần, mấy tháng gần đây có khá nhiều bài viết và tweet kể chuyện: người ta đưa credentials của production cho agent, và rồi "agent của tôi quyết định drop database". Mất production database là chuyện lớn, vì ứng dụng của bạn bị downtime.
Lựa chọn còn lại là cho nhiều agent dùng chung một staging database. Nhưng chị cho rằng cách này không thực tế: agent làm nhiều task song song. Hãy tưởng tượng một task đang làm schema change, trong khi task khác đang chạy trên cùng database đó; chúng sẽ giẫm lên nhau.
Ai cũng biết cách tốt nhất để test là test với dữ liệu giống production thật. Và đó cũng là cách duy nhất để agent làm việc được: chúng phải được phép làm mọi thứ, kể cả làm hỏng dữ liệu, mà không ảnh hưởng tới production. Điều đó kéo theo một thay đổi lớn về bản chất của database: nó chuyển từ "một con server" sang một thứ giống tài nguyên dùng một lần.
Cụ thể: trước đây bạn có một database chạy "for ages". Giờ bạn cần database chỉ trong một khoảng thời gian ngắn: tạo ra cho một task cụ thể, dùng nó, rồi bỏ đi. Monica gọi đây là một thay đổi lớn mà cả ngành đang đối mặt.
6. Database branching và copy-on-write
Để làm được điều trên, cần một khả năng mới gọi là database branching. Nghĩa là bạn có thể branch từ production database, hoặc từ một bản clone của production. Và bạn clone được trong 2, 3 giây, bất kể dữ liệu lớn cỡ nào. Có 10 terabyte dữ liệu trong production và muốn branch? Bạn có ngay một bản copy trong hai ba giây.
Monica kể nhiều người nhìn chị và bảo không thể nào, họ đã thử và không làm được trong 2, 3 giây. Chị đồng ý: đúng là không thể với hạ tầng truyền thống. Nhưng làm được với copy-on-write branching.
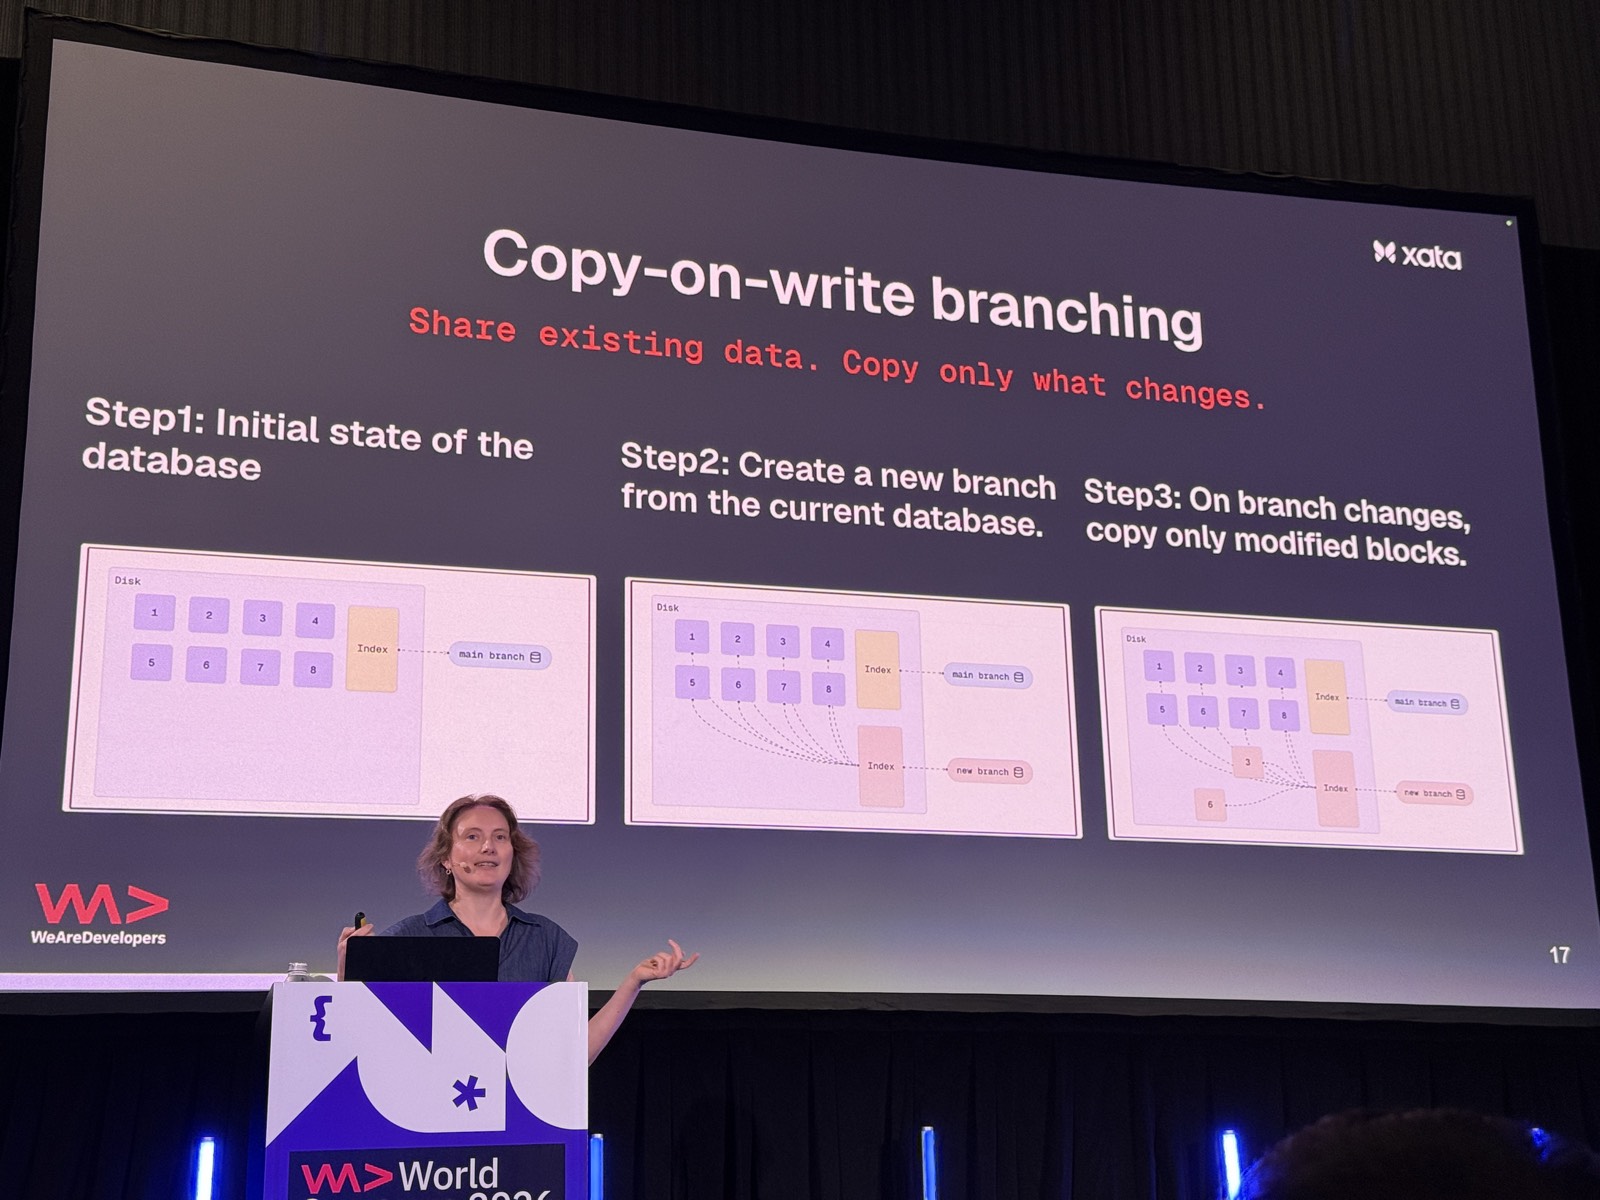
Copy-on-write nghĩa là khi branch, bạn không thực sự copy dữ liệu. Branch có cùng dữ liệu với parent, nhưng dữ liệu không bị nhân đôi. Branch 20 terabyte thì bạn không phải lưu 40 terabyte, bạn vẫn chỉ lưu 20 terabyte.
Cơ chế đi theo ba bước:
- Trạng thái ban đầu: database có một metadata index, giống một tấm bản đồ chỉ ra mỗi block dữ liệu nằm ở đâu trên disk.
- Tạo branch: bạn không copy cả disk. Bạn chỉ tạo thêm một metadata index mới, copy từ index cũ, và mọi block đều được trỏ về đúng chỗ mà main branch đang dùng. (Tới đây slide nhảy nhầm, Monica cười "oops, sorry about that" rồi quay lại.)
- Khi branch thay đổi: ví dụ bạn muốn đổi block 3. Branch sẽ copy block 3 sang chỗ riêng của nó rồi sửa trên bản copy đó. Mọi block không đổi vẫn tiếp tục trỏ về main branch.
7. Chỉ trả tiền compute; tách storage và compute mà vẫn giữ vanilla Postgres
Hệ quả của copy-on-write là tạo branch trở nên rất rẻ và rất hiệu quả. Phần lớn thời gian bạn không trả thêm cho branch. Trong use case thật, người ta hầu như không đổi dữ liệu trên branch, họ chỉ muốn có cùng dữ liệu với main branch. Nên bạn không trả thêm cho storage, bạn chỉ trả cho compute. Mà trong đa số trường hợp, branch chỉ cần trong một khoảng ngắn. Vậy nên tổng chi phí rất thấp.
Làm sao được như vậy? Copy-on-write branching chỉ làm được khi bạn tách storage và compute. Đó là việc Xata đã làm. Và với họ, điều quan trọng là làm được mà không fork Postgres. Họ giữ vanilla Postgres, nhưng vẫn tách storage và compute, và cài đặt copy-on-write branching ở tầng storage. Postgres không hề biết chuyện gì đang diễn ra bên dưới.
8. Quản lý branch: CLI, scratch và branch dùng xong là bỏ
Vậy quản lý branch trong Xata thế nào? Rất đơn giản: có CLI command, ví dụ xata branch create để tạo branch cho một feature. Và có thêm lệnh xata scratch, giống một sandbox: bạn chạy nó là có một branch, tức là một Postgres, để làm đủ thứ trong đó.
Còn một lựa chọn nữa: truyền thẳng một query. Lệnh sẽ tạo branch, chạy query đó trên branch, rồi xóa branch. Như vậy branching trở thành một ephemeral environment thực sự: tạo ra, dùng, rồi vứt đi tùy ý.
xata branch create
xata scratch
xata scratch -x "SELECT ..."
xata scratch psql
Cú pháp đầy đủ theo bài The instant database scratchpad: xata scratch: -x chạy một câu SQL trên branch tạm rồi tự dọn branch khi xong, psql mở một phiên psql trên branch đó. Tài liệu chung về branching: xata.io/docs/core-concepts/branching.
Nhưng rồi chị thừa nhận ngay: nói thật với các bạn, tôi vừa chỉ CLI command để tạo branch, nhưng thực tế người ta không dùng nó như vậy. Ngày nay với agent, mọi thứ đều được tự động hóa. Và chị chuyển sang các use case mà khách hàng của Xata đang chạy.
9. Bốn use case thật: pull request, preview deployment, coding task, train agent
Branch cho mỗi pull request
Coding agent tạo code. Monica nhận xét: giờ viết code rất rẻ, nhưng test nó thì rất khó. Nên luồng là: agent viết code, mở một pull request trên GitHub, rồi GitHub app của Xata tự động tạo một database branch cho PR đó, cho phép bạn test end to end, kể cả dữ liệu. Slide có screenshot trong GitHub cho thấy branch được tạo. Sau khi merge pull request, database branch đó được xóa.
Branch cho deployment preview
Nếu bạn dùng các platform như Vercel, Netlify, họ có sẵn tính năng preview: xem trước bản code mới. Nhưng preview chỉ có code. Với branching, bạn có preview end to end, bao gồm cả dữ liệu. Cách làm rất giống use case trước: slide lại là screenshot một pull request trên GitHub, nơi hệ thống tự tạo database branch cho preview đó.
Branch cho coding task
Ai cũng đang dùng coding agent để viết code. Coding agent có thể tự tạo một branch từ bản gốc để test thay đổi của mình, không cần người đứng giữa.
Branch để train agent
Use case mới hơn mà Xata thấy gần đây: khách hàng muốn train agent của họ. Hạ tầng branching rất tiện cho việc này, vì bạn tạo được một bản copy của production mà không phải chờ lâu. Tạo một branch, rồi test agent của bạn trên đó.
Bài viết liên quan của Xata về các use case này: A thousand Postgres branches for $1 (liệt kê: một Postgres cho mỗi PR và preview environment, agent tạo branch ở mỗi iteration, branch cho mỗi phiên SQL tương tác).
10. Agent scale: một triệu branch mỗi ngày
Nếu tất cả các branch này được tạo tự động, bạn sẽ có rất nhiều branch, và chạm mốc triệu rất dễ. Monica đưa một phép tính đơn giản: bạn có một AI platform với 100k user. Mỗi user tạo 10 agent task mỗi ngày, "mà tôi thấy còn chưa nhiều". Mỗi agent có một branch. Kết quả: một triệu database, hay một triệu branch, mỗi ngày.
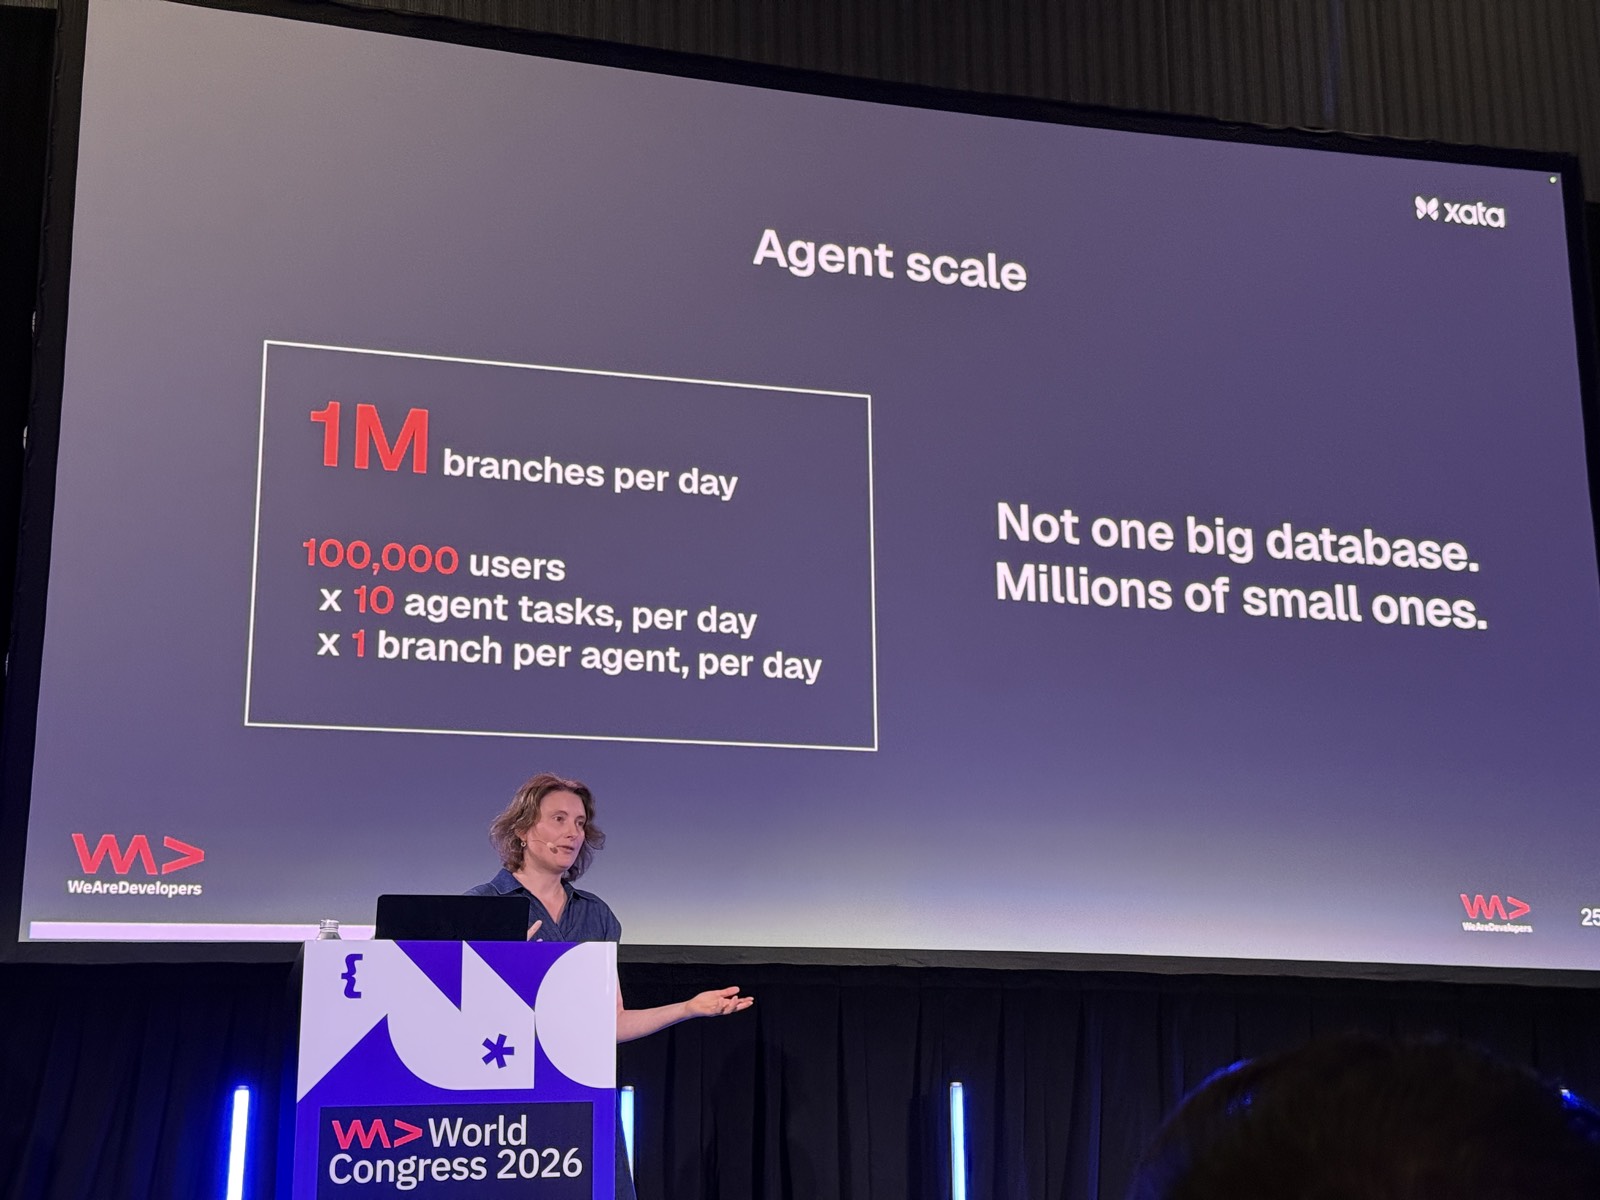
Chị nhấn: ta đang nói tới hàng triệu, một con số thật sự lớn. Trước AI, bạn có một database lớn. Giờ là hàng triệu database nhỏ mà agent chạy. Và như đã nói, chuyện chi phí trở nên sống còn. Thử tưởng tượng bạn trả bao nhiêu cho hạ tầng trên AWS nếu chạy hàng triệu database kiểu truyền thống. Không khả thi.
11. 1,000 branches for $1, và scale to zero cho branch bị quên
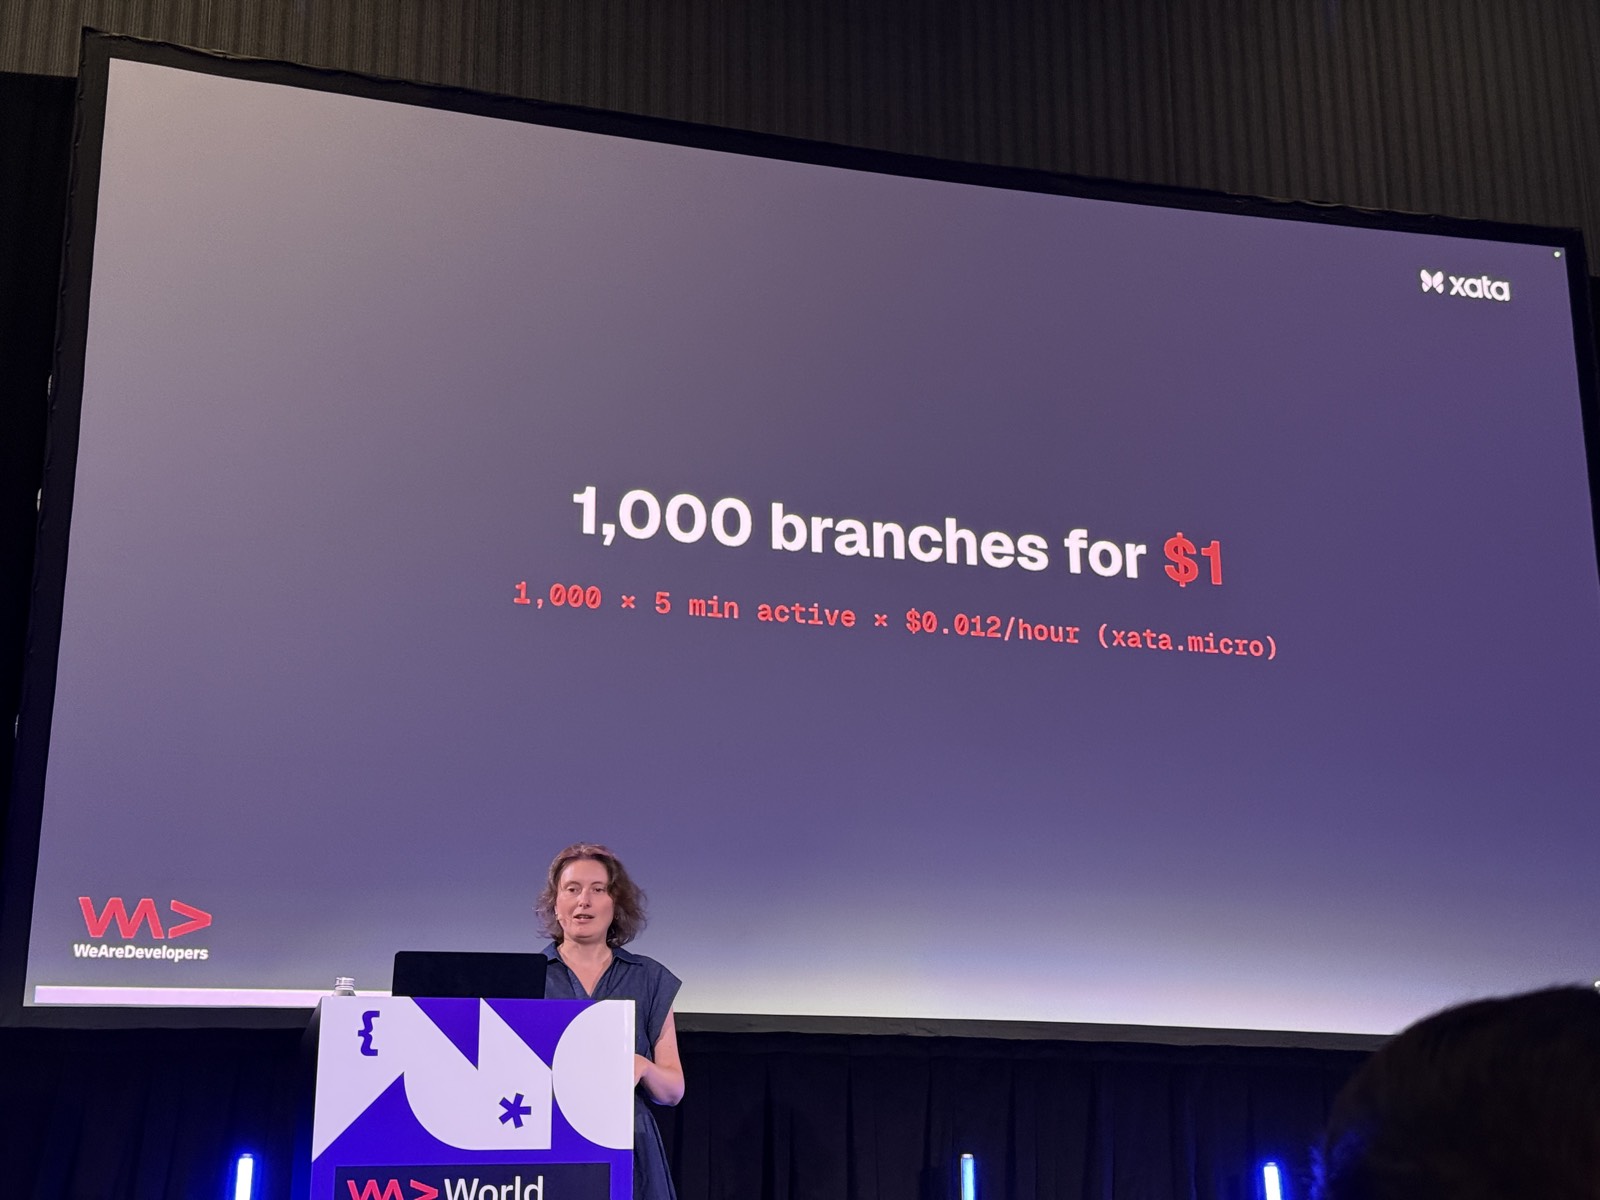
Xata có vài bài blog cho ai tò mò về cách họ chạy một nghìn branch với một đô la. Monica nói trước: đây không phải lời marketing, nó đúng thật. Phần lớn khách hàng của Xata dùng branch và branch chỉ active dưới 10 phút. Nếu bạn có 1,000 branch, mỗi cái chạy 5 phút, trên một micro instance của Xata, thì tổng cộng ra khoảng một đô la.
Nhưng có một vấn đề rất đời: bạn tạo branch rồi quên mất nó. Nên ở đây cũng cần scale to zero, như đã nói ở phần đầu: khi branch idle thì scale về 0, và khi có query đầu tiên thì wake up ngay. Trong Xata có setting để bạn định nghĩa sau bao lâu idle thì branch scale to zero.
12. Dữ liệu thật đi kèm rủi ro privacy: anonymization bằng pgstream
Tới đây, test trên dữ liệu thật nghe rất tuyệt. Nhưng nó đi kèm rủi ro privacy. Có những công ty như bảo hiểm sức khỏe, ngân hàng, giữ dữ liệu cực kỳ nhạy cảm. Mà thật ra công ty nào lưu dữ liệu user cũng có dữ liệu nhạy cảm. Bạn không muốn đưa toàn bộ thông tin đó cho mọi agent, mọi developer. SSN, email và những trường tương tự là thứ phải bảo vệ.
Vậy câu hỏi tiếp theo là: làm sao anonymize dữ liệu trước khi branch? Cách Xata làm: bạn có production Postgres. Trước khi branch, bạn tạo một clone từ production. Xata có một dự án open source tên là pgstream làm đúng việc này: nó tạo clone từ production, và trong lúc tạo clone thì anonymize luôn.
Bạn định nghĩa các transformer, từ đơn giản tới phức tạp, và thậm chí có thể viết Go code để định nghĩa transformer riêng. Ý tưởng là: production Postgres của bạn nằm ở một chỗ an toàn trong môi trường của bạn, còn bản production clone thì có thể nằm ở đâu cũng được, vì nó không chứa thông tin nhạy cảm nào.
Anonymize thế nào mới đúng? Monica nói đây là phần rất thú vị: bạn muốn xóa danh tính nhưng giữ nguyên hình dạng dữ liệu. Nhớ lại use case train agent ở trên: dữ liệu phải còn dùng được. Một email thật được đổi thành một email khác nhưng vẫn trông như email. Tuổi thì phải nằm trong cùng khoảng. Như vậy dữ liệu vẫn dùng được cho cả mục đích training.
Đọc thêm: Xata: Postgres with data branching and PII anonymization.
13. Dùng branching mà không phải dời production
Monica nói Xata hiểu là ai cũng muốn branching. Có những startup rất nhỏ đã tạo hàng nghìn branch, vì họ tạo nhiều pull request, nên tự động có rất nhiều branch. Nhưng bạn không muốn bị ép phải dời production chỉ để dùng được branching.
Nên Xata cho phép, và thậm chí khuyến khích nếu bạn muốn, để production ở đúng chỗ nó đang ở. Ví dụ production của bạn nằm trên RDS: bạn có thể dùng Xata chỉ cho phần branching, thử tính năng branching mà không dời production. Về phía Xata, 50% khách hàng làm cả hai (chuyển production sang Xata và dùng Xata cho branching), 50% còn lại chỉ dùng Xata cho branching.
Cách làm: production database của bạn ở RDS. Bạn tạo một production clone và giữ nó sync với production bằng chính dự án open source đã nhắc, pgstream, thứ cũng làm luôn phần anonymization. Khi đã có production clone được sync trên Xata, từ đó bạn tạo branch dễ dàng cho mọi use case.
Chị kết thúc phần trình bày: "Tôi không nói nhiều về Xata, nhưng nếu muốn tìm hiểu thêm thì đây là xata.io", kèm screenshot trang web, rồi cảm ơn khán giả và mở phần hỏi đáp, dù chị không chắc còn đủ thời gian. Trang sản phẩm: xata.io, trang riêng về branching: xata.io/postgres-branching.
14. Hỏi đáp: đổi schema, template database, CI, on-prem, MySQL
Có đổi được cấu trúc database trên branch không?
Một người hỏi: có thể thay đổi database structure không? Monica chưa nghe rõ, hỏi lại "ý bạn là database structure gì". Người hỏi giải thích: thêm field, thêm table, tức là schema, trên branch. Câu trả lời: có. Branch về bản chất là một database khác, một Postgres đầy đủ. Bạn đổi được dữ liệu, và đổi được schema, trên branch mà không ảnh hưởng parent.
Thay template database cho unit test và integration test?
Người hỏi thứ hai (lúc đầu phòng không có micro, Monica bảo "tôi không nghe được", phải nói to lại) kể team họ chạy unit test, integration test và các loại test khác trên Postgres. Để tăng tốc, họ dùng template database của Postgres: giữ một "golden state", copy ra rồi chạy test song song, cô lập và nhanh. Dùng Xata với copy-on-write cho use case đó có hợp lý không?
Monica: chắc chắn rồi. Thậm chí còn rẻ hơn khi làm theo cách này. Dùng cho unit test, integration test chính là mục đích của nó.
Chạy local, trong CI, hay on-prem?
Người đó hỏi tiếp: có chạy được ở local, ví dụ ngay trong CI không? Monica trả lời Xata có lựa chọn bring your own cloud, và cũng chạy được on-prem. Đó chỉ là thêm một cách triển khai.
Có hỗ trợ MySQL không?
Hiện tại chỉ chạy cho Postgres. Monica hỏi lại "bạn là MySQL user à?" rồi khen đó là một câu hỏi hay.
Khác gì một giải pháp branching khác?
Câu hỏi tiếp theo so sánh với một giải pháp branching khác. Monica trả lời: khác biệt không nằm ở tính năng mà ở kiến trúc. Giải pháp kia phải can thiệp vào Postgres, và điều đó kéo theo hệ quả: performance bị ảnh hưởng, và họ có giới hạn 25 branch. Xata thì không chạm vào PostgreSQL. Họ dùng vanilla Postgres và cài đặt mọi thứ ở tầng storage bên dưới; Postgres không biết rằng mọi việc đang xảy ra ở tầng storage. Nhờ vậy performance tốt hơn và chạy hàng nghìn branch dễ dàng. Chị nói Xata xây platform cho quy mô hàng triệu, vì đó là thứ họ thấy ở khách hàng, và làm được là nhờ kiến trúc này.
Version và extension
Vì là Postgres nguyên bản, bạn dùng được các version Postgres khác nhau, và dùng được bất kỳ extension nào. Không có gì bị ảnh hưởng; Xata không phải sửa extension để chúng chạy được. Hết giờ, Monica mời người còn câu hỏi lên gần sân khấu để nói chuyện tiếp.
Nguồn và link
- Trang session chính thức: Databases in the Agent Era, WeAreDevelopers World Congress NA 2026
- Xata: xata.io · Instant Postgres branching · Docs: Branching · github.com/xataio
- Xata blog: A thousand Postgres branches for $1 · Open source Postgres platform with CoW branching · Postgres for agent scale, open source · xata scratch · Data branching and PII anonymization · Branch Postgres without a migration
- pgstream (clone, sync, anonymize): github.com/xataio/pgstream
- Stack Overflow Developer Survey 2025: survey.stackoverflow.co/2025/technology
- Neon và agent: Databricks blog về thương vụ Neon
- PostgreSQL: About · Template databases
- Lovable, 200k project mỗi ngày: TechCrunch, "Vibe-coding startup Lovable is on the hunt for acquisitions", 3/2026
- Chưa tìm được nguồn chính chủ: con số "2.3M agent-generated PRs per month, 28x growth" (slide ghi GitHub / Microsoft, March 2026).
Related talks
Tools, Sandboxes, and the Plumbing of Agentic Development
Oleg Šelajev · Docker · 34 min
Dựng một coding factory để thoát khỏi vai điều phối toàn thời gian: mỗi agent một role, CLI và model riêng, chạy trong sandbox, dùng kits và skills.
Acquired Live Interview: Amjad Masad (Co-founder & CEO, Replit)
Amjad Masad · Replit · 27 min
Amjad Masad kể hành trình Replit: từ Python trong browser tới Replit Agent, doanh thu 2 lên 10 triệu, và vì sao switching costs nằm ở rails quản lý agent.
Building an AI-Native Development Workflow
Vanessa Minik · GitHub · 20 min
AI native khác AI embedded: nghĩ lại SDLC quanh một workforce nhiều agent, context engineering, và việc cần làm ngay sáng thứ Hai.