From Model Selection to Smart Routing: How to Use the Right LLM for Every Task
Chọn LLM theo cost per task chứ không theo benchmark: build eval set với MLflow, govern qua AI gateway với budget và traffic split, rồi để smart routing tự chọn model.
1. Mở đầu: "model nào tốt nhất cho tôi?" và ba trục intelligence, speed, cost
Người dẫn chương trình của Stage 4 mở màn bằng một câu hỏi mà ai làm AI cũng từng tự hỏi: model nào là model tốt nhất cho tôi? Anh nói thẳng, tiếc là câu hỏi này không đơn giản như mình tưởng. Hỏi một engineer thì câu trả lời quen thuộc sẽ là "it depends", tuỳ task. Có model giỏi nhất về reasoning, có model tốt nhất về latency, và có model thứ ba hợp nhất về cost efficiency. Sau đó anh giới thiệu speaker: Viktoria Semaan, Principal Technical Evangelist ở Databricks, hơn 15 năm kinh nghiệm qua các mảng AI, data engineering, cloud architecture, trong đó có thời gian làm việc ở AWS. Hôm nay chị sẽ đưa khán giả đi từ việc đơn giản là chọn một model, tới việc route mỗi task tới đúng model của nó.
Viktoria nói chị rất hào hứng với chủ đề này, vì chúng ta đang sống trong một thời điểm rất đặc biệt: tuần nào cũng có model mới ra, và có rất nhiều hype quanh chuyện nên dùng model nào. Nên hôm nay chị muốn đưa ra một cách làm có tính lập trình (programmatic) để đánh giá model nào đáng cân nhắc, thay vì "vibe checking", tức là thử vài câu rồi chọn theo cảm giác. Nhưng chị cũng thừa nhận một vấn đề khác: đôi khi có quá nhiều loại task khác nhau, và mình đơn giản là không có thời gian để evaluate từng loại. Mình chỉ cần làm cho xong. Với những trường hợp đó, chị sẽ nói về cách dùng smart routing, intelligent routing, để hệ thống tự đưa ra lựa chọn thay mình.
Chị bắt đầu bằng cách nhìn vào một đợt ra mắt model điển hình. Khi một model mới được công bố, các công ty làm model, ví dụ OpenAI, thường nhấn mạnh intelligence. Mình nghe rất nhiều về benchmark, về việc model giỏi reasoning tới mức nào. Chị lấy ví dụ Fable 5.1 vừa ra: intelligence score khoảng 53. Còn nếu nhìn sang một model rẻ hơn, kém thông minh hơn, như Gemini, điểm là 41. Nhưng người ta thường quên mất speed. Ở đây, nếu mình chịu hy sinh khoảng 20% intelligence, mình được lại khoảng 500%, tức là nhanh gấp năm lần.
Và quan trọng hơn cả là cost, cụ thể là cost per task (chi phí cho mỗi task), chứ không phải giá per token. Với Fable, mỗi task tốn hơn $7, trong khi với Gemini chỉ khoảng $1 mỗi task. Chị bảo hãy nghĩ tới điều này: mình đang dùng AI cho ngày càng nhiều việc. Nếu mình cứ tiếp tục đổ mọi thứ vào những model proprietary đắt tiền này, rất có thể mình sẽ tự "automate ourselves out of business": tiền chi cho AI usage lớn tới mức doanh thu và thu nhập không còn đủ bù. Chị nói Databricks thực sự đang thấy hiện tượng đó: khi lên scale, AI trở nên không thể quản lý nổi (AI is becoming unmanageable).
2. AI không còn quản lý nổi khi scale: model mới mỗi 5 ngày, AI spend tăng dựng đứng
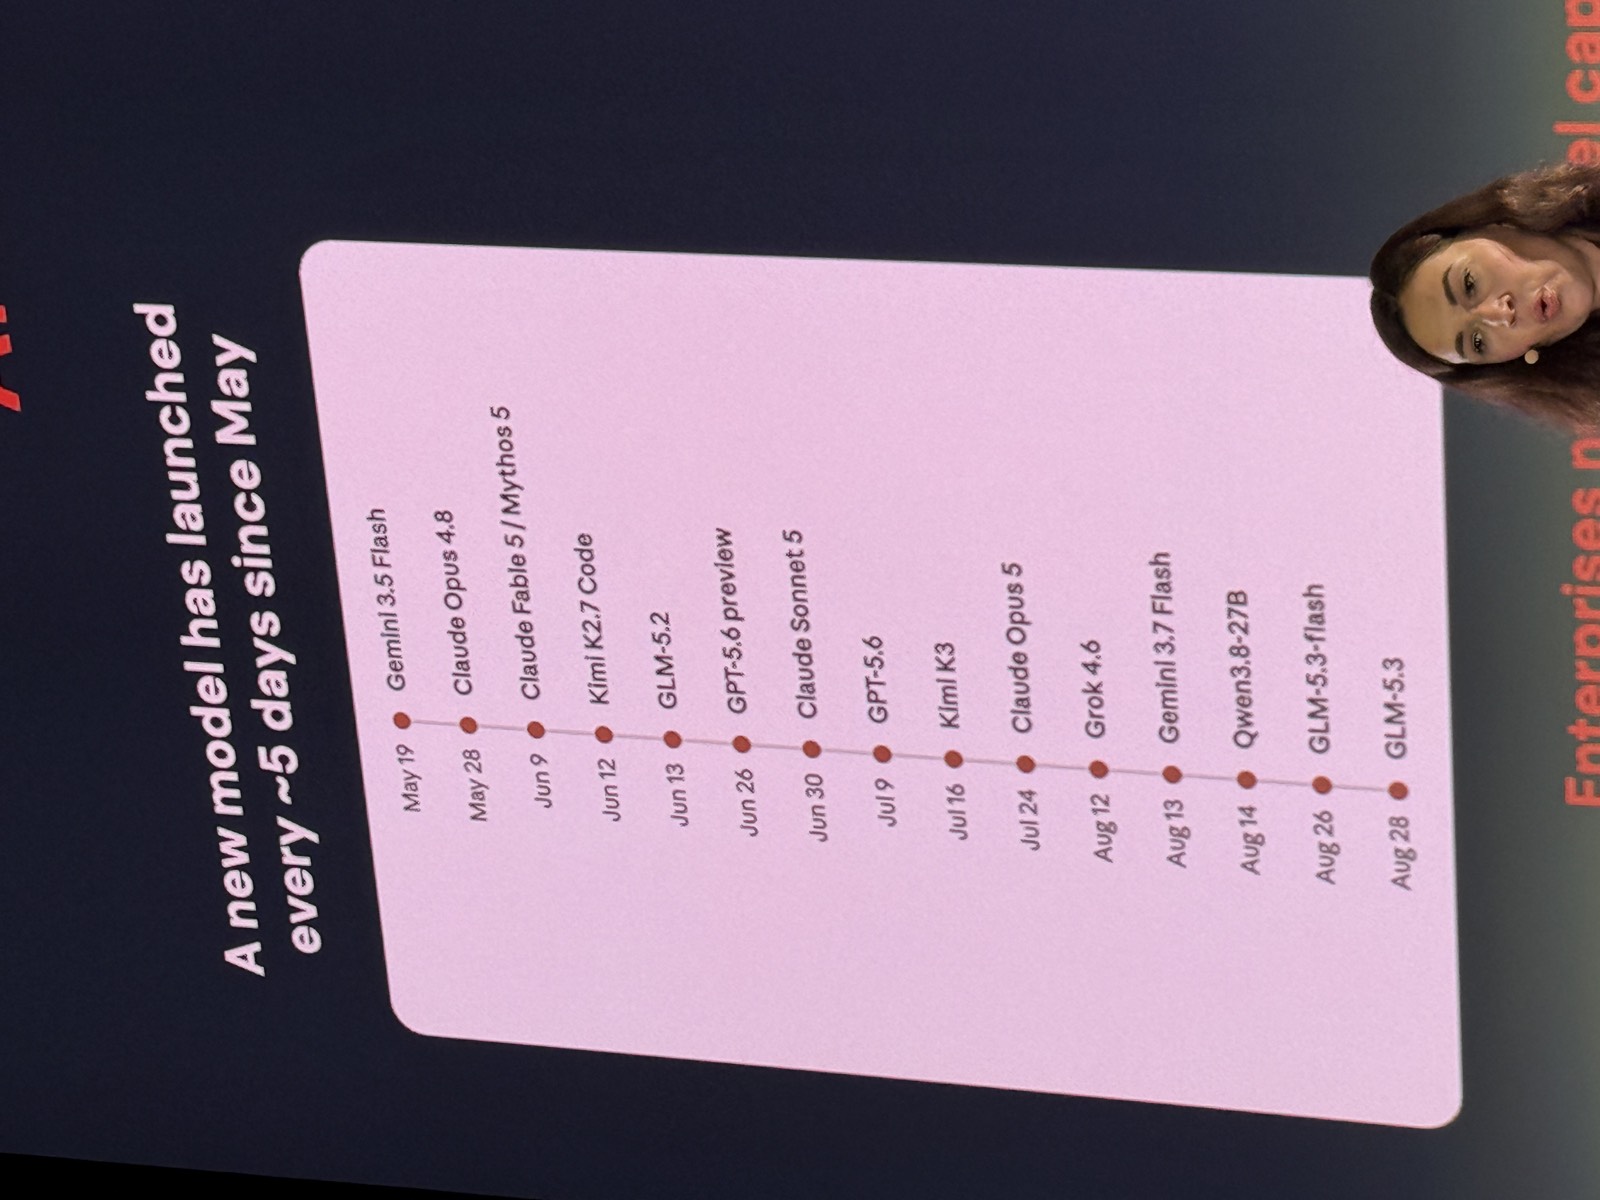
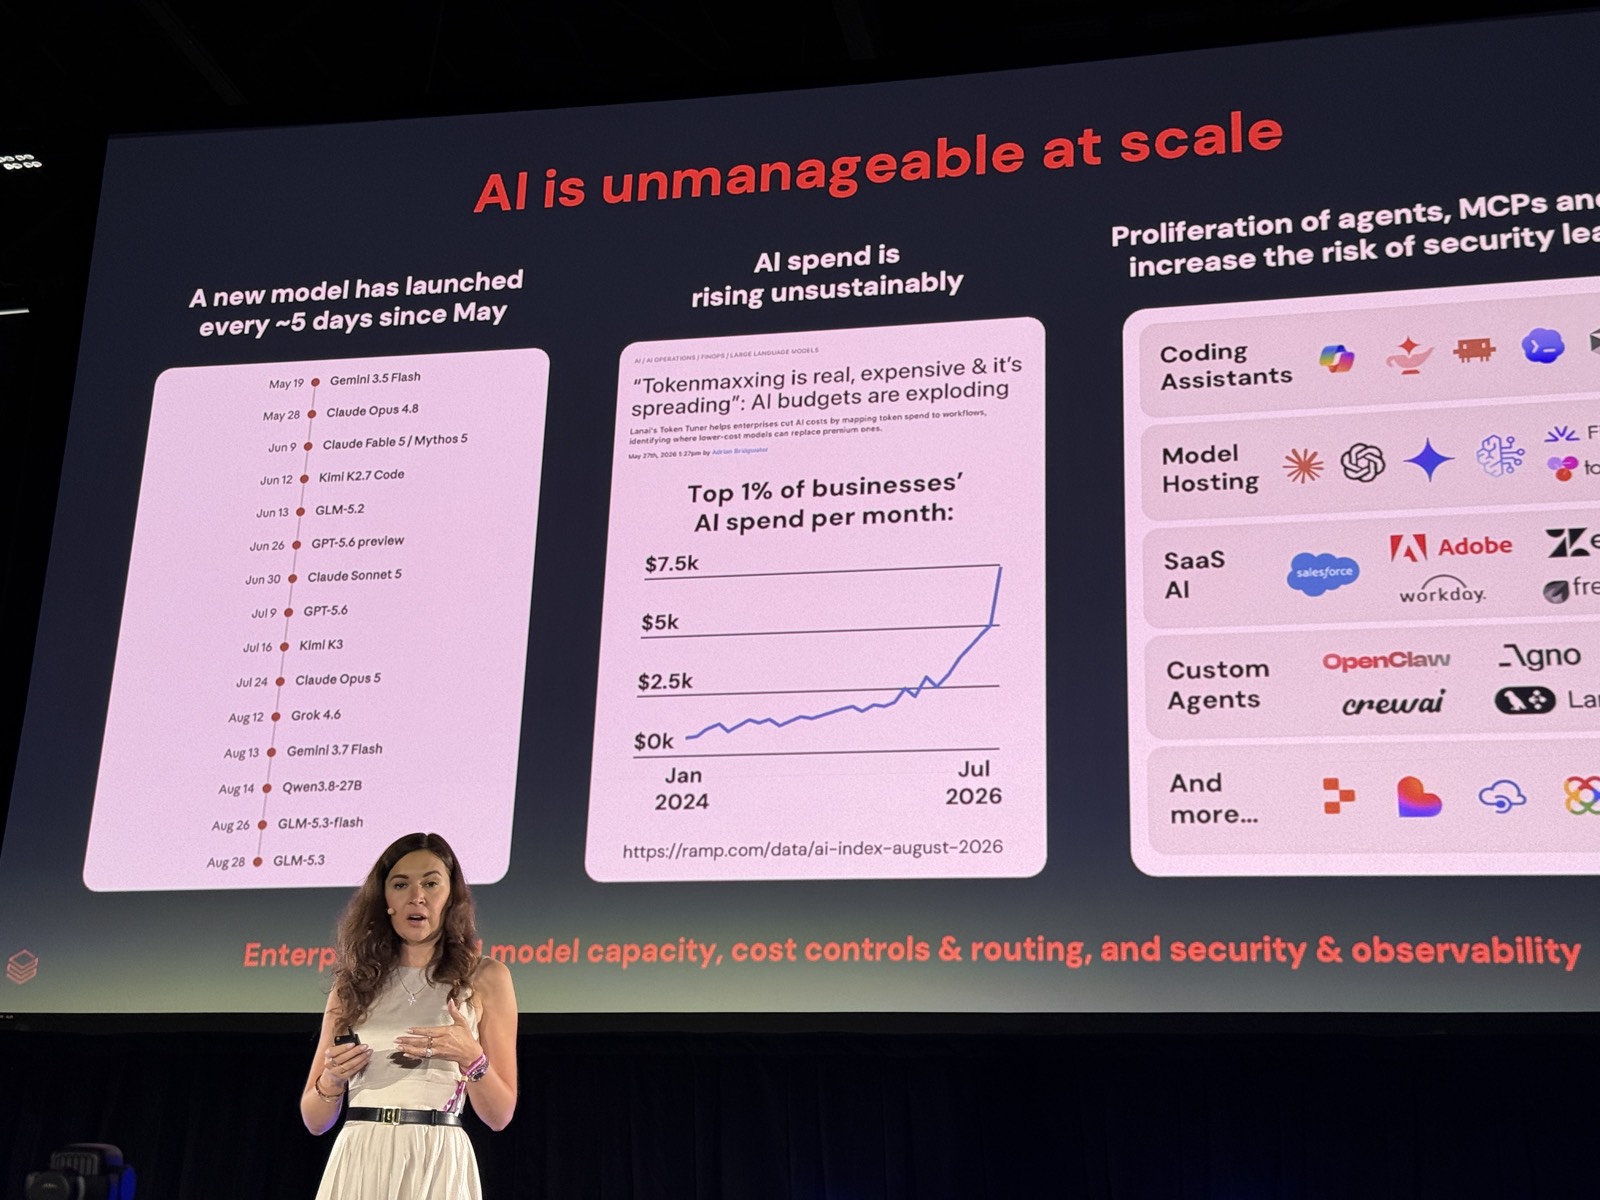
Chị chiếu slide "AI is unmanageable at scale" gồm ba cột. Cột đầu là một timeline: kể từ tháng Năm, cứ khoảng năm ngày lại có một model mới ra mắt. Mỗi lần như vậy là một đợt hype, là lời mời "hãy bỏ cái cũ đi và thử model của chúng tôi, model của chúng tôi tốt nhất, và bạn có thể automate cái này, cái này, cái này".
Cột thứ hai nói về chi phí: chị kể rằng nhóm 1% doanh nghiệp đứng đầu đang automate mọi thứ họ có thể automate, nên AI usage của họ tăng theo cấp số nhân. Trên slide là một đường AI spend gần như thẳng đứng, cứ thế đi lên. Cột thứ ba cho thấy vấn đề không chỉ nằm ở bản thân các model. Mình dùng coding agents. Mọi SaaS "under the sun" giờ đều gắn AI engine vào phần mềm của họ. Rồi mình còn tự build custom agents. Kết quả là trong một tổ chức, rất khó biết mình đang tiêu bao nhiêu tiền cho AI, chỗ nào tiền đó tạo ra ROI, và chỗ nào mình đang lỗ.
Chị kể thêm một quan sát cá nhân với giọng hơi mỉa: có những task chị thấy người ta dùng hẳn model Fable để làm, và chị chỉ muốn hỏi lại "bạn có hiểu là thuê người làm việc này còn rẻ hơn nhiều không?". Chị không chắc những việc đó có thật sự cần AI hay không. Từ đó chị nêu mục tiêu của talk: làm sao đo được return on investment và chọn đúng model.
3. Lộ trình talk và bức tranh model trade-offs: open-weight bắt kịp sau ba tháng
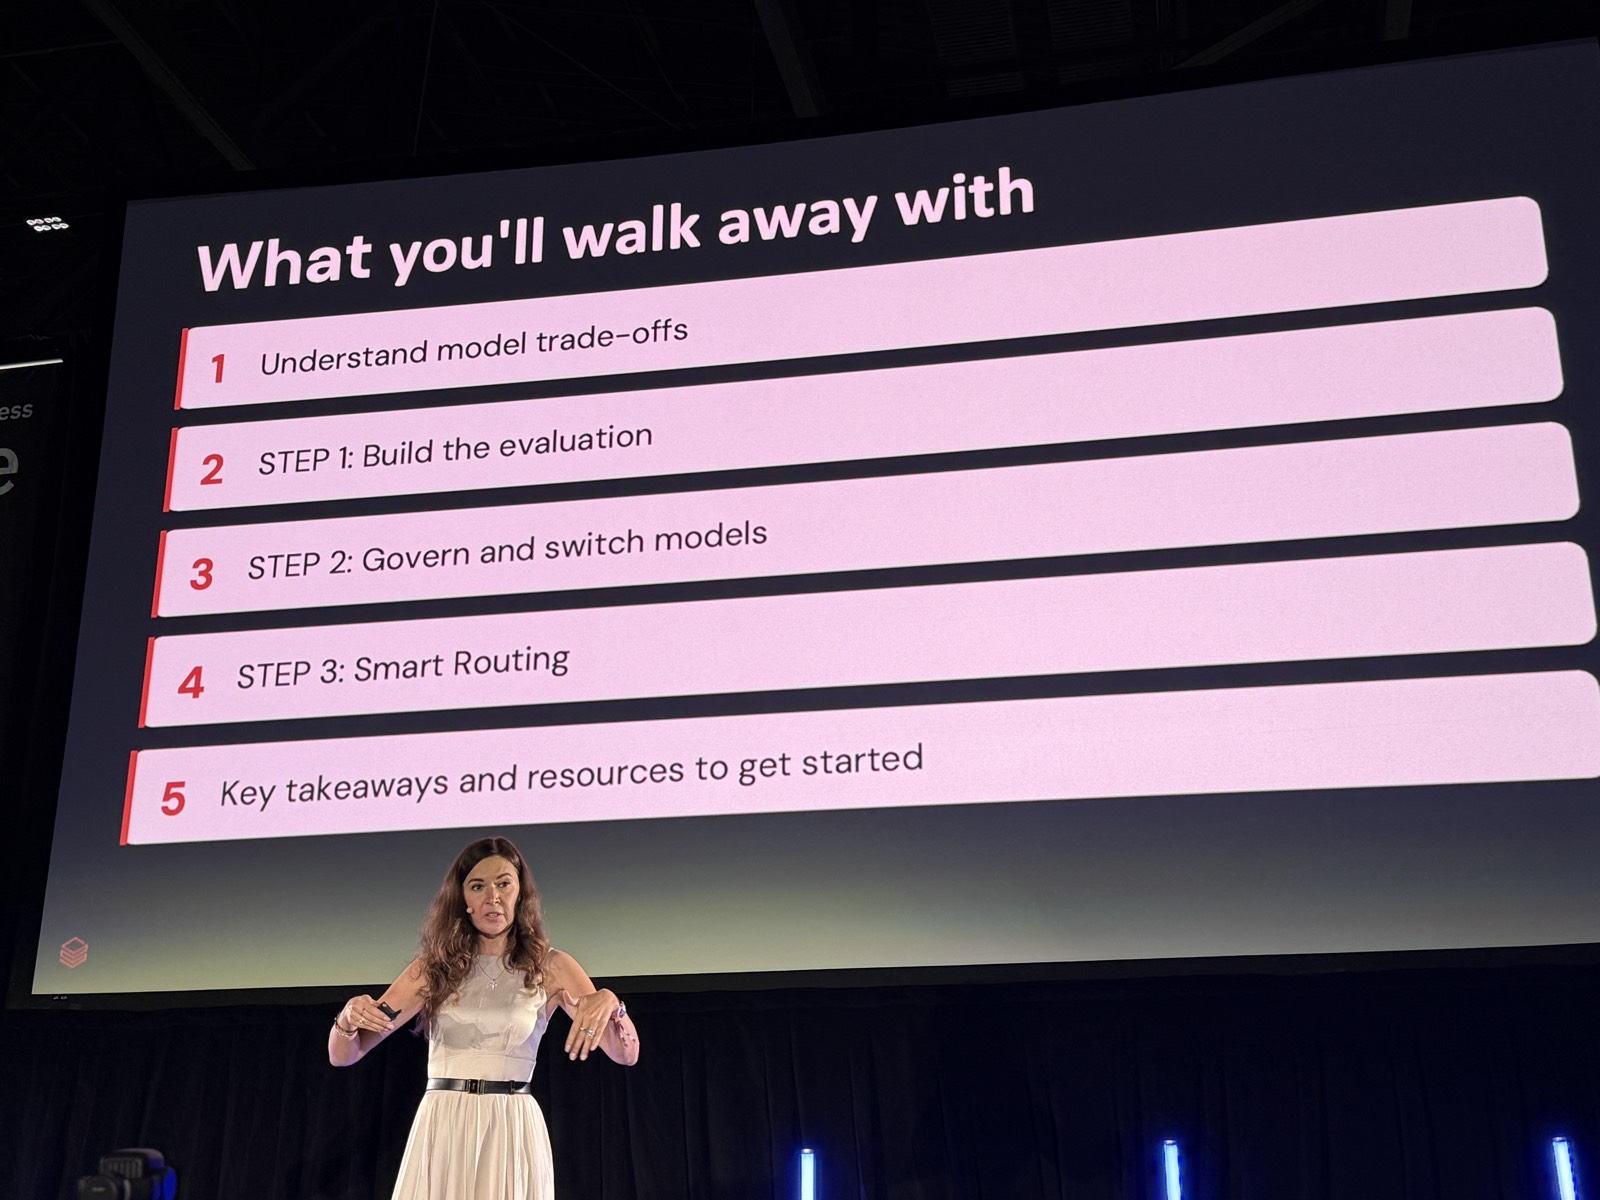
Viktoria đưa ra lộ trình năm phần. Đầu tiên là model trade-offs. Sau đó là cách build evaluation set, để mỗi khi có model mới "drop" ra, mình có thể evaluate các model với nhau trên cùng một bộ dữ liệu. Tiếp theo là cách govern các model: chia traffic, đặt budget. Cuối cùng là smart routing. Chị lưu ý trước rằng nhiều tính năng smart routing vẫn đang ở giai đoạn beta, nhưng chị sẽ cho xem bản preview qua demo.
Phần model trade-offs bắt đầu bằng một biểu đồ open-weight model chia theo quốc gia. Điều thú vị, theo chị, là hiện nay Trung Quốc đang dẫn đầu về open-weight models: đường màu đỏ là Trung Quốc, đường màu đen là Mỹ. Và khoảng cách để open-weight models bắt kịp proprietary models hiện chỉ còn khoảng ba tháng. Ba tháng sau khi một model đóng ra, đã có open-weight model đuổi kịp.
Chị cũng nói kiểu "one-stop shop" đã lỗi thời, tức là kiểu "tôi build mọi thứ với OpenAI" hoặc "tôi build mọi thứ với Anthropic". Theo số liệu chị đưa, 81% doanh nghiệp đã dùng ít nhất năm model trong production. Và trung bình, open-weight model rẻ hơn khoảng 78% so với dùng một proprietary model tương đương.
4. Fine-tune open-weight model, và ba con đường: lock-in, chắp vá, hay một AI gateway
Chị kể nhiều khách hàng của Databricks là những công ty khá nổi tiếng, như Cursor, Perplexity, Shopify, Glean. Điều họ làm là lấy một open-weight model rồi tối ưu nó cho đúng task cụ thể bằng fine-tuning. Cách này giảm cost đáng kể mà vẫn giữ được quality score cao. Ví dụ Cursor: theo chị nhớ, ban đầu họ dùng OpenAI, sau đó lấy model Kimi, fine-tune nó, tạo ra model Composer, và đạt mức giảm 86% cost per task cho các AI agent của họ.
Vậy bắt đầu từ đâu? Chị nói có ba cách.
Cách thứ nhất: gắn chặt với một model provider, build theo kiểu verticalize. Cách này tất nhiên có nhiều nhược điểm. Giả sử bạn là "Anthropic shop", dùng Claude, dùng rất nhiều model của Anthropic. Rồi một ngày OpenAI ra một thứ rất hay với Codex, bạn không dùng được nữa. Nên đây có lẽ không phải giải pháp tốt nhất.
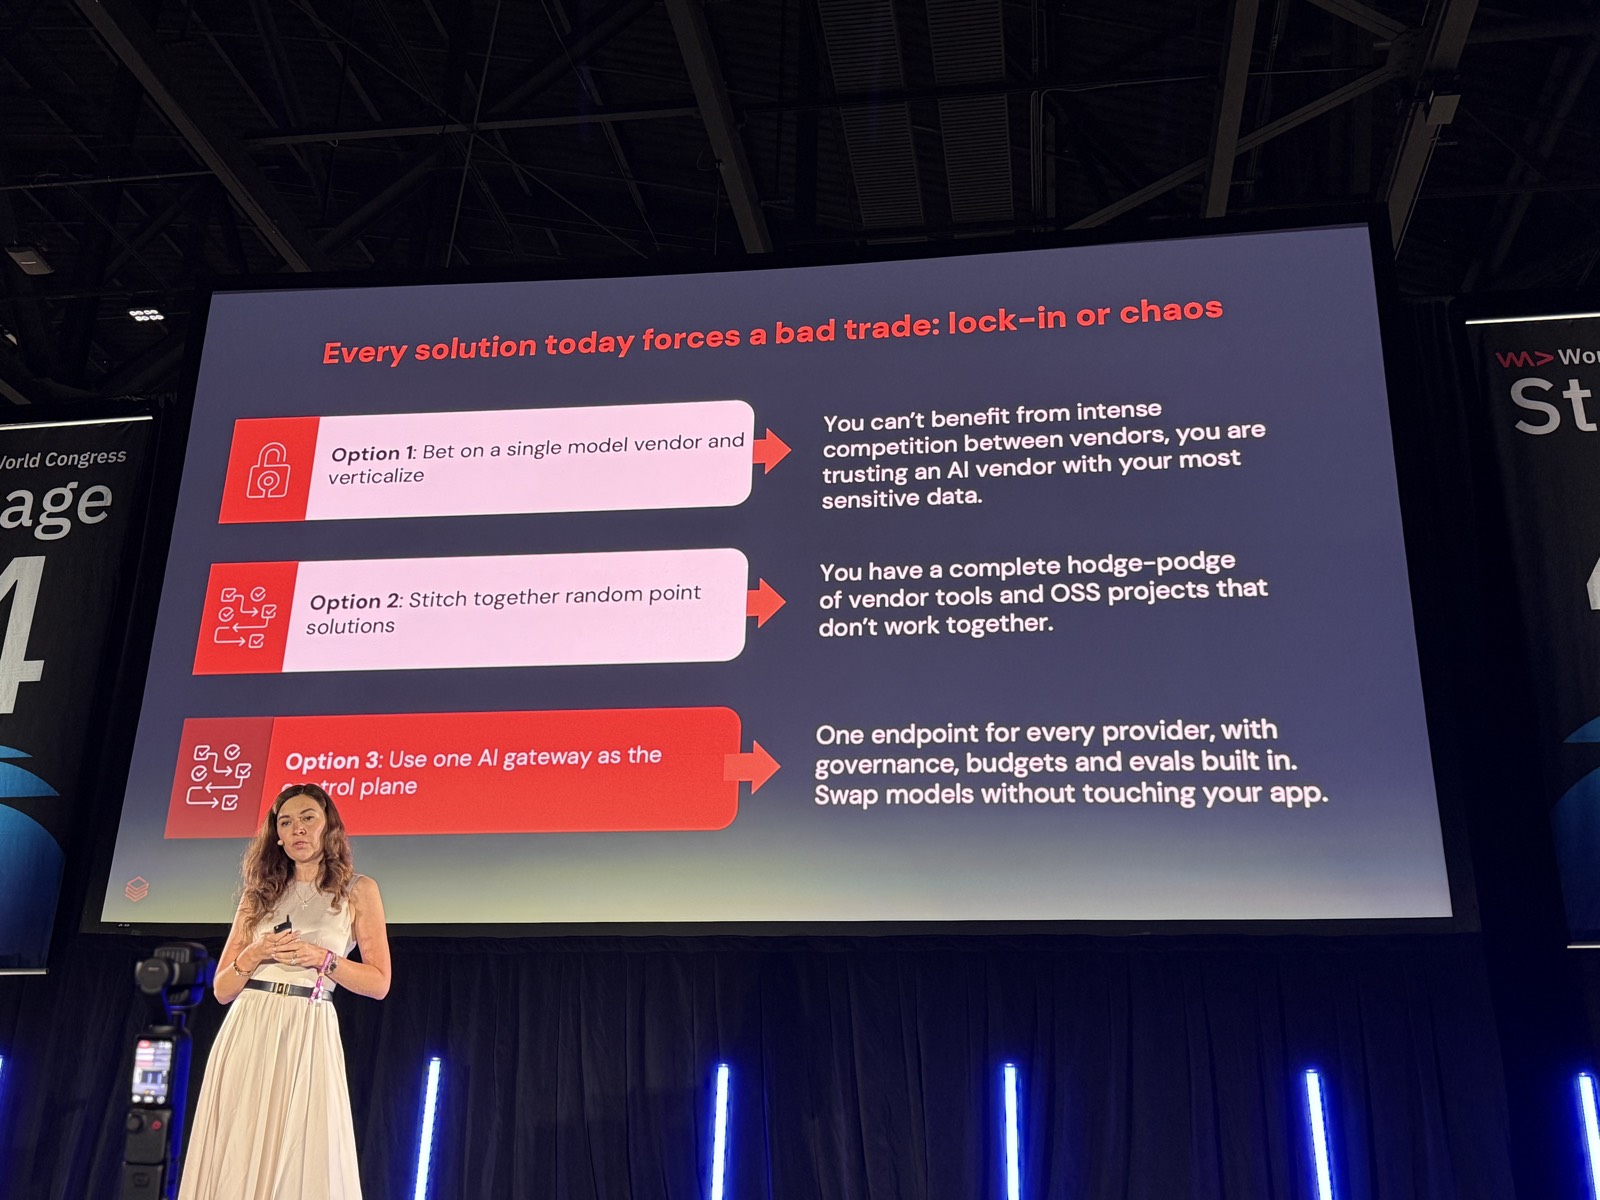
Cách thứ hai mà chị thấy nhiều công ty đang làm: tự build và tự khâu nối rất nhiều thứ custom. Họ có thể dùng một AI gateway, ví dụ một AI gateway open source, rồi tự build harness riêng. Thách thức là lĩnh vực này thay đổi quá nhanh, nên việc maintain các giải pháp custom và khâu chúng lại với nhau trở nên rất khó.
Cách thứ ba là điều chị muốn nói trong talk: cách Databricks giải bài toán này cho khách hàng, dùng Unity AI Gateway cùng với Unity Catalog, và Omnigent cho phần meta-harness.
5. AI Gateway là gì: một endpoint, tách app khỏi model, một control plane cho mọi chi phí
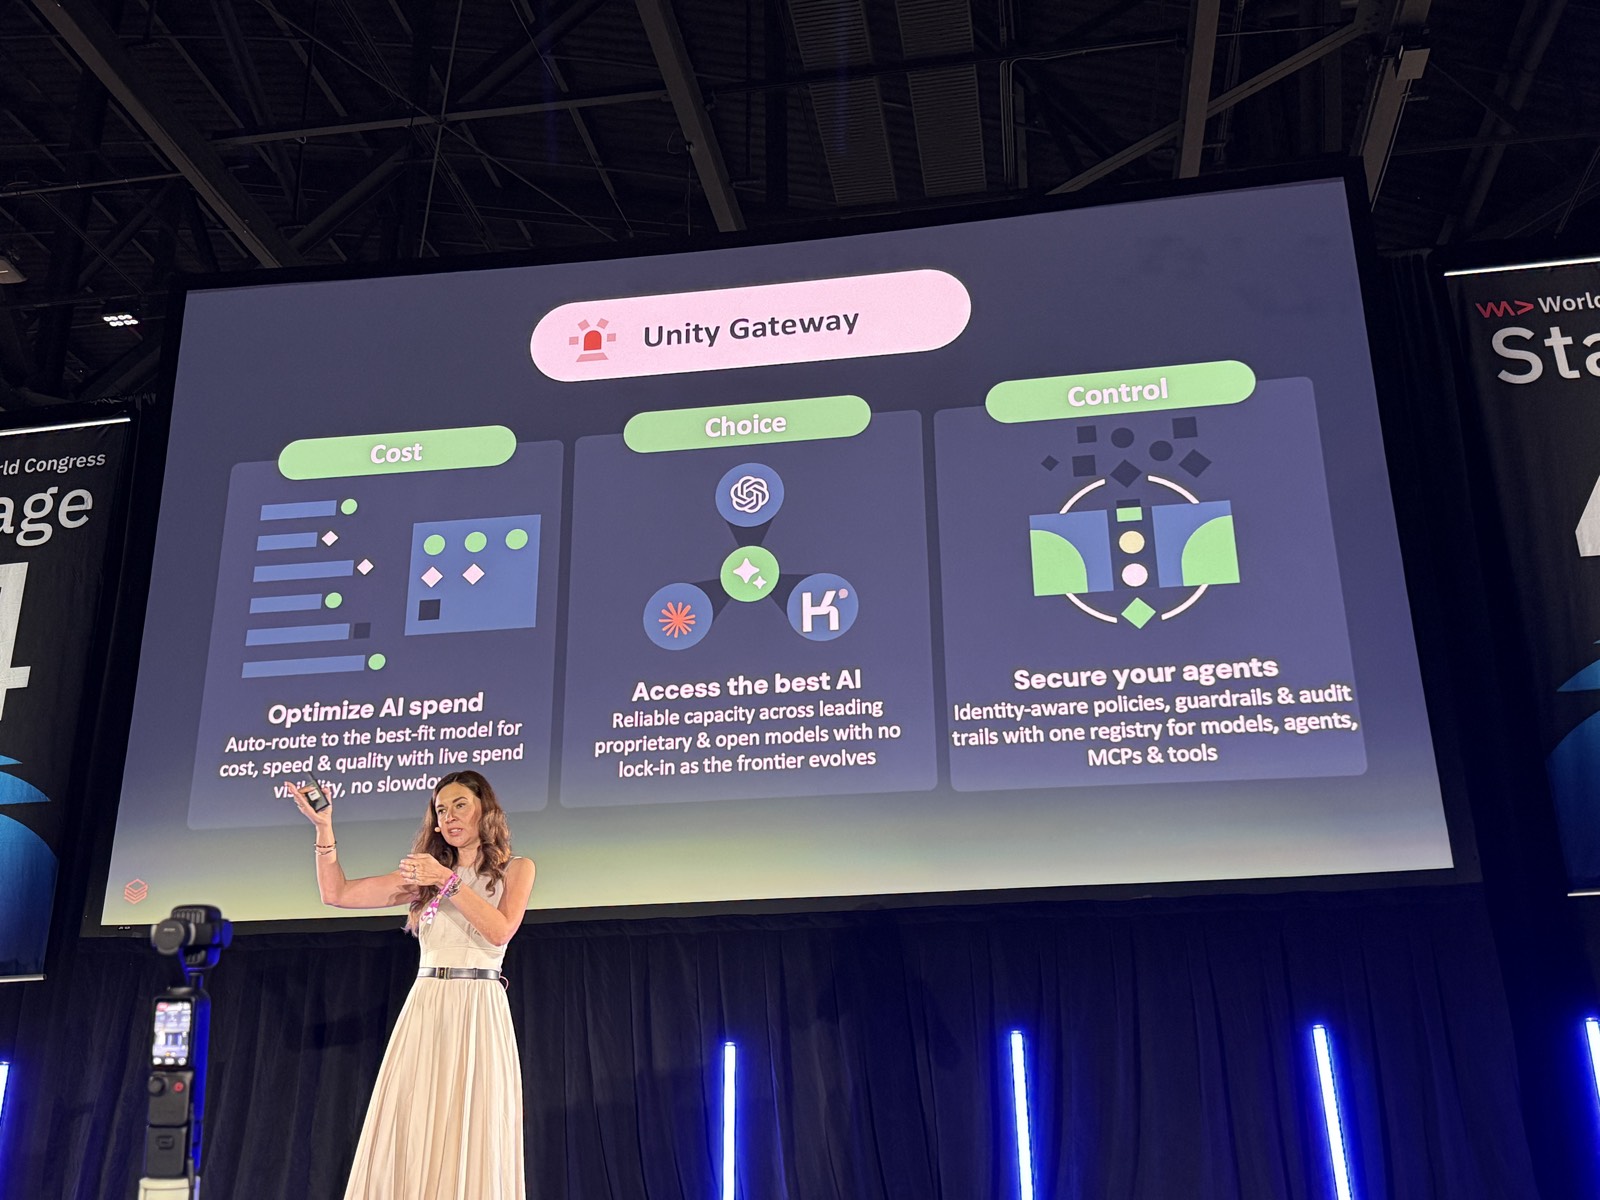
Cho những ai chưa quen, chị giải thích: về cơ bản, bạn đi qua AI Gateway và chọn bất kỳ model nào bạn muốn. Bạn tạo một endpoint, rồi chọn model cho endpoint đó. Như vậy là bạn decouple application khỏi model. Trong code, bạn không gọi thẳng một model cụ thể kiểu "OpenAI GPT model" nữa, bạn chỉ gọi một gateway endpoint. Phía sau endpoint đó, bạn đổi model thoải mái. Khi model mới ra liên tục, việc maintain trở nên rất dễ. Đó là một cách để chọn và đổi model.
Nhưng gateway không chỉ là chọn model, không chỉ là một lớp abstraction cho endpoint. Gateway cho mình một chỗ tập trung toàn bộ chi phí. Qua gateway, bạn có thể cho cả AI agents, coding agents và mọi thứ khác đi qua. Khi đó toàn bộ chi phí nằm trong một control plane, và bạn có visibility về mọi thứ đang xảy ra.
6. Demo tạo endpoint: traffic split, fallback, rate limit, và dashboard usage
Viktoria nói tiếp về gateway: mọi request đều được log lại. Gateway đi kèm nhiều lựa chọn model. Chị khẳng định Databricks là công ty duy nhất nơi bạn dùng được bất kỳ model nào: bạn có thể đi tới Anthropic, tới Gemini, hoặc chọn các open-weight model, nên lựa chọn rất nhiều. Rồi bạn đặt control: định nghĩa user nào, model nào, tool nào, ai được truy cập cái gì. Chị nhấn mạnh gateway có rất nhiều chức năng, chứ không chỉ là "một cái endpoint để route model".
Chị cho xem nhanh cách tạo một endpoint. Rất đơn giản: bấm create endpoint, chọn các model, và có thể đặt traffic split. Ví dụ bạn muốn thử nhiều model cùng lúc, bạn chia traffic 50/50, rồi trong live production thu thập dữ liệu xem model nào chạy tốt hơn với mình. Ngoài ra có thể đặt fallback: nếu model của Anthropic không available, bạn đặt OpenAI làm fallback. Bạn cũng đặt được các ngưỡng usage, ví dụ queries per minute, tokens per minute. Phần sau chị sẽ cho xem cách đặt budget policy.
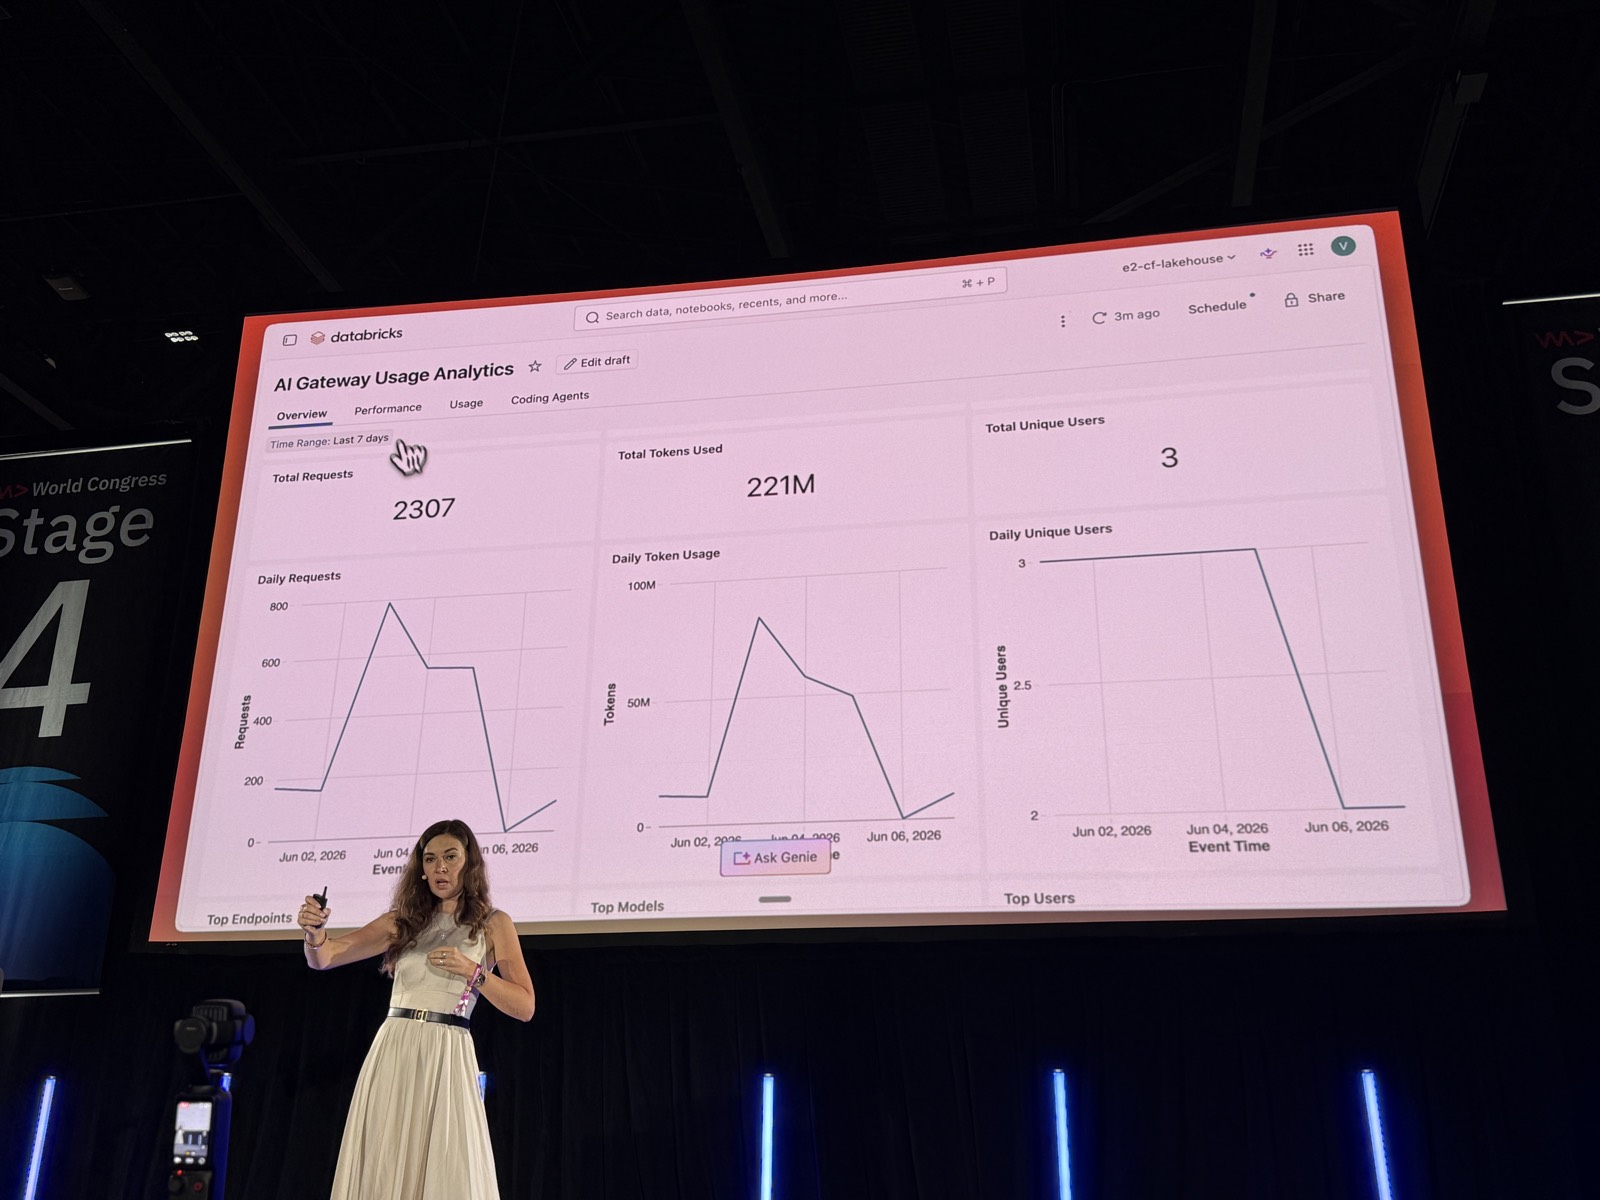
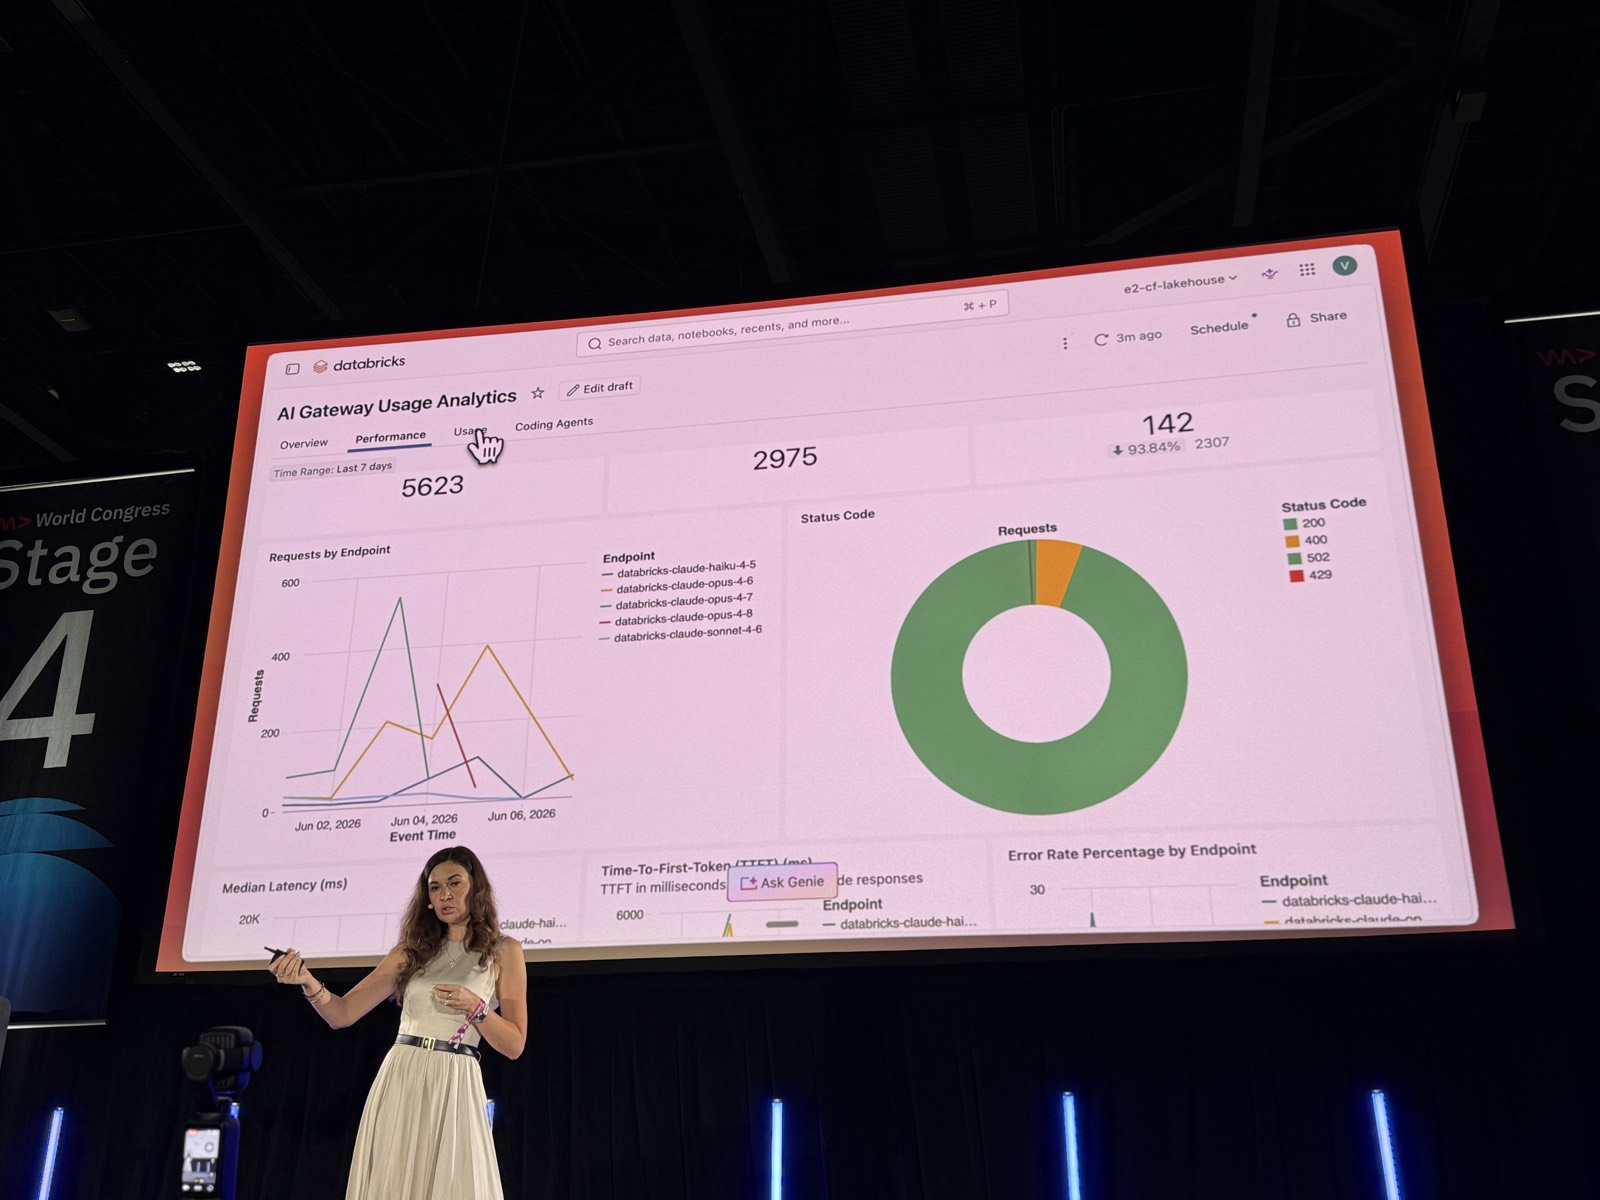
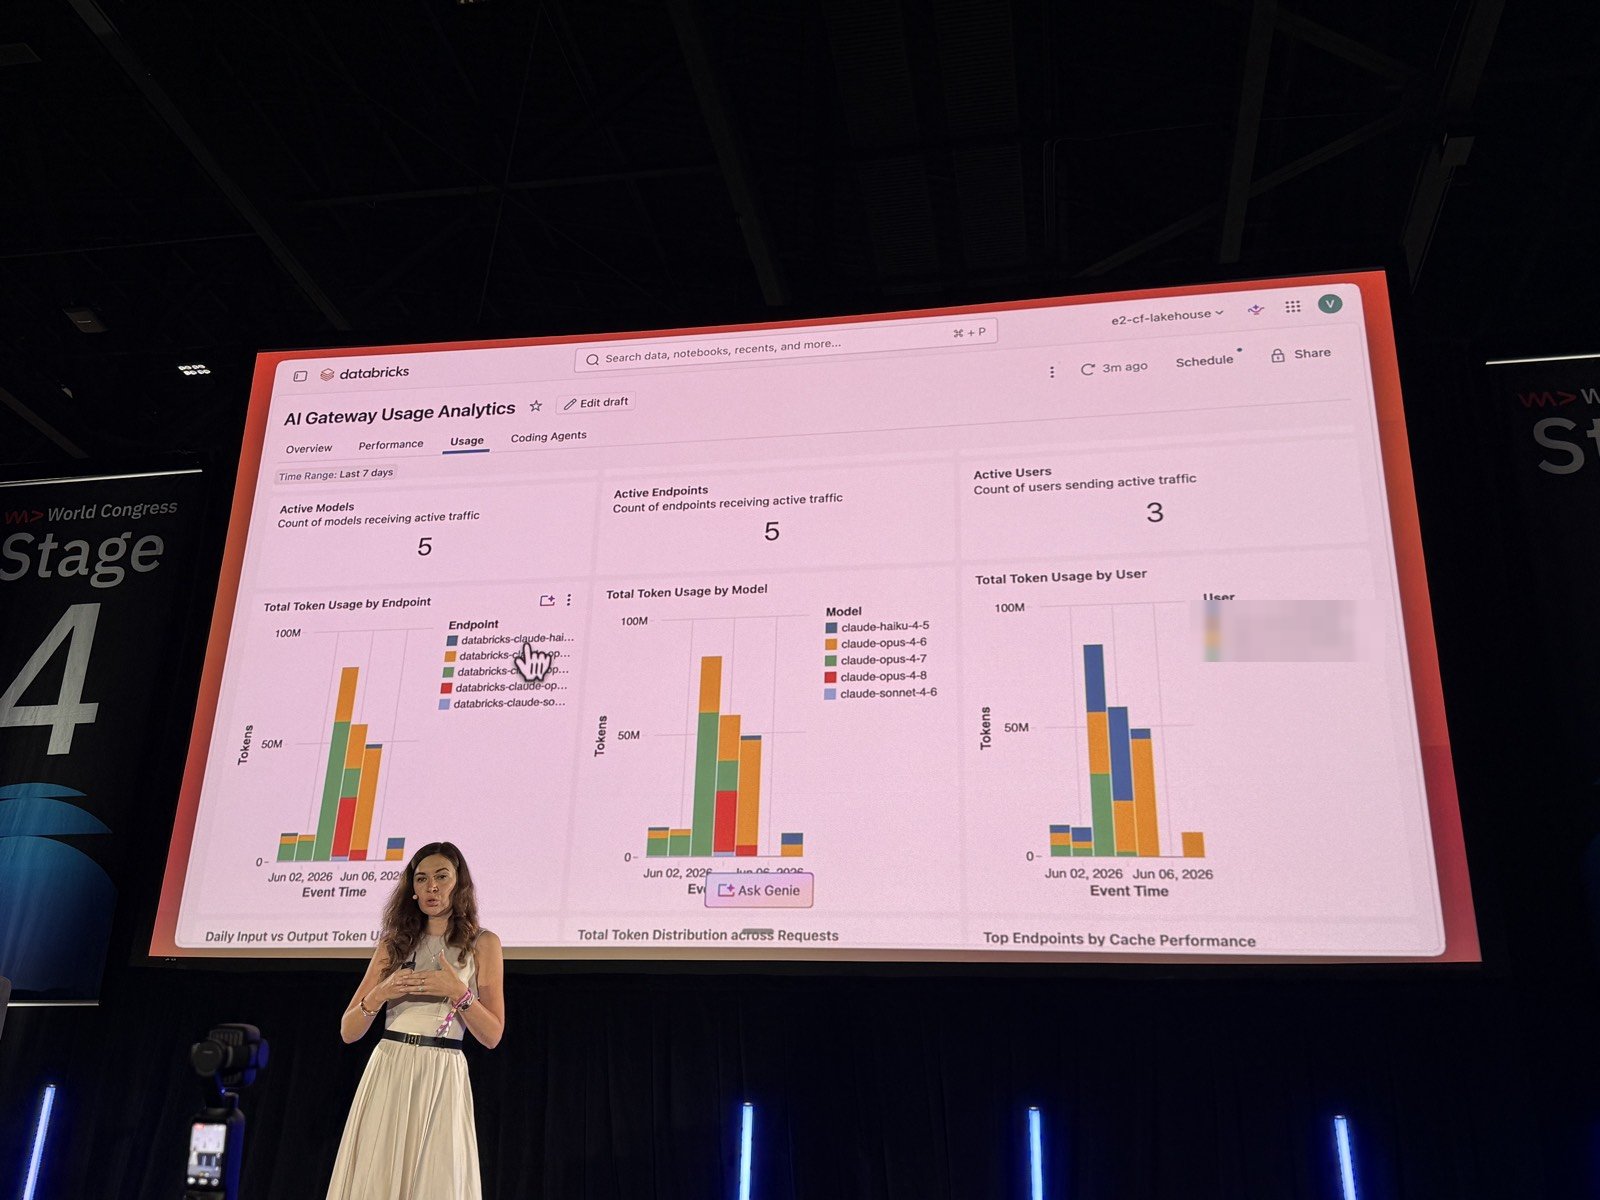
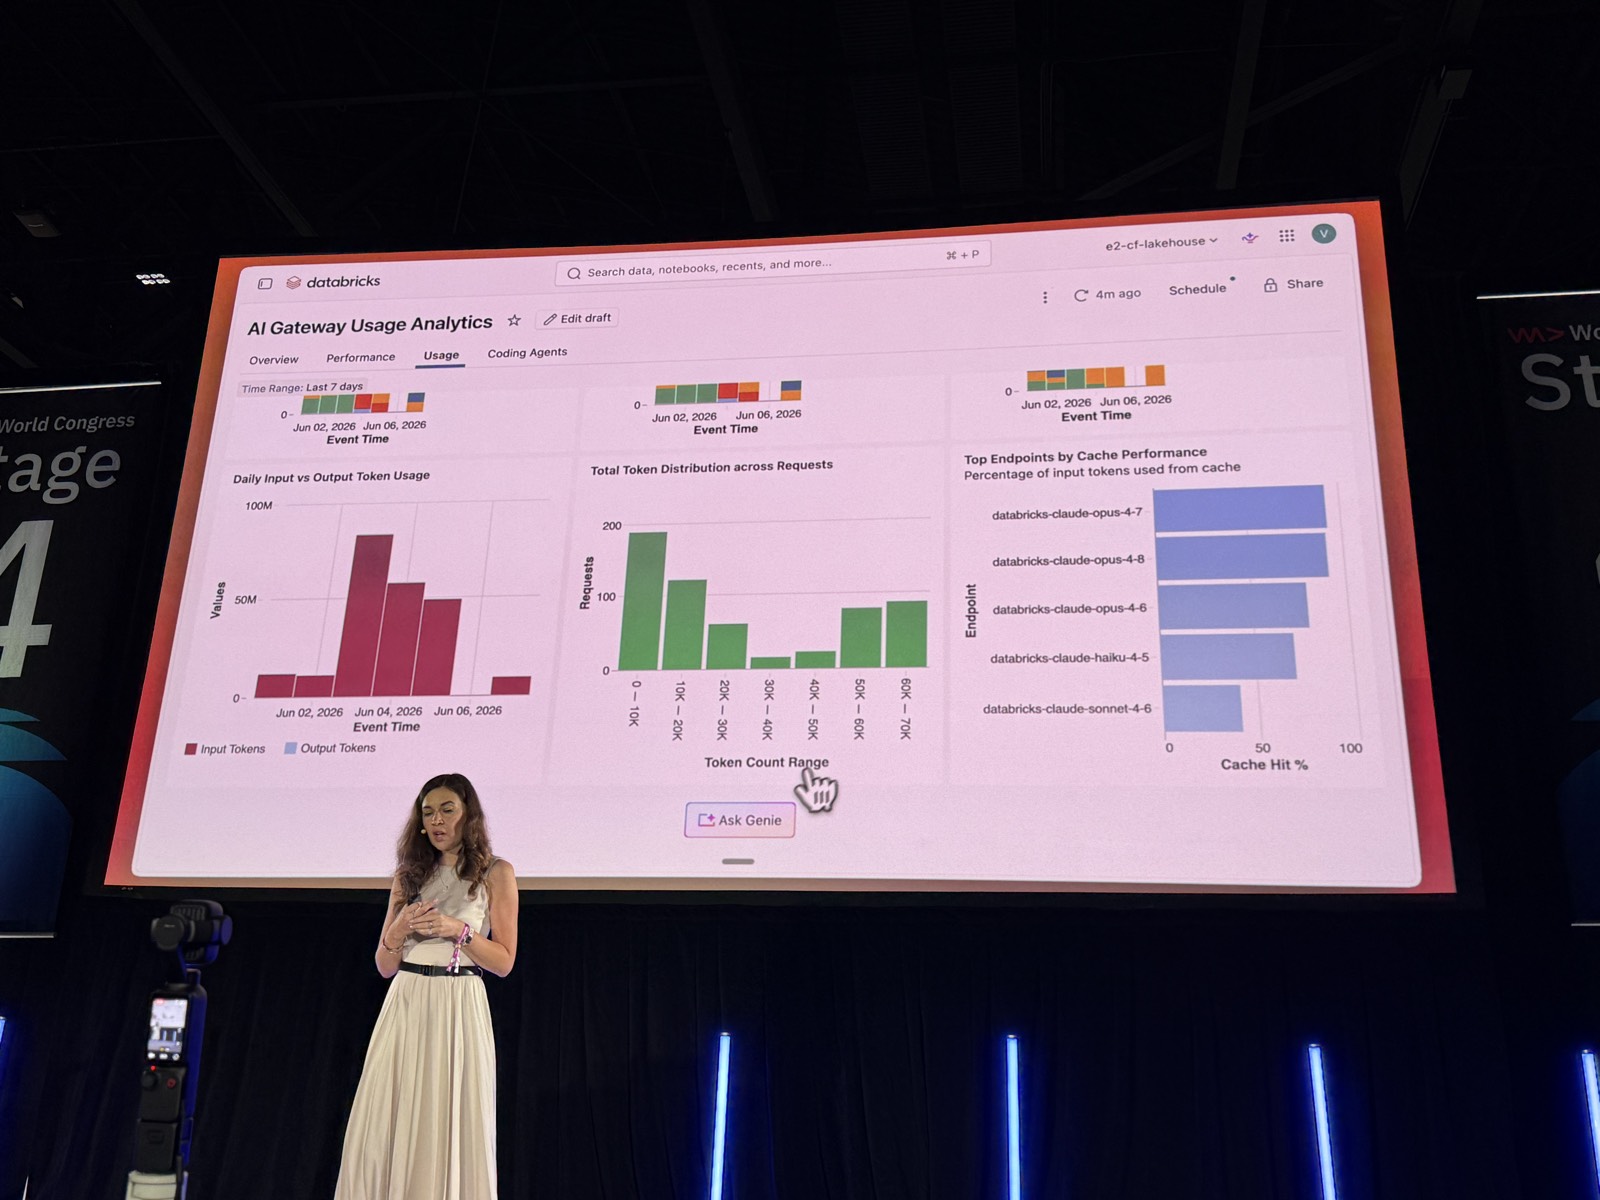
Tạo endpoint xong, bạn chỉ cần test để chắc mọi thứ chạy và mọi request được log. Log đi vào system table, và từ đó bạn thấy ai đang gọi, user nào, phòng ban nào, model nào đang được dùng. Bạn có thể tự build mọi dashboard kiểu này, hoặc dùng Genie.
7. Genie và system table: hỏi dữ liệu usage bằng câu hỏi thường
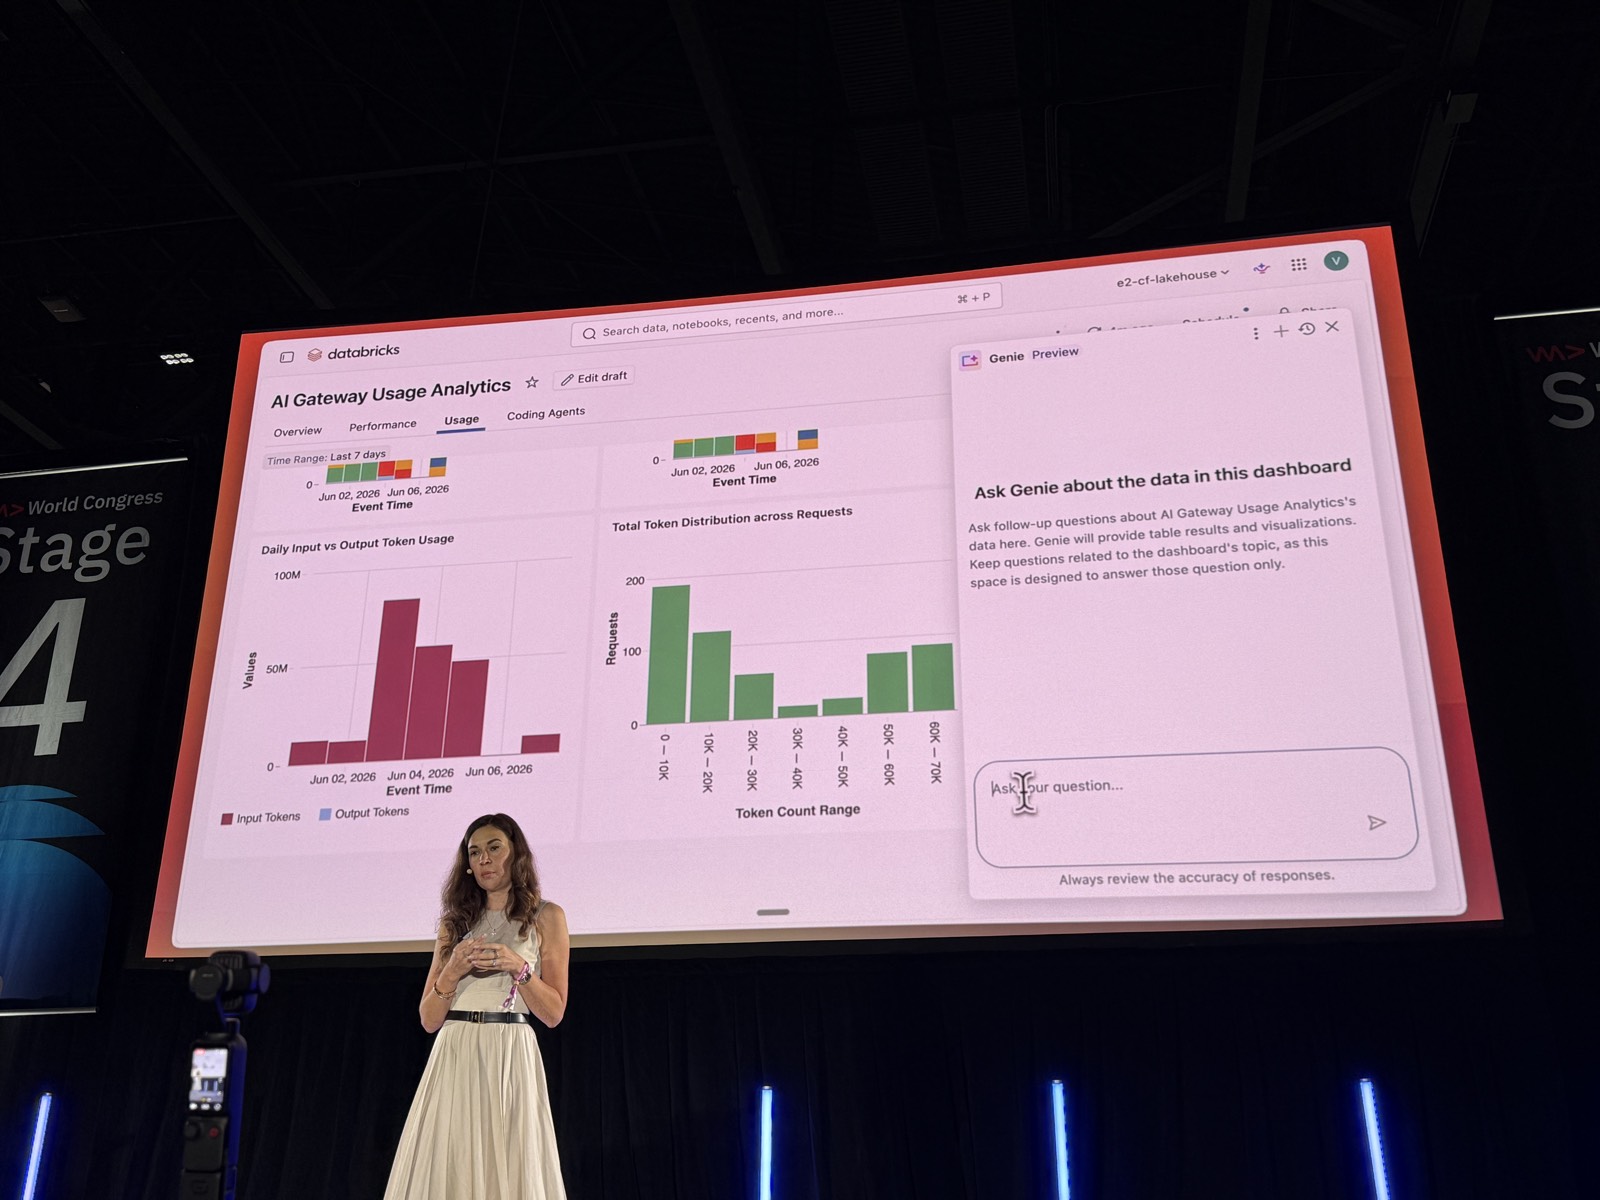
Trong demo, Viktoria mở Genie ngay trên dashboard và hỏi, đại ý, "Viktoria Semaan đang dùng gì?". Genie đi qua dữ liệu usage của chị và trả lời rằng chị dùng Opus rất nhiều. Chị tự cười mình: "chắc tôi không phải người dùng tối ưu nhất". Ý chị là có rất nhiều thứ bạn có thể khám phá khi dữ liệu nằm sẵn một chỗ.
Như chị đã nói, toàn bộ dữ liệu này được lưu trong bảng usage của AI gateway. Nó cho bạn cả control lẫn visibility.
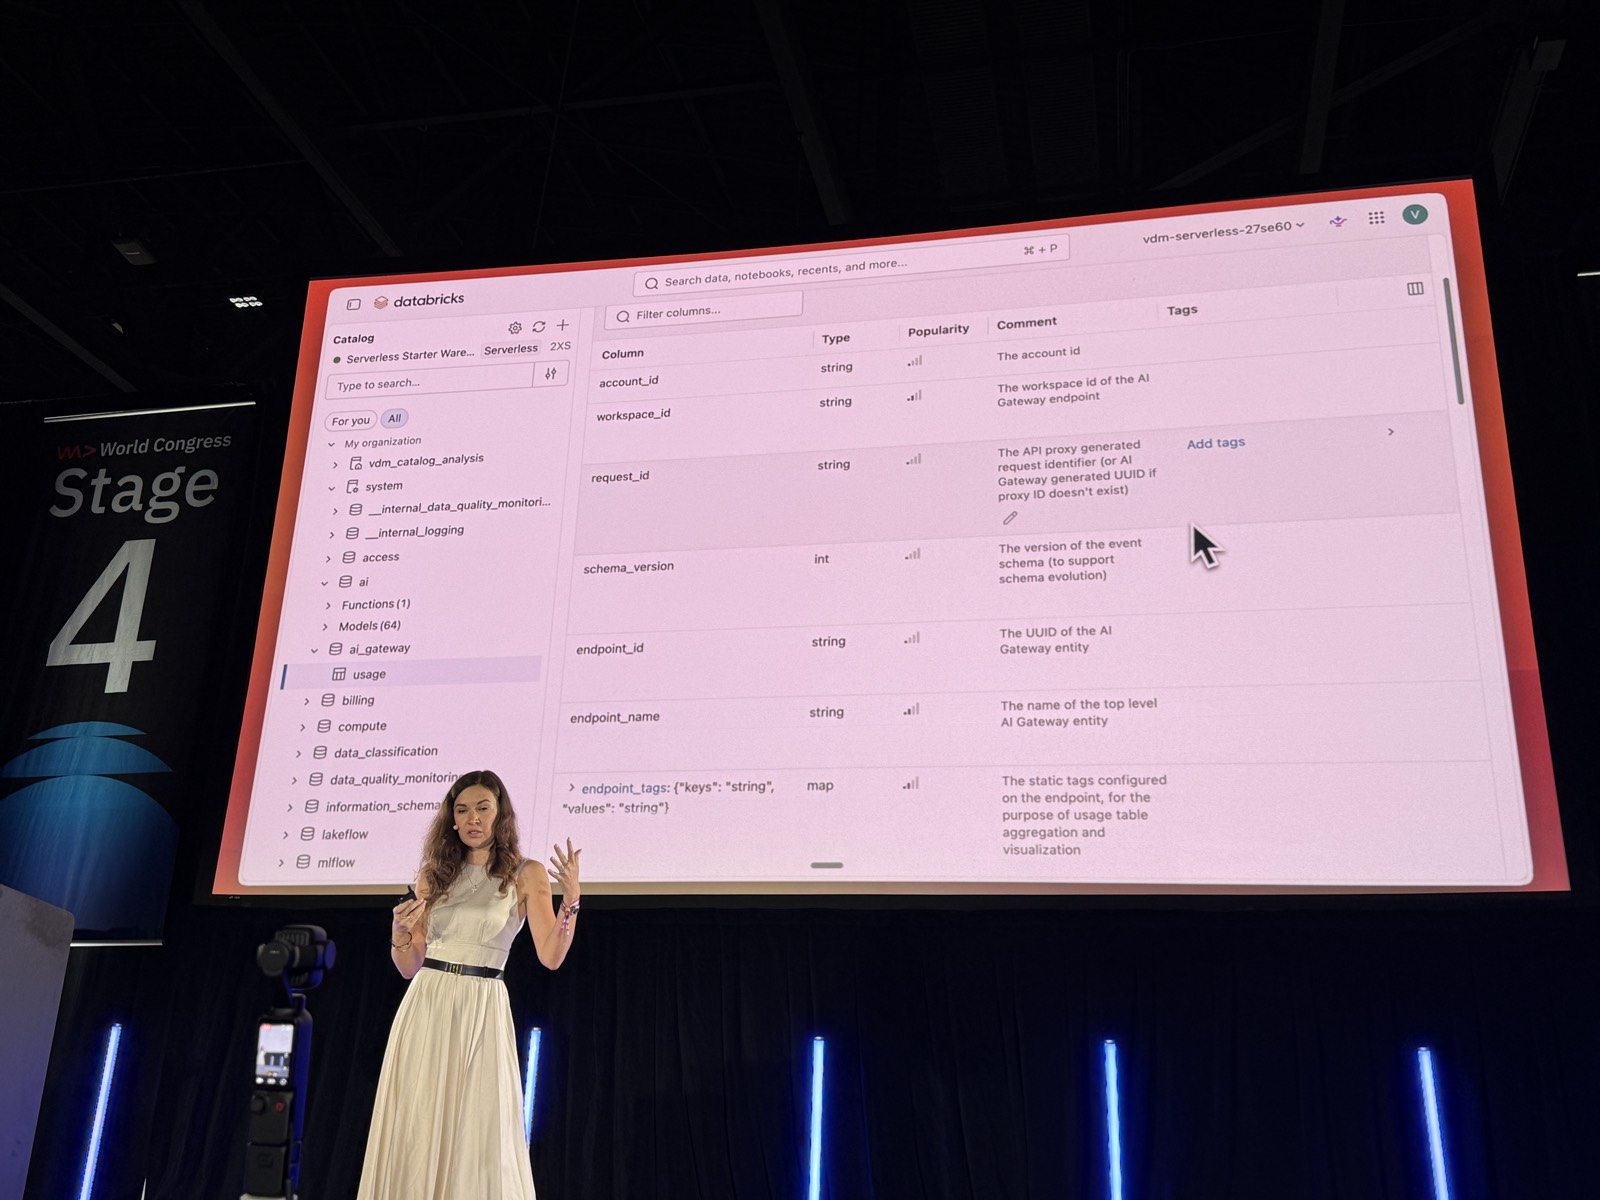
system.ai_gateway.usage (bên trái thấy các schema khác trong system: access, ai, billing, compute, lakeflow, mlflow...). Các cột: account_id, workspace_id, request_id (định danh request do API proxy sinh, hoặc UUID do AI Gateway sinh nếu không có), schema_version (để hỗ trợ schema evolution), endpoint_id, endpoint_name, endpoint_tags (tag tĩnh gắn trên endpoint để gom nhóm và vẽ biểu đồ).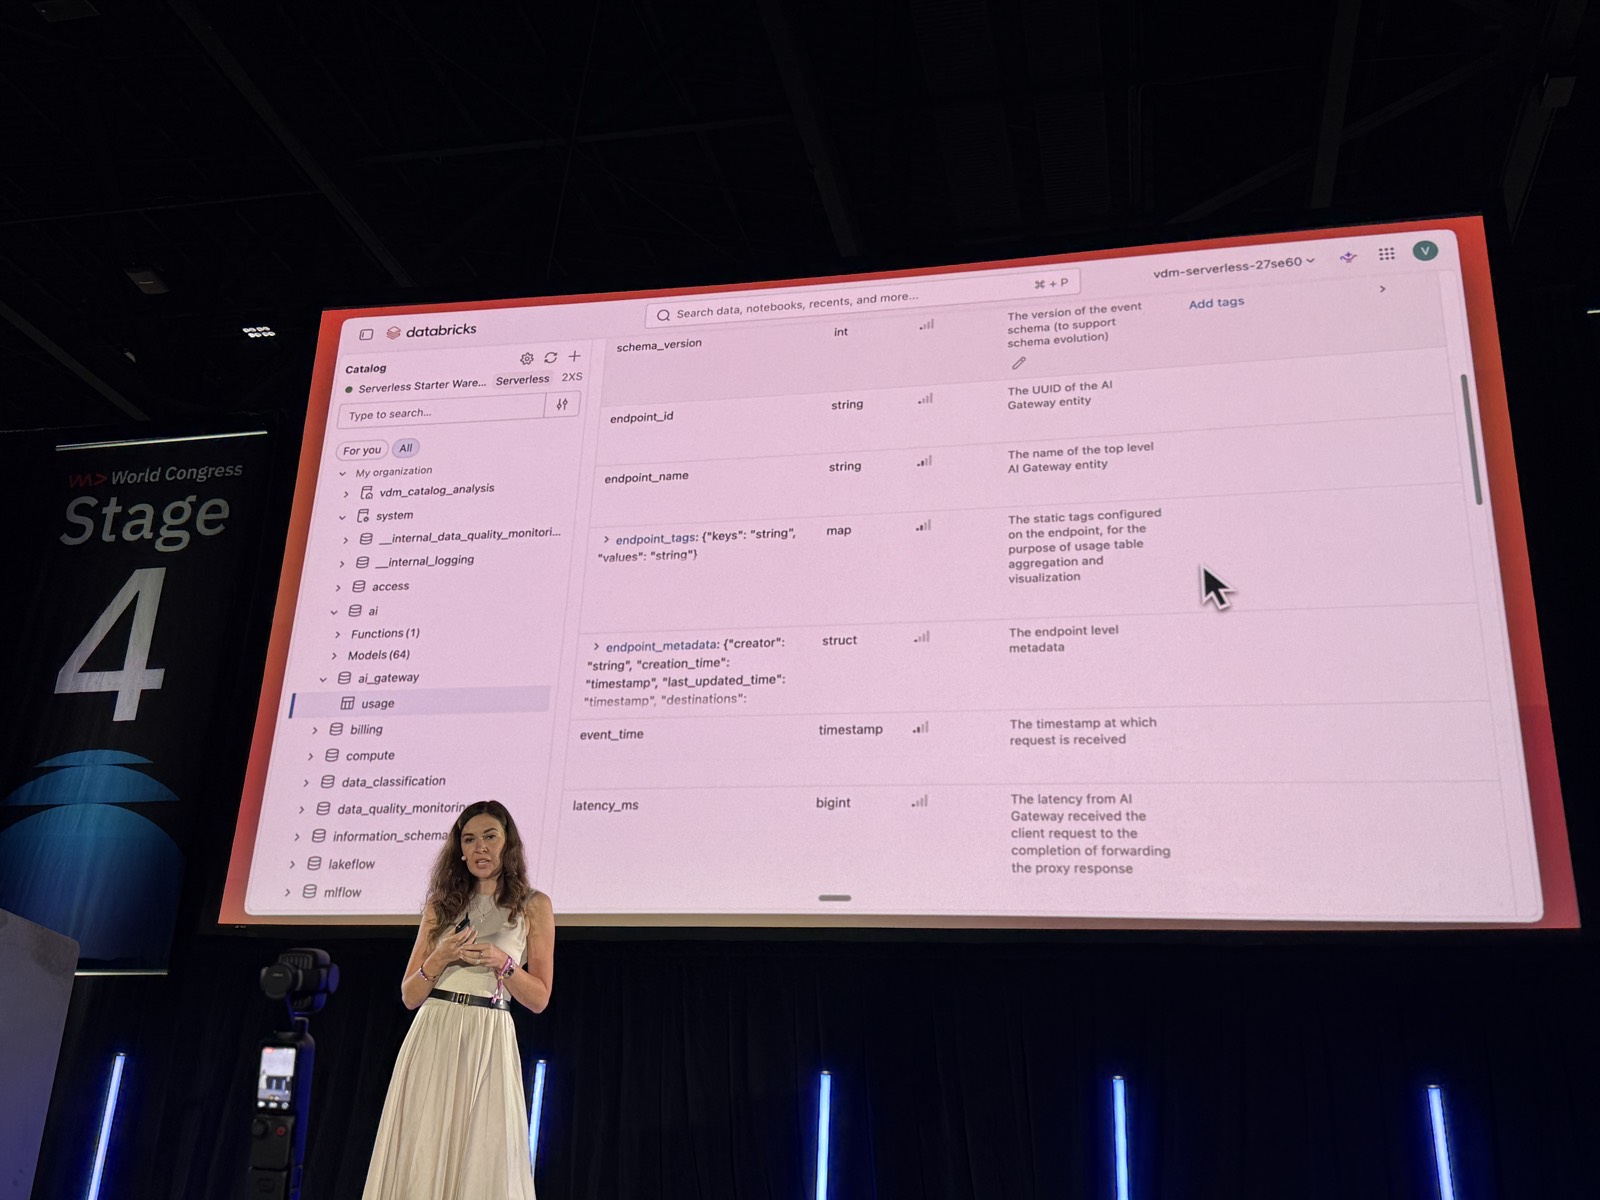
8. Step 1: build evaluation với MLflow 3, eval set, scorer, LLM judge, human feedback
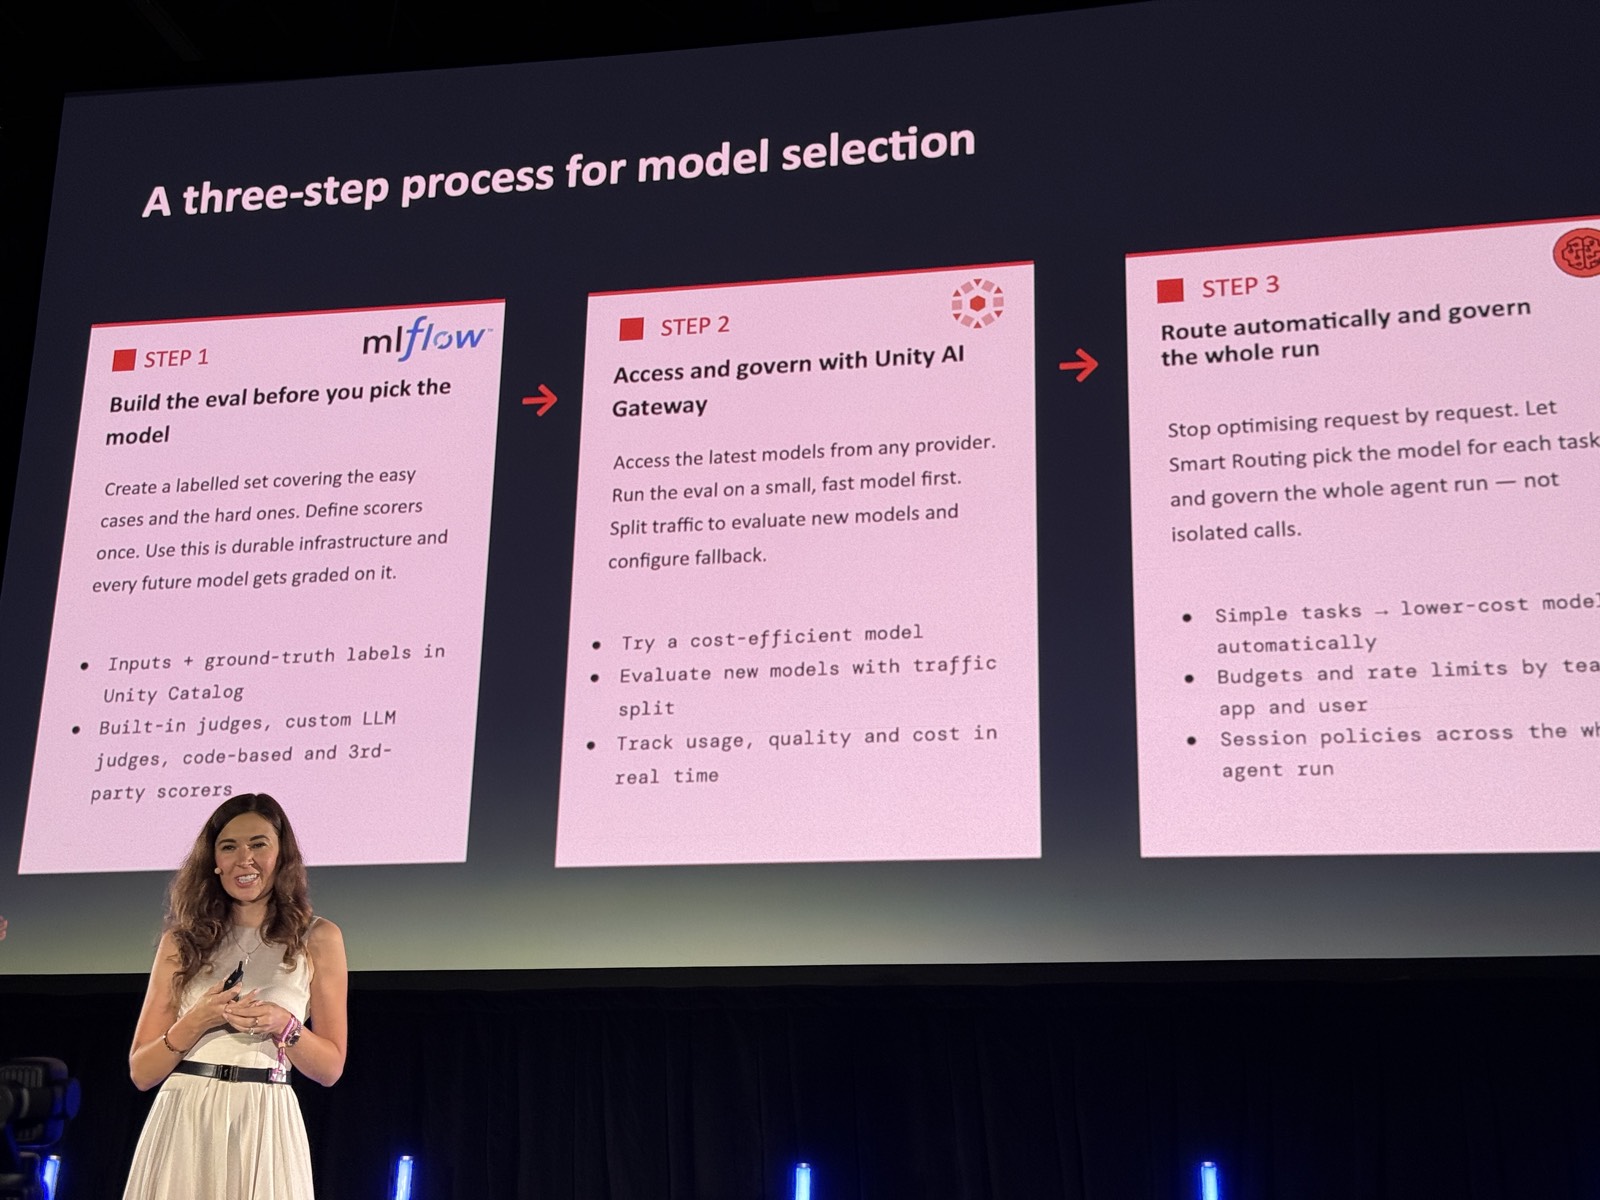
"Okay, cái này hay rồi", chị nói, giờ mình đã đặt được mọi endpoint phía sau AI gateway. Nhưng làm sao evaluate được, làm sao biết nên đặt model nào? Cách chị đề xuất là dùng MLflow 3, một nền tảng open source, để dựng experiments, tracking, evaluations và visualize mọi kết quả.
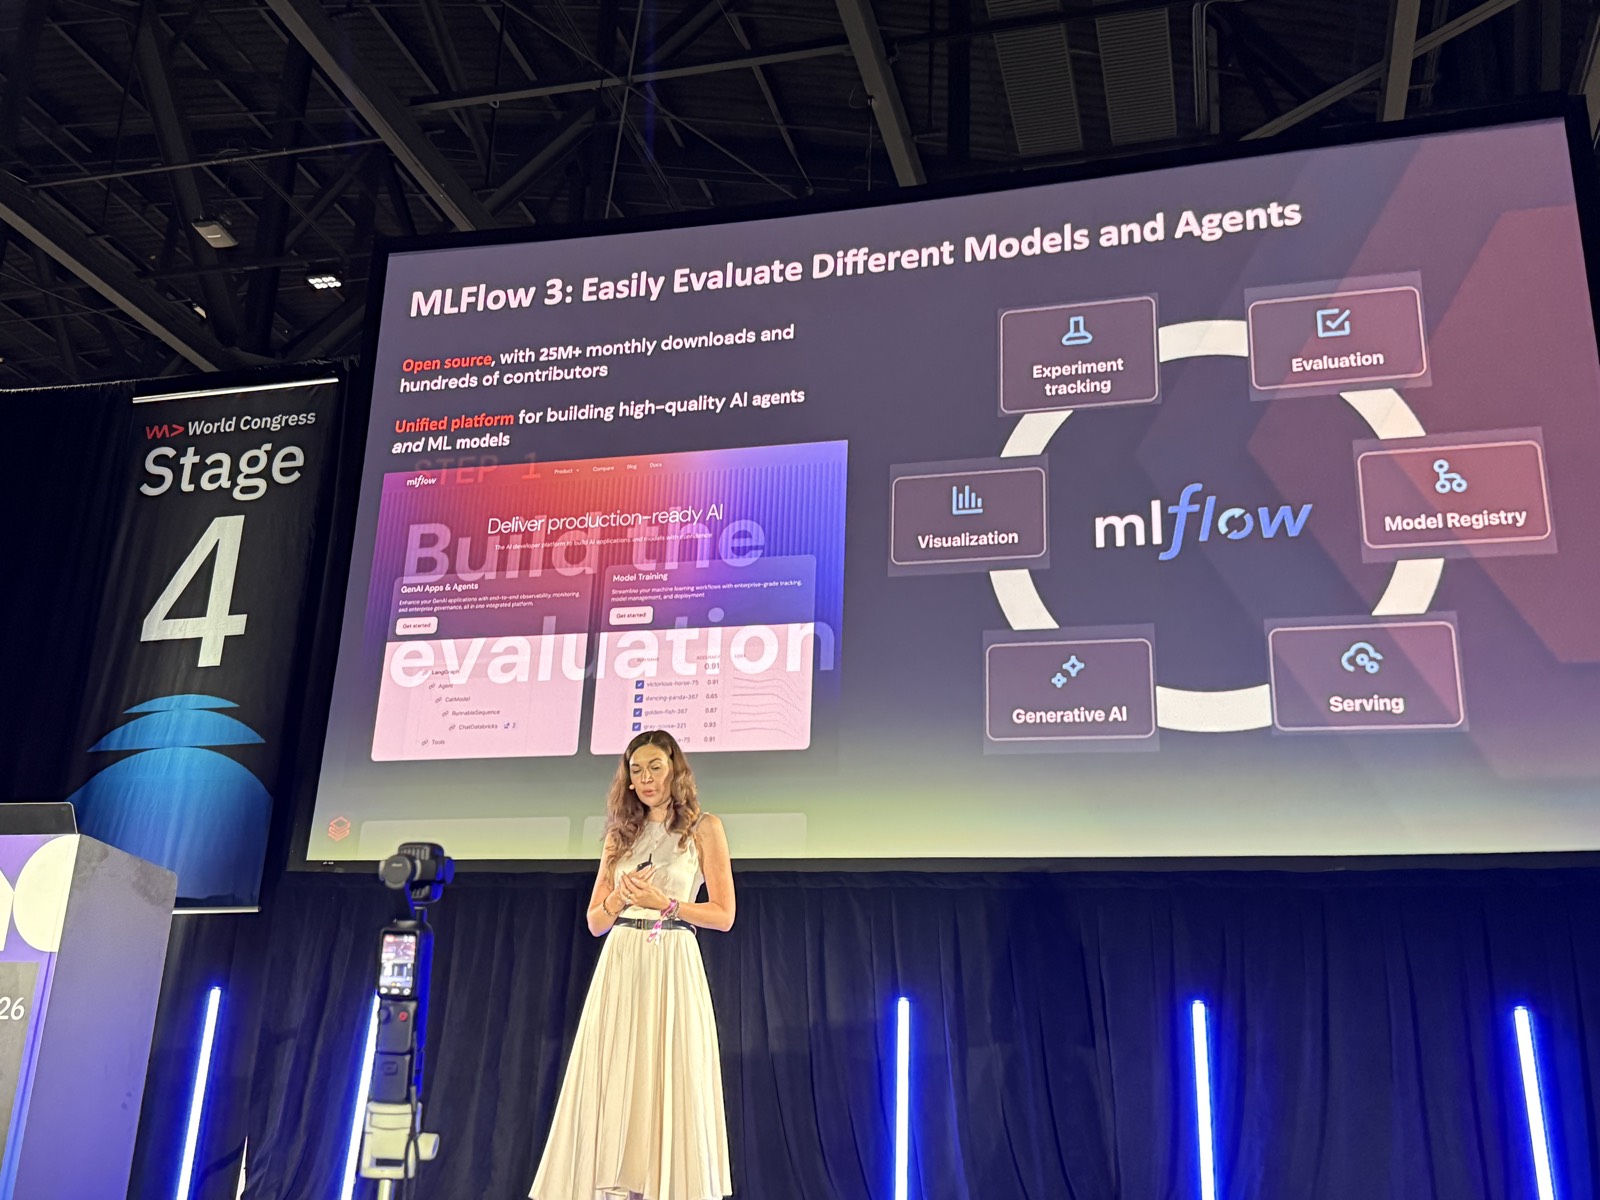
Bước đầu tiên là tạo evaluation set. Chị lấy ví dụ bài toán phân loại tin nhắn: tin này là spam, là harassment, hay là tin bình thường. Đầu tiên chị tạo evaluation set nói cho model biết chị coi mỗi loại (category) là gì. Sau đó định nghĩa score. Ví dụ này khá đơn giản: score chỉ là "model dự đoán label đúng hay sai", tức là nhị phân. Rồi chạy evaluation đó qua nhiều model khác nhau. Giả sử chọn GPT-5 và Opus 4.5, mình sẽ thấy model nào dự đoán tốt hơn, và dựa vào đó để chọn model.
Đó là ví dụ rất đơn giản. Khi task mơ hồ hơn, bạn có thể dùng LLM judge. Ví dụ bạn đang tạo một bản brief, và bạn cần biết brief đó có giữ đúng brand relevancy, có chứa một số yếu tố nhất định hay không. Bạn đưa ra hướng dẫn cách chấm brief, và dựng một LLM làm judge. Trong ví dụ của chị, chị chọn Opus làm judge. Khi chạy qua các LLM khác nhau, Opus sẽ nhìn vào kết quả đầu ra, tức là brief do từng model viết, rồi đọc scoring guidance của chị và chấm điểm từng model. Đó là LLM-as-a-judge.
Và cuối cùng, trong những trường hợp high-stakes, bạn có thể escalate lên con người. Người review có thể nói "tôi không thích cách brief này được viết, nó không nên dùng cái này, cái này". Feedback đó được merge ngược vào evaluation, để judge hiểu thêm. Con người đưa càng nhiều feedback, judge càng tốt lên.
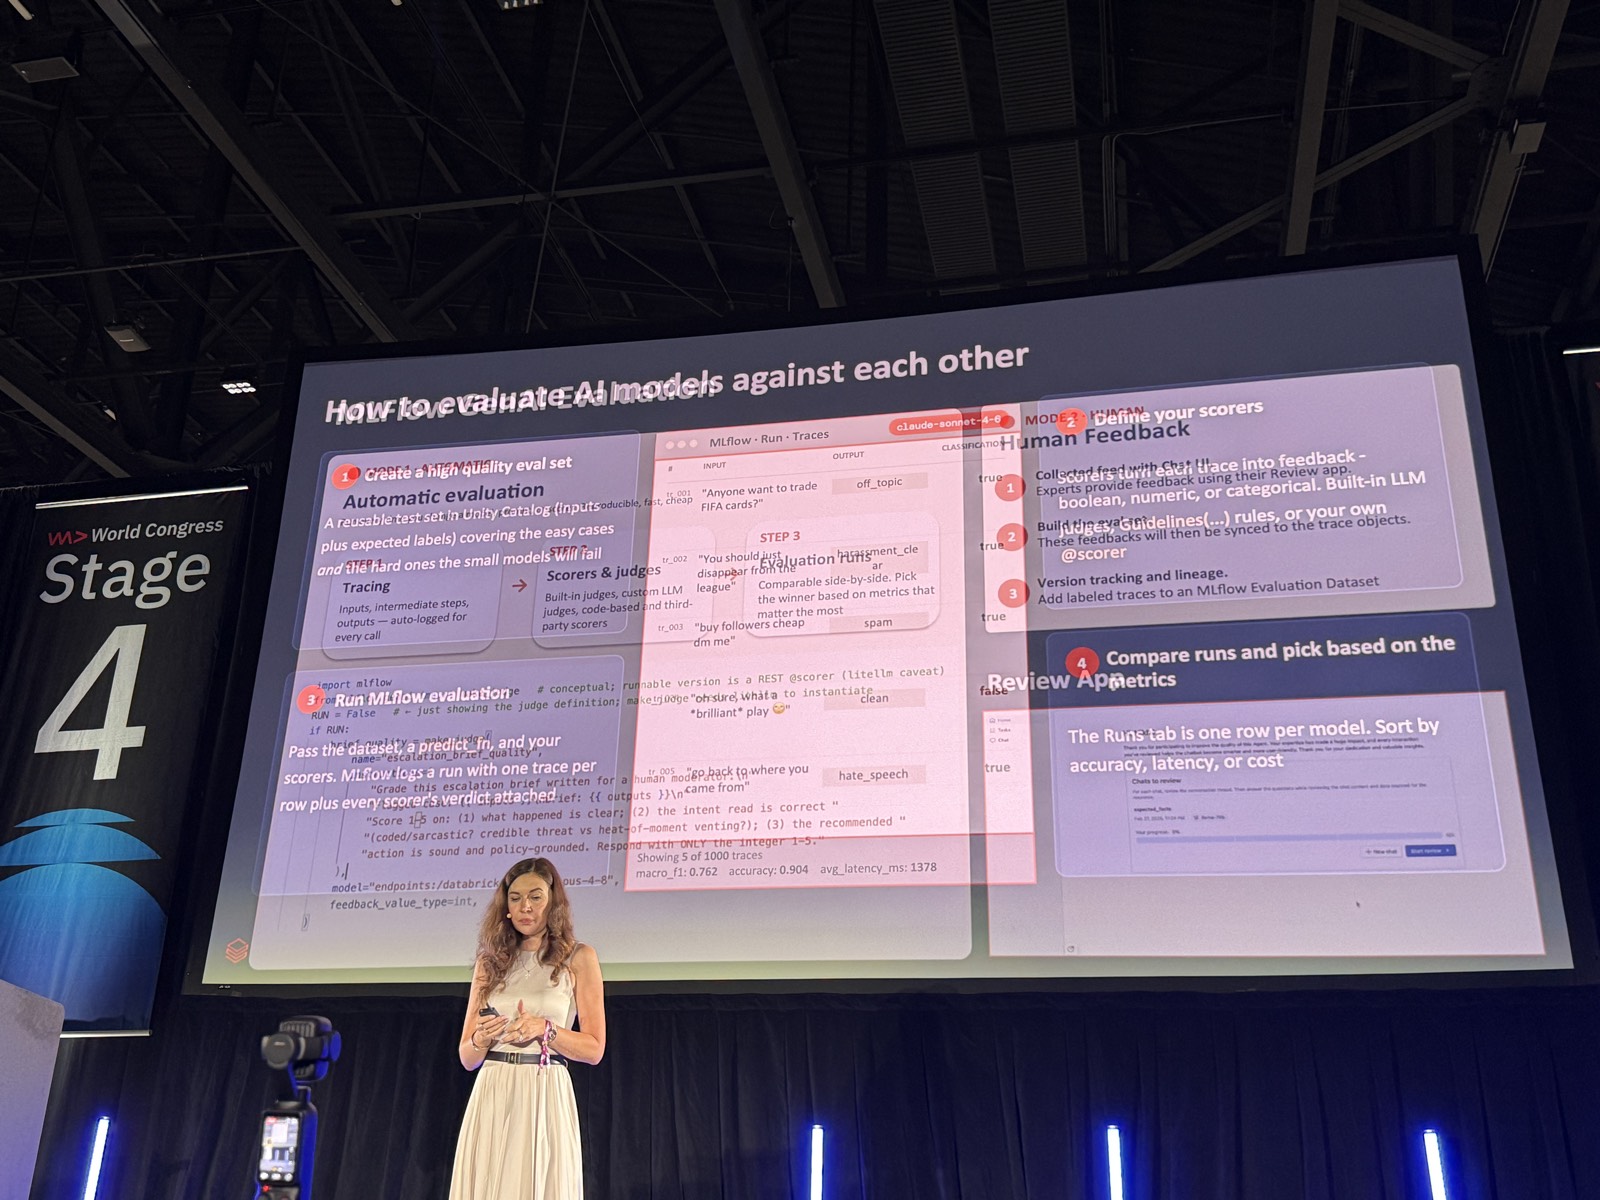
@scorer tự viết; (3) Run MLflow evaluation, đưa dataset, predict_fn và scorers, MLflow log một run với mỗi dòng một trace kèm verdict của từng scorer; (4) Compare runs and pick based on the metrics, tab Runs mỗi model một dòng, sort theo accuracy, latency hoặc cost. Lớp Human Feedback: chuyên gia đưa feedback qua Review App, feedback sync về trace, có version tracking và lineage, thêm trace đã gán nhãn vào MLflow Evaluation Dataset. Giữa slide là ví dụ trace phân loại: "Anyone want to trade FIFA cards?" là off_topic, "You should just disappear from the league" là harassment, "buy followers cheap dm me" là spam, "oh sure, what a *brilliant* play" là clean, "go back to where you came from" là hate_speech; hiển thị 5 trên 1000 trace, macro_f1 0.762, accuracy 0.904, avg_latency_ms 1378.Đoạn code judge hiện mờ trên slide (phần chữ đọc được, những chỗ bị lớp khác che được đánh dấu "..."):
quality = make_judge(
    name="escalation_brief_quality",
    instructions=(
        "Grade this escalation brief written for a human moderator ... {{ outputs }}\n"
        "Score 1-5 on: (1) what happened is clear; (2) the intent read is correct "
        "(coded/sarcastic? credible threat vs heat-of-moment venting?); (3) the recommended "
        "action is sound and policy-grounded. Respond with ONLY the integer 1-5."
    ),
    model="endpoints:/databricks-claude-opus-4-8",
    feedback_value_type=int,
)
9. Demo evaluation: 16 model phân loại tin nhắn, và LLM judge chấm escalation brief
Chị cho xem demo. Đầu tiên là tạo evaluation set đơn giản: "đây là các label, đây là cách tôi muốn phân loại tin nhắn". Bối cảnh giả định là chị đang moderate một forum. Sau đó chị chạy nó qua MLflow evaluation: đưa dataset vào, rồi kiểm tra label có được gán đúng hay không. Chị chọn 16 model, evaluation chạy lần lượt qua cả 16 model, và chị có kết quả.
Ví dụ thứ hai là cái chị nhắc lúc trước: tạo một bản brief. Lúc này evaluation set phức tạp hơn. Chị phải cung cấp đủ các tin nhắn và ngữ cảnh được gom vào bản brief. Sau đó chị định nghĩa score: có thể là relevance, có thể là brand voice, và với mỗi score chị yêu cầu chấm từ 1 tới 5. Opus sẽ nhìn vào các score đó và chấm từng model, tức là Opus quyết định các model viết brief tốt tới đâu. Khi chạy xong, toàn bộ brief đi qua quá trình chấm, và chị xem được kết quả để biết model nào cho kết quả tốt hơn.
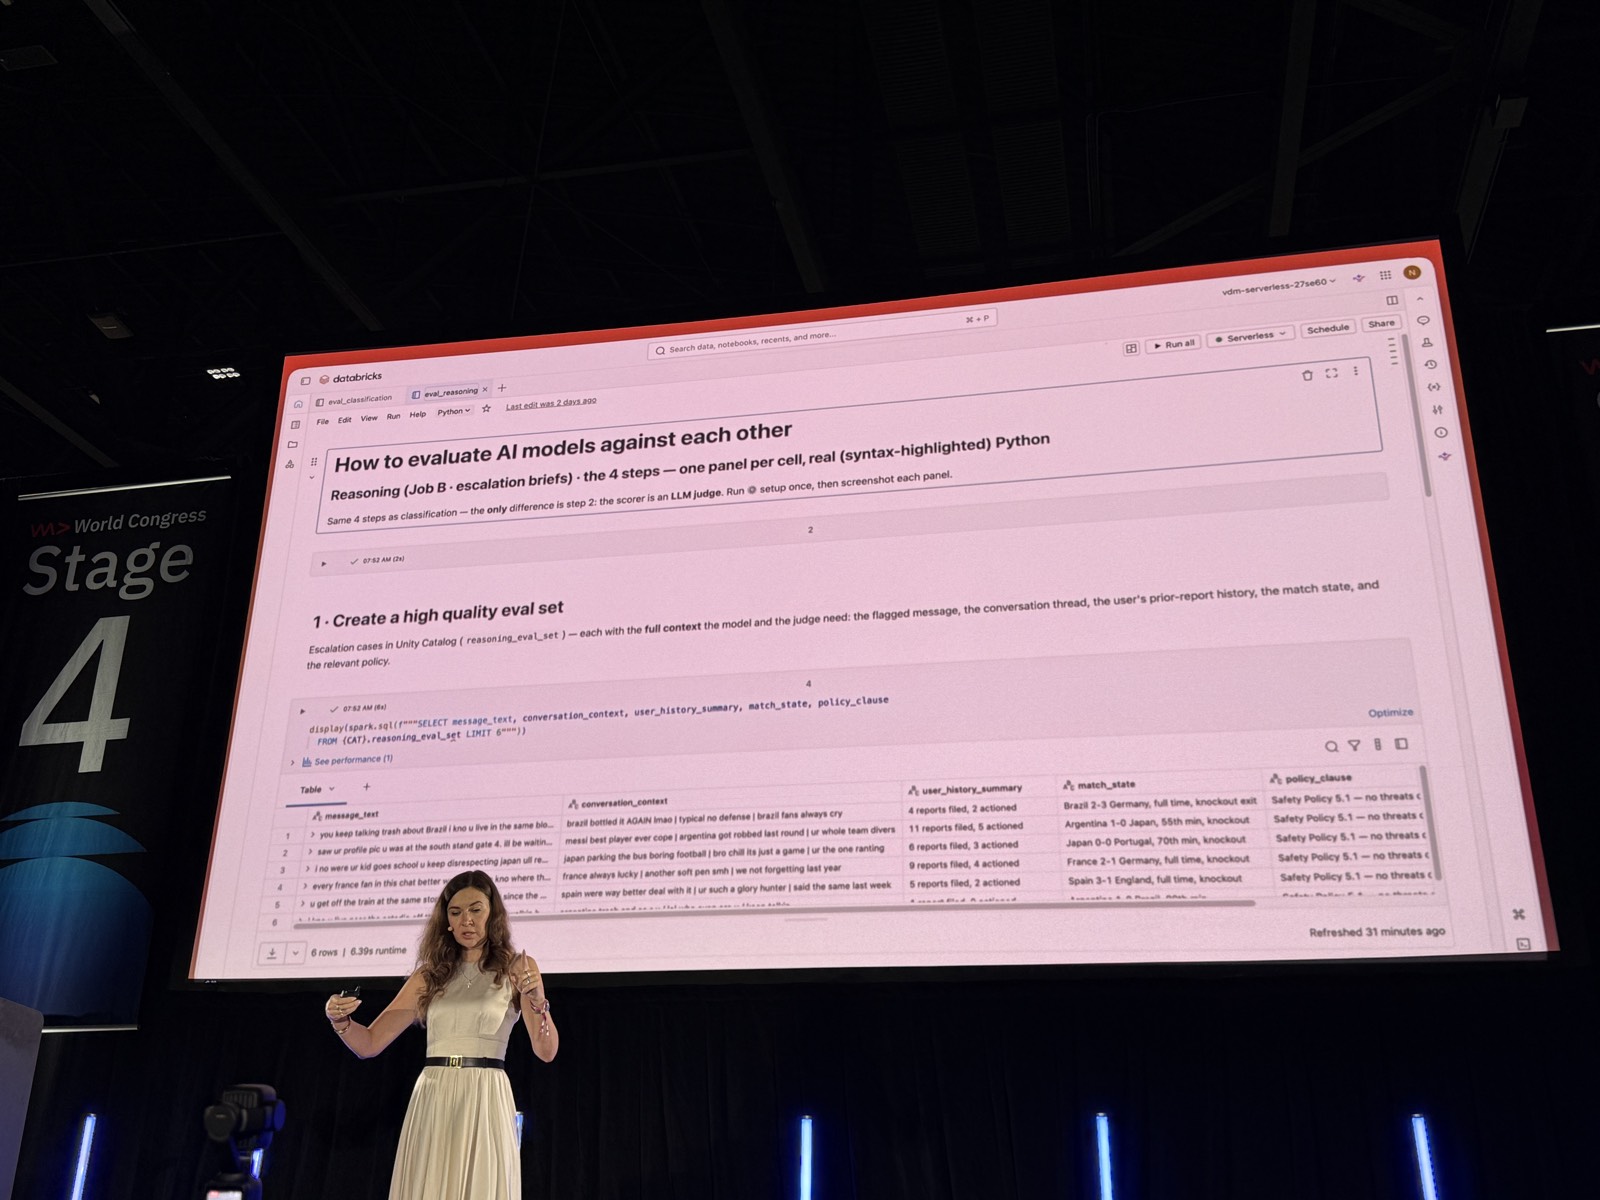
eval_reasoning (cạnh tab eval_classification): "How to evaluate AI models against each other. Reasoning (Job B, escalation briefs), the 4 steps, one panel per cell". Ghi chú trong notebook: bốn bước giống hệt bài classification, khác biệt duy nhất nằm ở bước 2, scorer là một LLM judge. Bước 1 "Create a high quality eval set": các ca escalation trong Unity Catalog (reasoning_eval_set), mỗi ca mang đủ context mà model và judge cần: tin nhắn bị flag, luồng hội thoại, lịch sử bị report của user, trạng thái trận đấu, và điều khoản policy liên quan. Dữ liệu mẫu là chat của fan bóng đá, ví dụ match_state "Brazil 2-3 Germany, full time, knockout exit", policy_clause "Safety Policy 5.1, no threats".Câu query lấy eval set trên màn hình, dùng lại được cho bài toán tương tự:
display(spark.sql(f"""SELECT message_text, conversation_context, user_history_summary, match_state, policy_clause
  FROM {CAT}.reasoning_eval_set LIMIT 6"""))
Tất cả những thứ này cũng được lưu trong MLflow, nên bạn có latency, cost, accuracy, mọi thông tin nằm sẵn đó, để so sánh và build dashboard.
10. Step 2: govern agents, MCP tools, coding agents; policy và đường đi của một request
Giờ đã biết cách dựng evaluation và chọn model, câu hỏi tiếp theo là: mình đâu chỉ có model, mình còn có agents. Với Unity AI Gateway, bạn cũng có thể cho agents, MCP tools và coding agent của mình chạy qua đó. Bạn đặt được budget. Ví dụ phòng engineering đang dùng Cursor, dùng Claude Code, bạn cấp cho họ một budget cụ thể, và nếu họ dùng vượt, họ sẽ bị chặn luôn. Đó là budget control.
Bạn cũng đặt được contextual policy, nơi một số hành động đơn giản là không được phép. Ví dụ, có thể mình không muốn model của phòng marketing lấy được thông tin về doanh thu. Có rất nhiều loại rule khác nhau bạn có thể đặt.
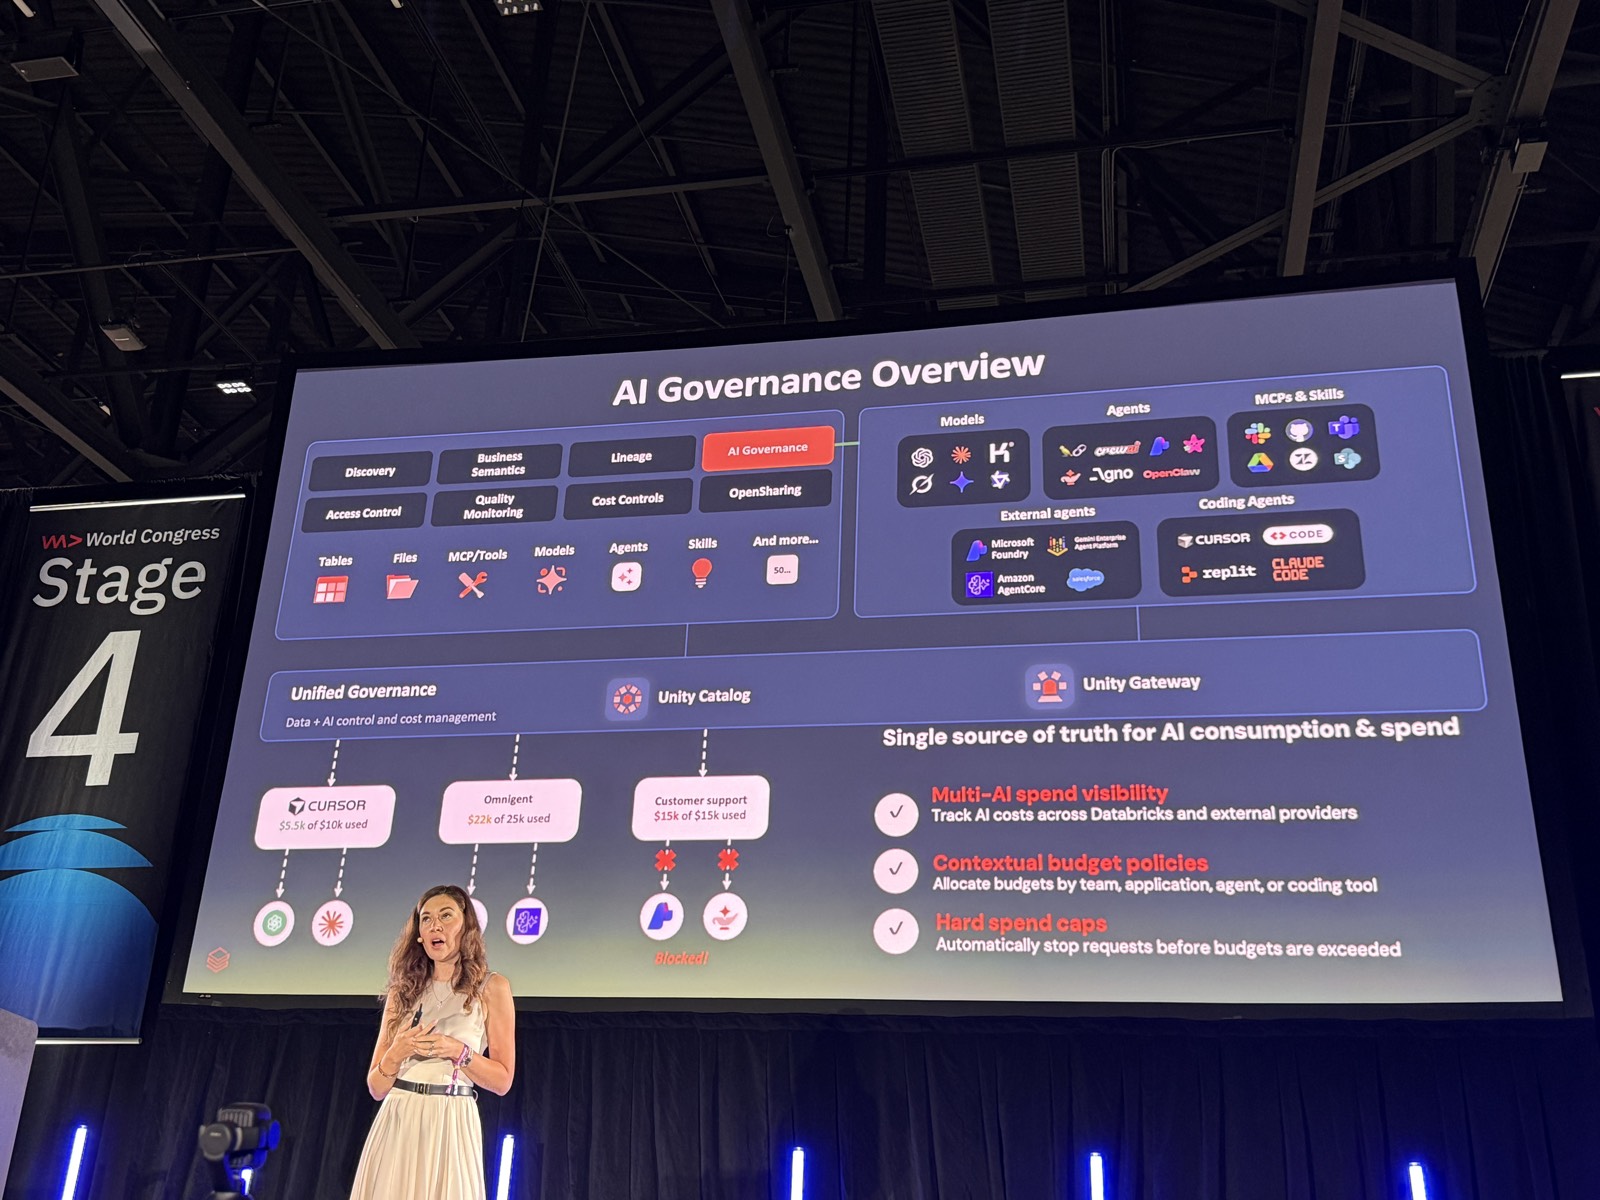
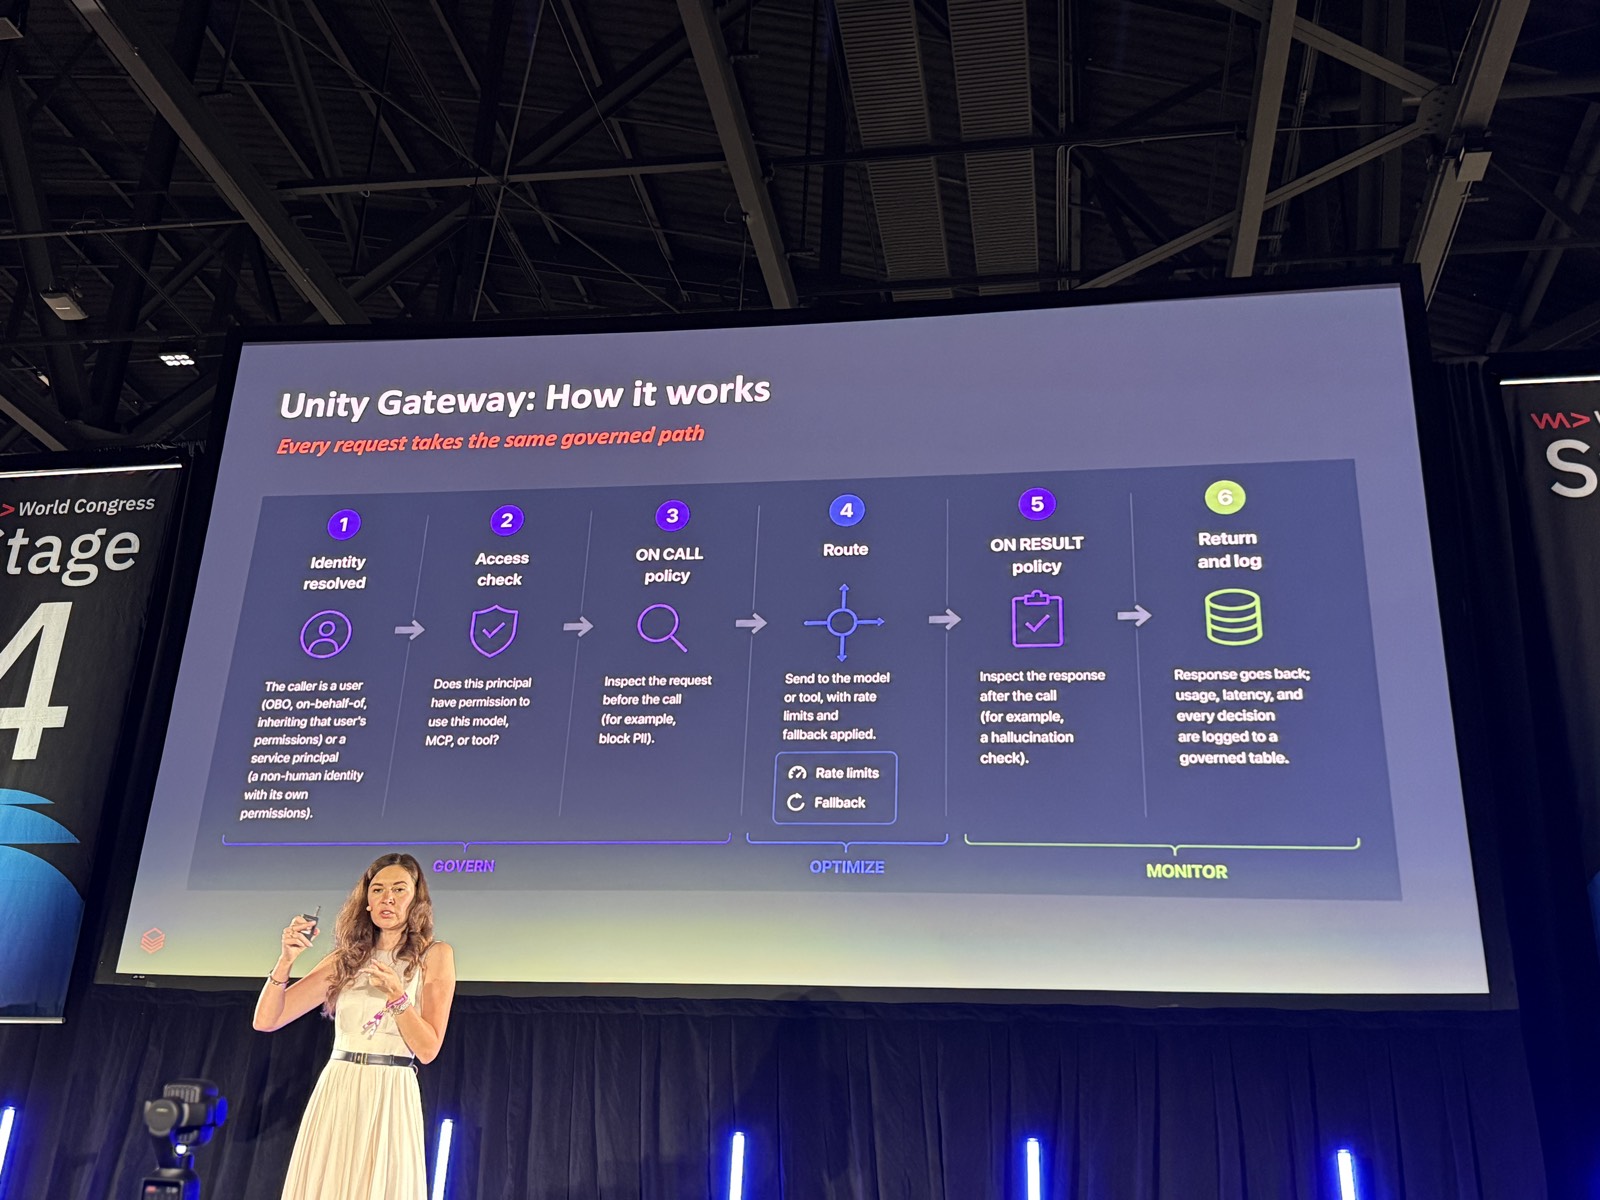
Chị giải thích cơ chế: bạn gửi request tới Unity AI Gateway. Đầu tiên gateway kiểm tra bạn có được phép dùng model đó không, có được phép lấy context từ những table nhất định không. Rồi gateway gọi model, request được route tới model phù hợp, nhận câu trả lời. Câu trả lời lại được kiểm tra xem có chứa thông tin mà user đó không được nhận hay không. Qua được rồi thì bạn mới nhận response. Toàn bộ câu hỏi và câu trả lời, toàn bộ dữ liệu này, được lưu vào system table, nên bạn có đầy đủ transparency về ai làm gì, làm thế nào.
11. Demo budget: $10,000 mỗi tháng cho phòng ban, cap $5,000 cho từng user
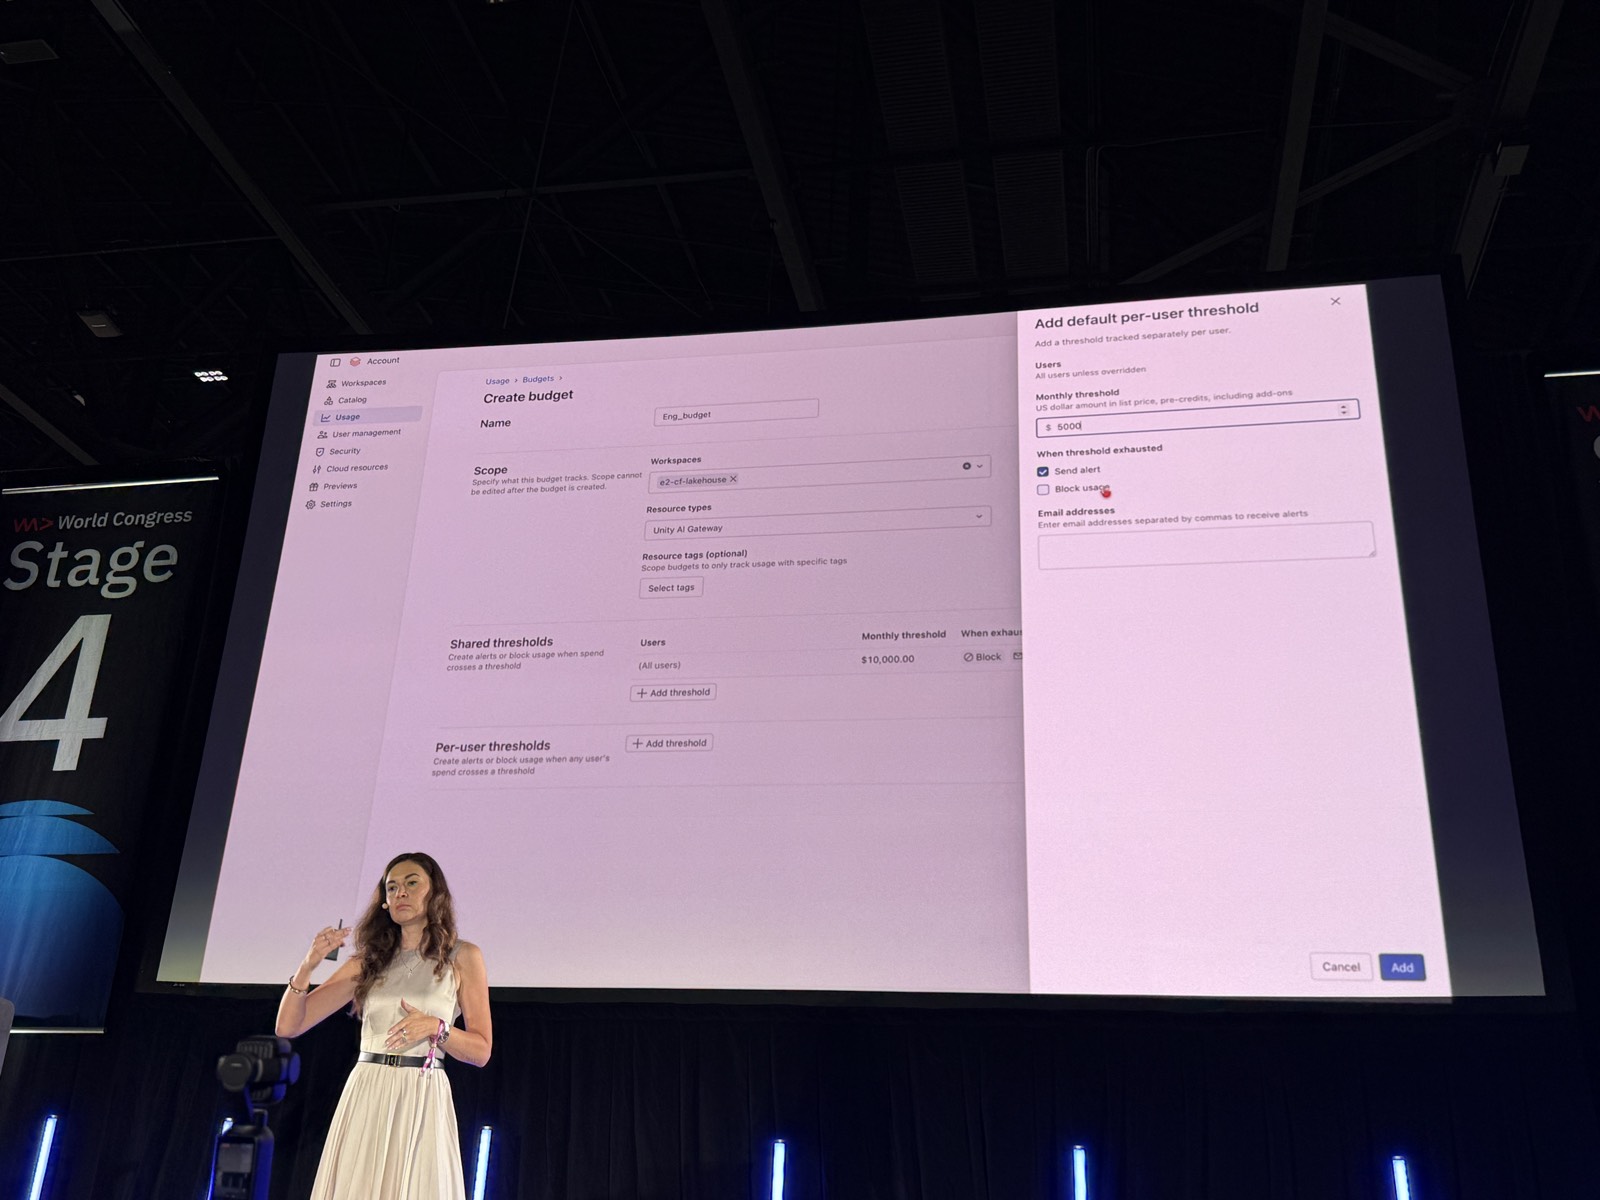
Demo đặt budget cũng khá đơn giản. Bạn vào phần govern, chọn budget, manage budget, rồi chọn Unity AI Gateway làm loại tài nguyên (entity) mà budget sẽ theo dõi. Sau đó chọn workspace. Bạn có thể định nghĩa budget cho một phòng ban cụ thể. Trong demo, chị đặt $10,000 chi tiêu mỗi tháng. Bạn có thể đặt một cảnh báo (warning), hoặc tạo budget sao cho $10,000 là mức dừng cứng (hard stop).
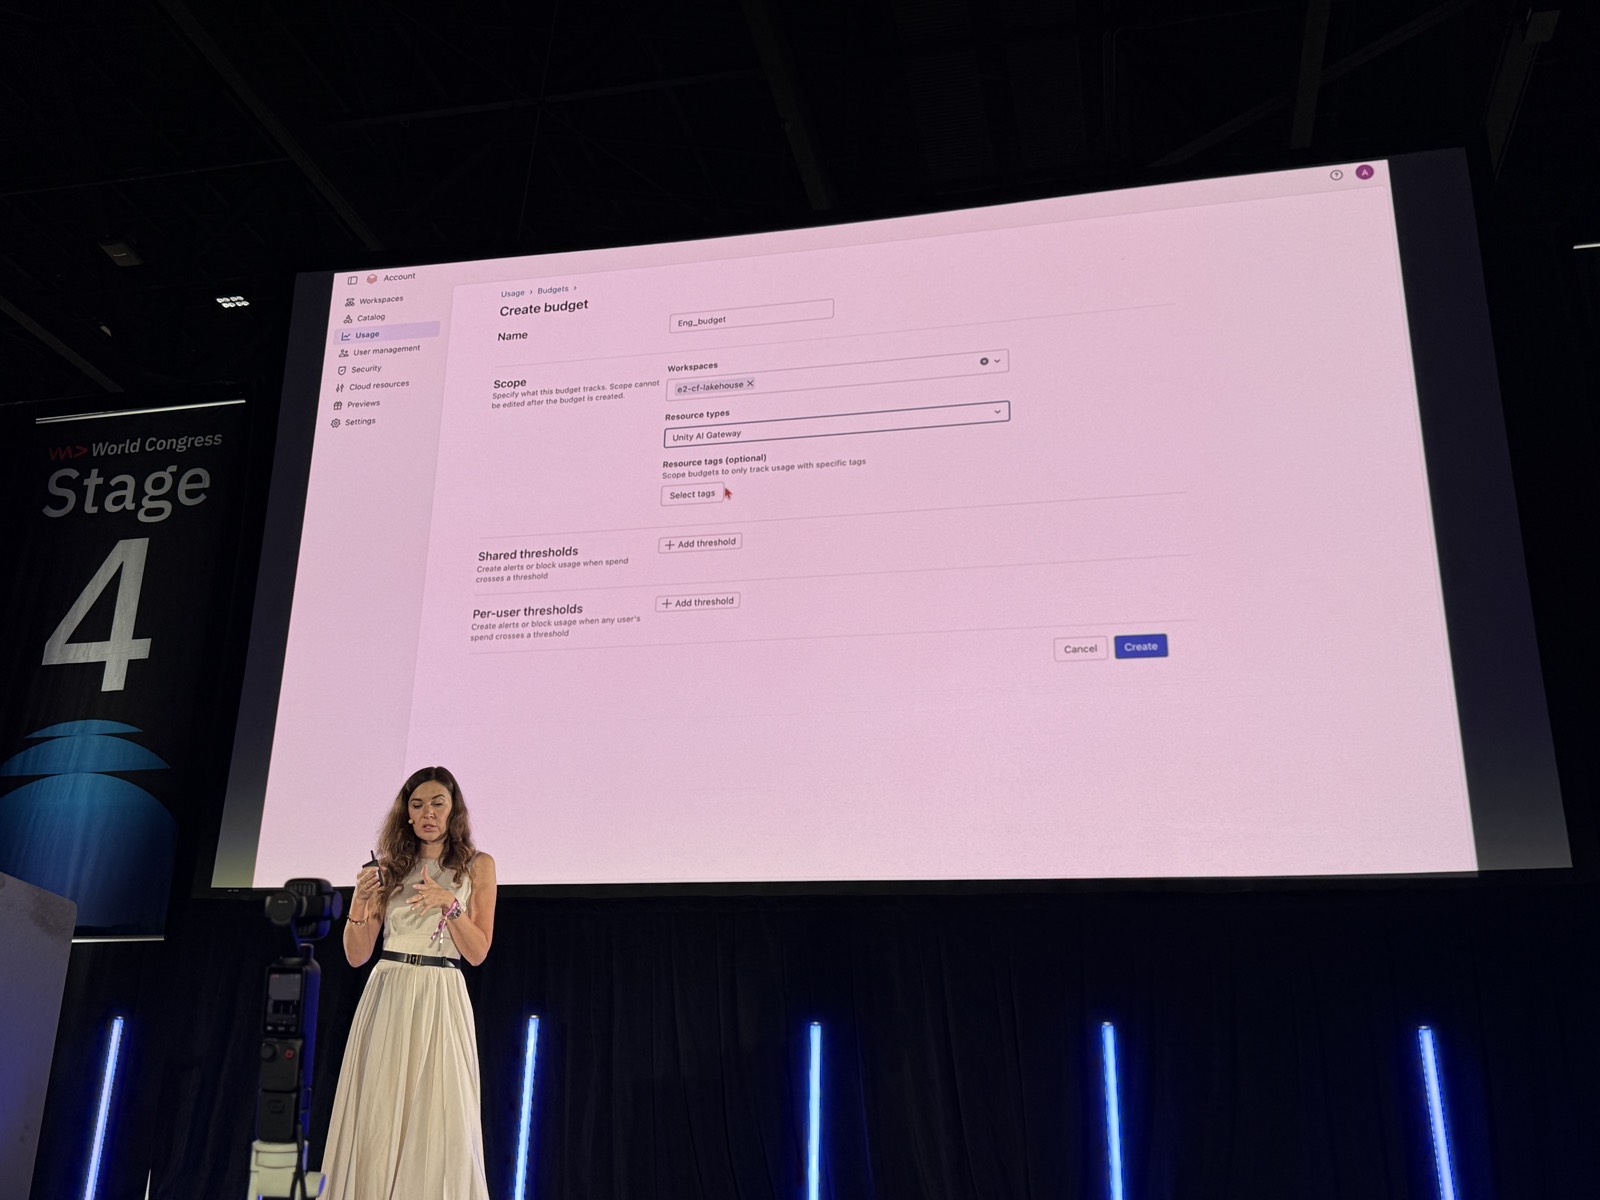
e2-cf-lakehouse, Resource types là "Unity AI Gateway", Resource tags (không bắt buộc) để chỉ theo dõi usage có tag nhất định; lưu ý scope không sửa được sau khi tạo. Bên dưới là Shared thresholds (cảnh báo hoặc chặn khi tổng chi vượt ngưỡng) và Per-user thresholds (cảnh báo hoặc chặn khi chi tiêu của bất kỳ user nào vượt ngưỡng).Rồi có thể bạn biết trong phòng mình có vài người dùng AI rất nặng. Bạn không muốn phạt cả phòng chỉ vì một người đã tiêu $8,000. Nên bạn có thể chọn đúng user đó để đặt cap, hoặc đặt cho mọi user. Ví dụ chị đặt cap $5,000, từ giờ không user nào vượt được $5,000. Như vậy bạn có control về budget. Và như chị đã nói, bạn đặt được cho từng user, từng phòng ban, từng model, nên mức kiểm soát khá chi tiết (granular).
12. Bắt đầu bằng model rẻ, chia traffic, và case study Mirakl
Cách Databricks gợi ý là bắt đầu với model giá thấp. Chị nói ai cũng có xu hướng "shiny object": có model mới vừa ra, ai cũng bàn về nó, sao mình không dùng? Có thể đó không phải giải pháp tốt nhất. Sao không thử chọn một model rẻ hơn trước? Nếu vẫn muốn thử model đắt, hãy đặt traffic split, chỉ cho nó một phần traffic, và chạy nó qua evaluation set.
Chị so sánh với chuyện tuyển người: bạn đâu có thuê một tiến sĩ (PhD) ngay từ đầu cho mọi việc. Chị nghĩ về model cũng y như vậy: đừng giao cho model mạnh nhất việc tóm tắt email của bạn, hãy dành nó cho những việc thật sự cần tới nó. Và khi model mới ra, lại chia traffic. Trong production bạn sẽ thu được thông tin mà evaluation set có thể đã bỏ sót. Nên hãy liên tục cải thiện evaluation set, liên tục lấy thêm thông tin.
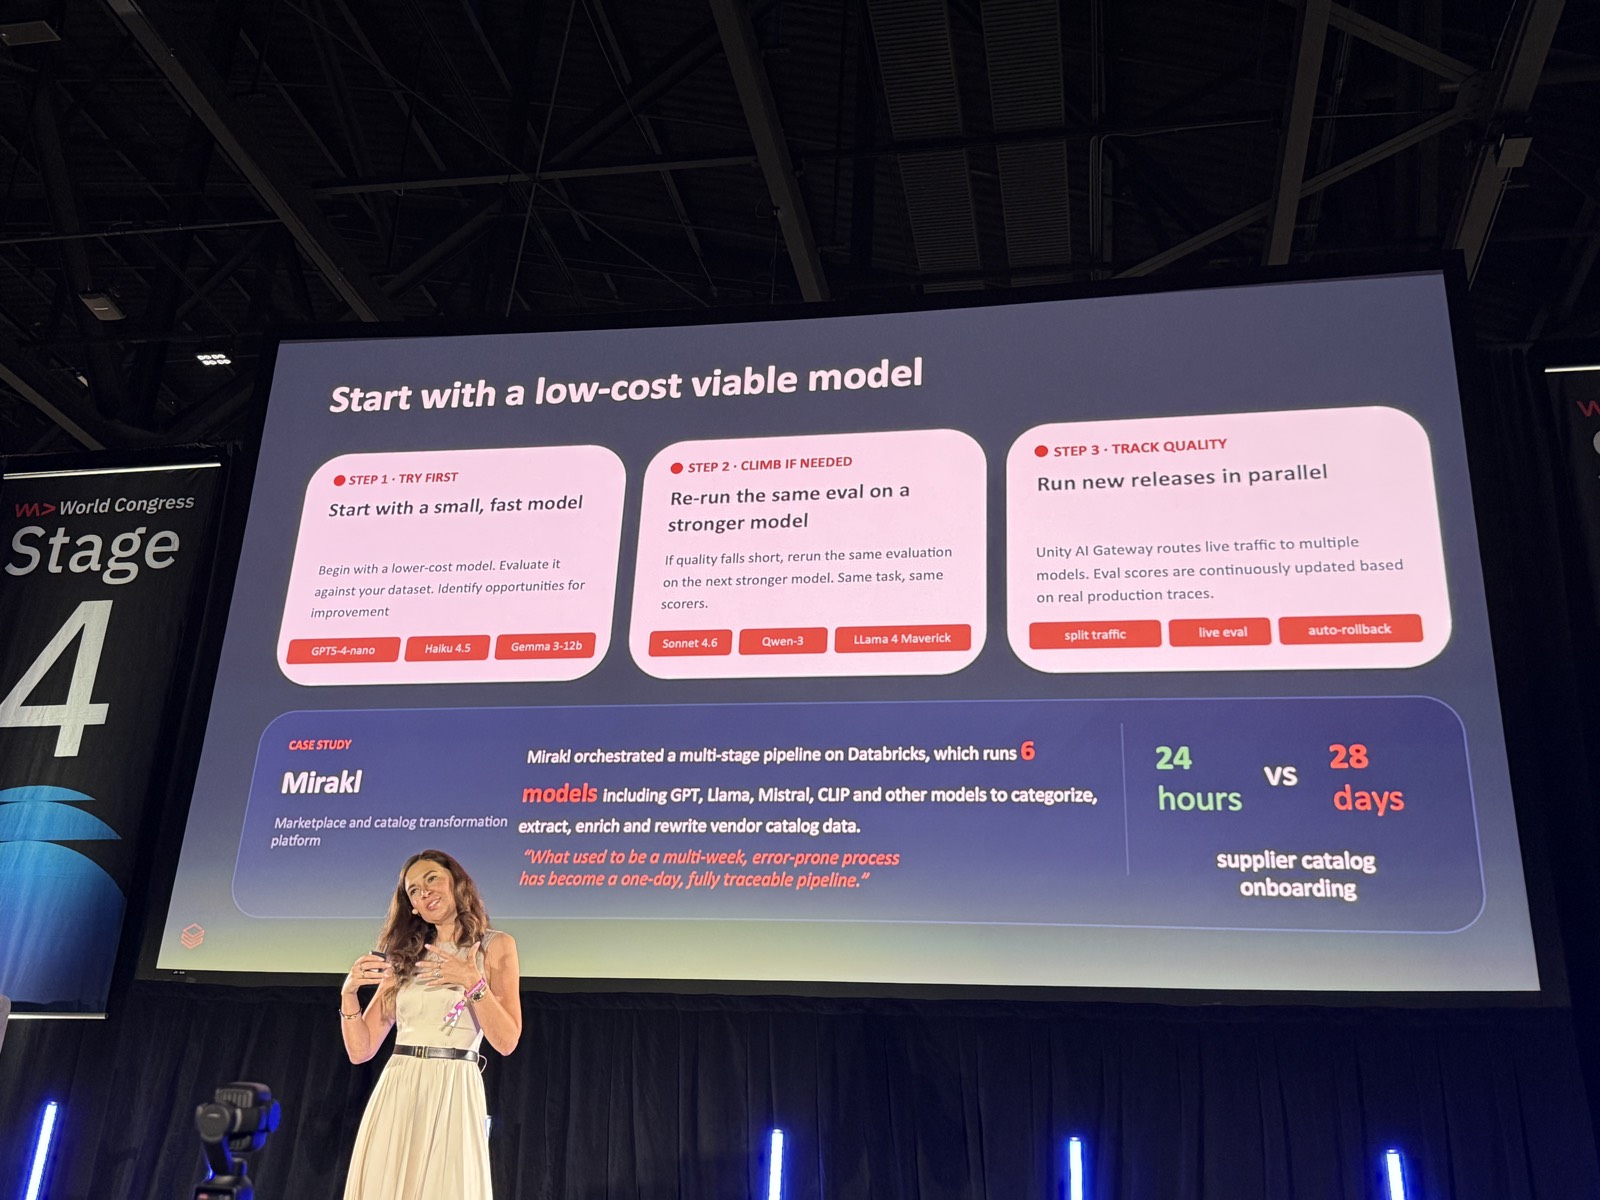
Chị kể khách hàng Mirakl đã build một data pipeline dùng nhiều model khác nhau (chị nói năm, slide ghi sáu), vì ở mỗi giai đoạn họ thấy một model khác nhau làm tốt nhất cho việc đó. Và nếu nghĩ tới coding: khi có một thử thách code, coding agent của bạn giờ thường spin up thêm sub-agent. Task lập kế hoạch có thể hưởng lợi từ model như Fable hay Opus, còn những bước thực thi nhỏ có thể giao cho Haiku hoặc một model rất đơn giản. Hãy luôn nghĩ theo cách đó.
13. Đọc kết quả eval: Opus gần như ngang model nhỏ nhưng đắt hơn hàng trăm lần
Chị quay lại cho xem các dashboard evaluation đã nhắc trước đó, tức là cách chạy nhiều evaluation cùng lúc. Đây là kết quả evaluation chị chạy cho task gán label.
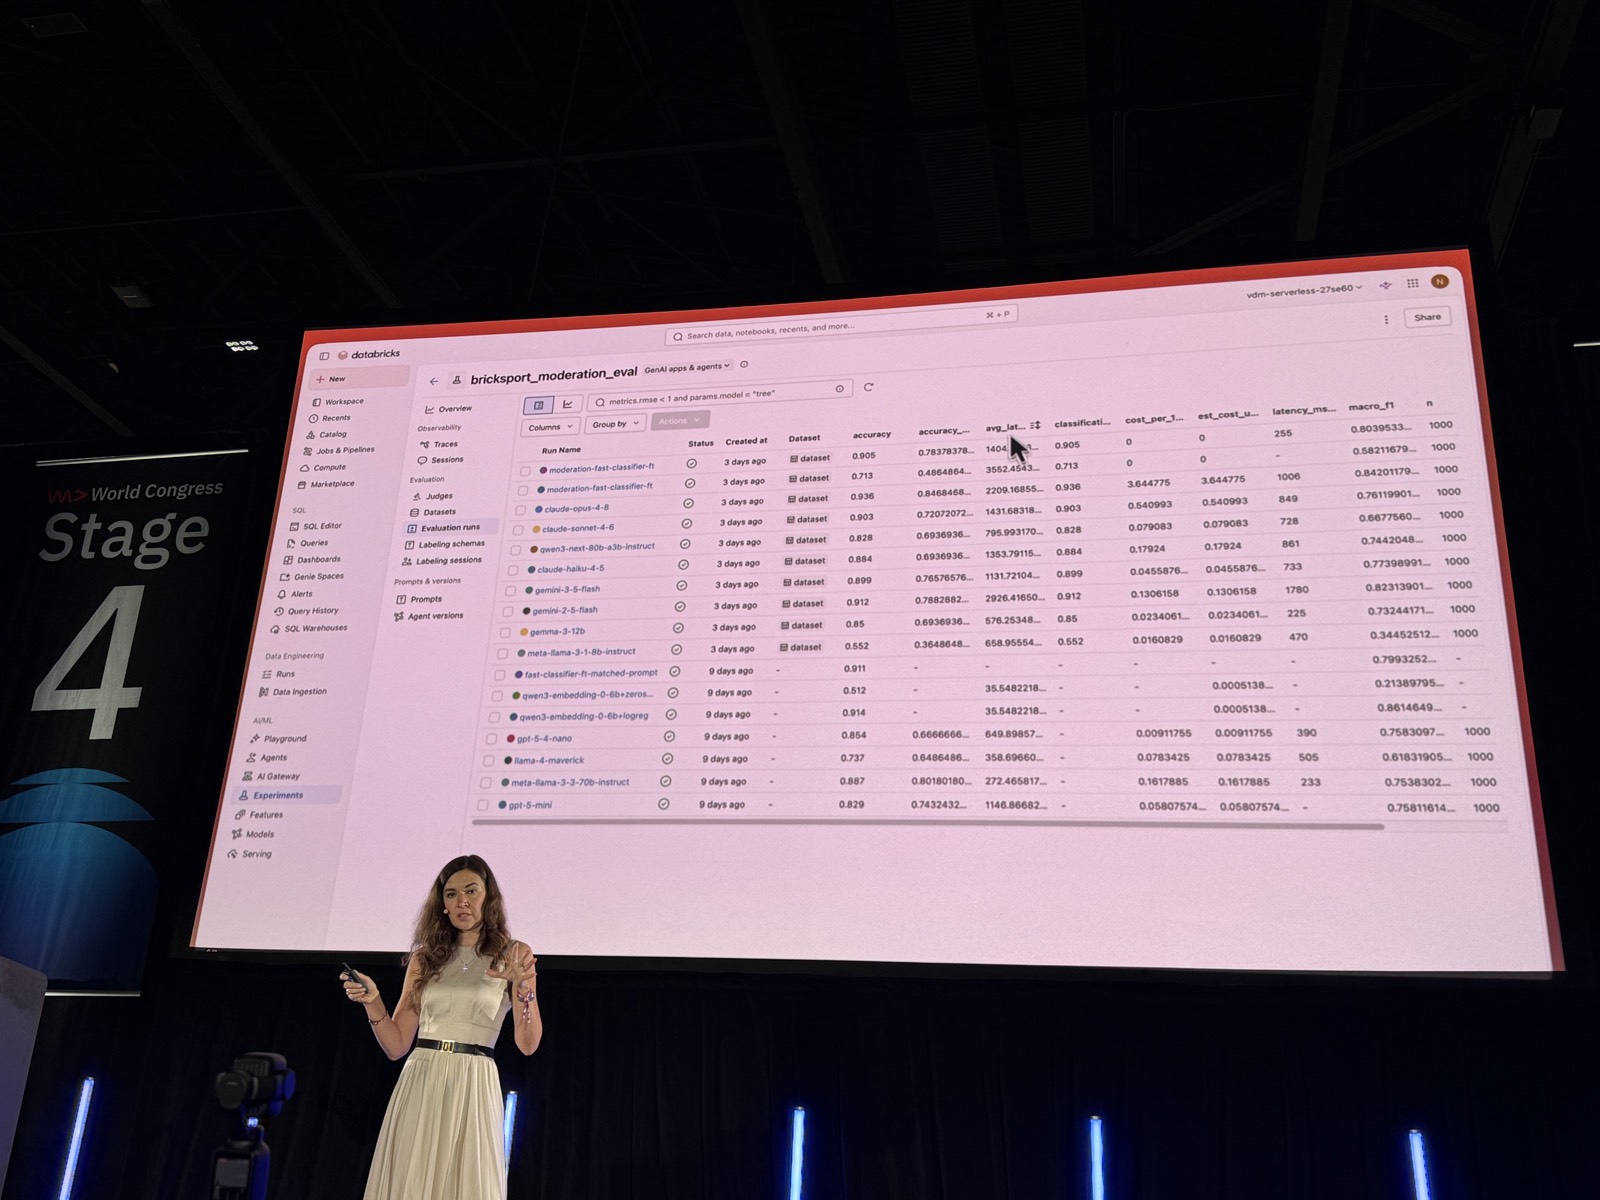
bricksport_moderation_eval trong MLflow, mục Evaluation runs: mỗi dòng một run, gồm các model như claude-opus-4-8, claude-sonnet-4-6, claude-haiku-4-5, gemini-3-5-flash, gemini-2-5-flash, gemma-3-12b, qwen3-next-80b-a3b-instruct, meta-llama-3-1-8b-instruct, meta-llama-3-3-70b-instruct, llama-4-maverick, gpt-5-4-nano, gpt-5-mini, hai run fine-tune moderation-fast-classifier-ft, fast-classifier-ft-matched-prompt, và các baseline qwen3-embedding-0-6b (zero-shot và logreg). Các cột: accuracy, avg latency, classification, cost per 1k, estimated cost, latency_ms, macro_f1, n (1000 mẫu mỗi run).Điều thú vị: xét F1 score, Opus rất gần Gemma và rất gần GPT Nano. Nhưng nhìn sang cost thì Opus cao vọt, còn mọi model khác gần như nằm phẳng sát số 0. Nhìn biểu đồ này, chị tự hỏi về accuracy: chênh lệch rất nhỏ. Với Opus accuracy khoảng 0.84, GPT-5 Nano khoảng 0.76, nhưng cost giảm từ khoảng $3,000 tới $3,500 xuống còn $9. Vậy tại sao lại trả giá cao như vậy, nhất là với một task high-velocity như content moderation, tại sao phải dùng Opus? Phần accuracy tăng thêm đó đơn giản là không xứng với chi phí.
Nhưng chị nhắc lại, mọi thứ tuỳ task. Có thể task của bạn quan trọng tới mức "không, cái này đáng tiền, vì đây là task mang lại doanh thu rất lớn". Chị cũng đã chạy thử vài model fine-tune, và thấy model fine-tune, kể cả một model nhỏ vài tỉ tham số, có thể còn chạy tốt hơn, cho kết quả tốt hơn cả Opus. Nên nếu task của bạn rất lặp lại, dễ đoán và phạm vi hẹp, cứ chọn model nhỏ rồi fine-tune. Bạn thật sự hưởng lợi từ proprietary model khi task lớn hơn và cần nhiều reasoning.
14. Step 3: Smart Routing, và Omnigent meta-harness
Điều này dẫn tới phần cuối: Smart Routing. Evaluation phát huy tác dụng khi bạn có task lặp lại. Bạn chạy chúng qua evaluation, và khi model mới ra, bạn evaluate lại và đổi. Nhưng thách thức là rất nhiều khi mình giải một bài toán kiểu one-off, và mình không thể bỏ thời gian build evaluation cho nó. Ví dụ khi bạn đang build một thứ gì đó nhanh, rất nhiều developer mặc định chọn luôn Opus. Chị nói đó chính là lý do usage Opus của chị cao như vậy: chị không muốn tốn thời gian nghĩ "liệu Sonnet có cho kết quả tốt không", chị cứ chọn Opus là xong. Với doanh nghiệp, đó có lẽ không phải cách tốt nhất, vì nhân lên với tất cả mọi người, hoá đơn sẽ rất lớn.
Đó là chỗ smart routing xuất hiện. Smart routing đang ở beta. Bạn dùng smart routing trong gateway: nó nhìn vào request đi tới rồi chọn model, chọn model tốt nhất cho request đó, đúng theo tinh thần chị vừa giải thích.
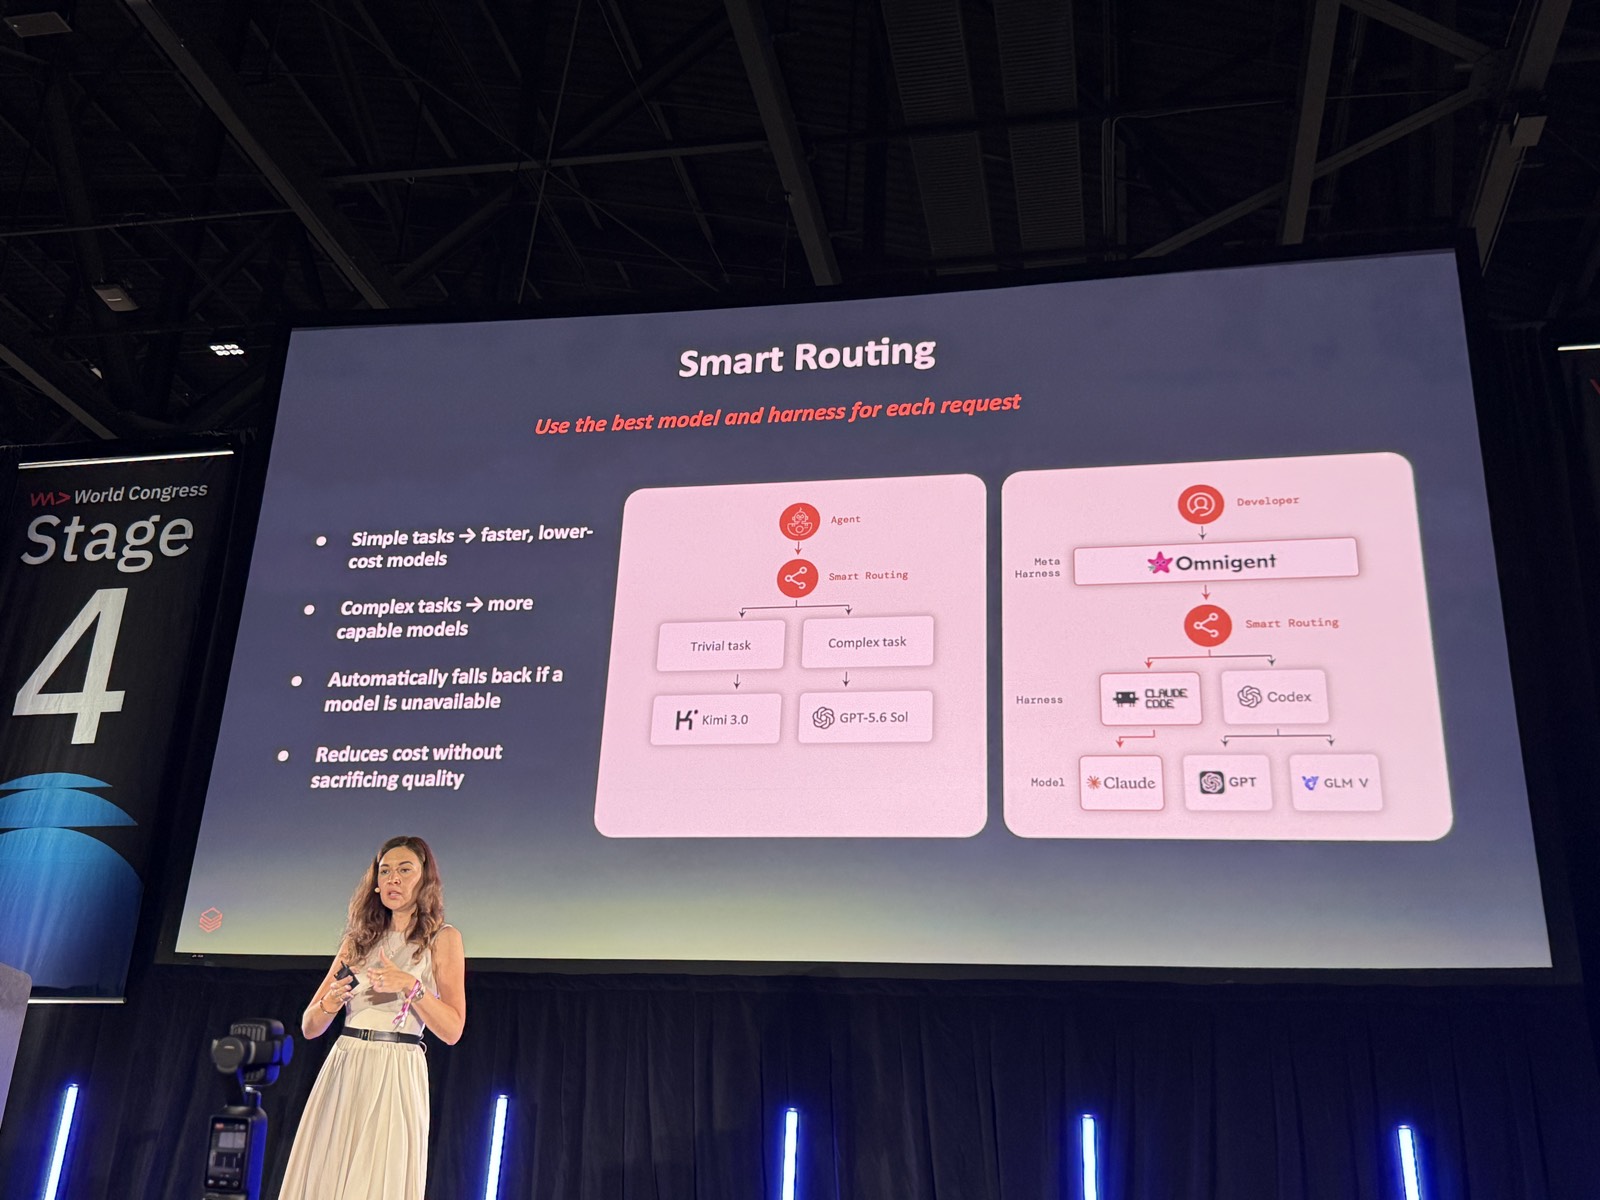
Nhưng lấy ví dụ coding, chị nói nó thật ra không chỉ là chọn model, mà gần như là chọn cả engine lẫn harness. Đó là lý do Databricks giới thiệu Omnigent, một meta-harness. Khi bạn đang code, đôi khi bạn thấy "cho task này mình muốn dùng Claude Code của Anthropic", hoặc "không, task này mình muốn thứ gì đó thật nhanh, mình muốn dùng Codex". Đó là lúc dùng Omnigent, vì nó trở thành một meta-harness nằm trên các harness của bạn.
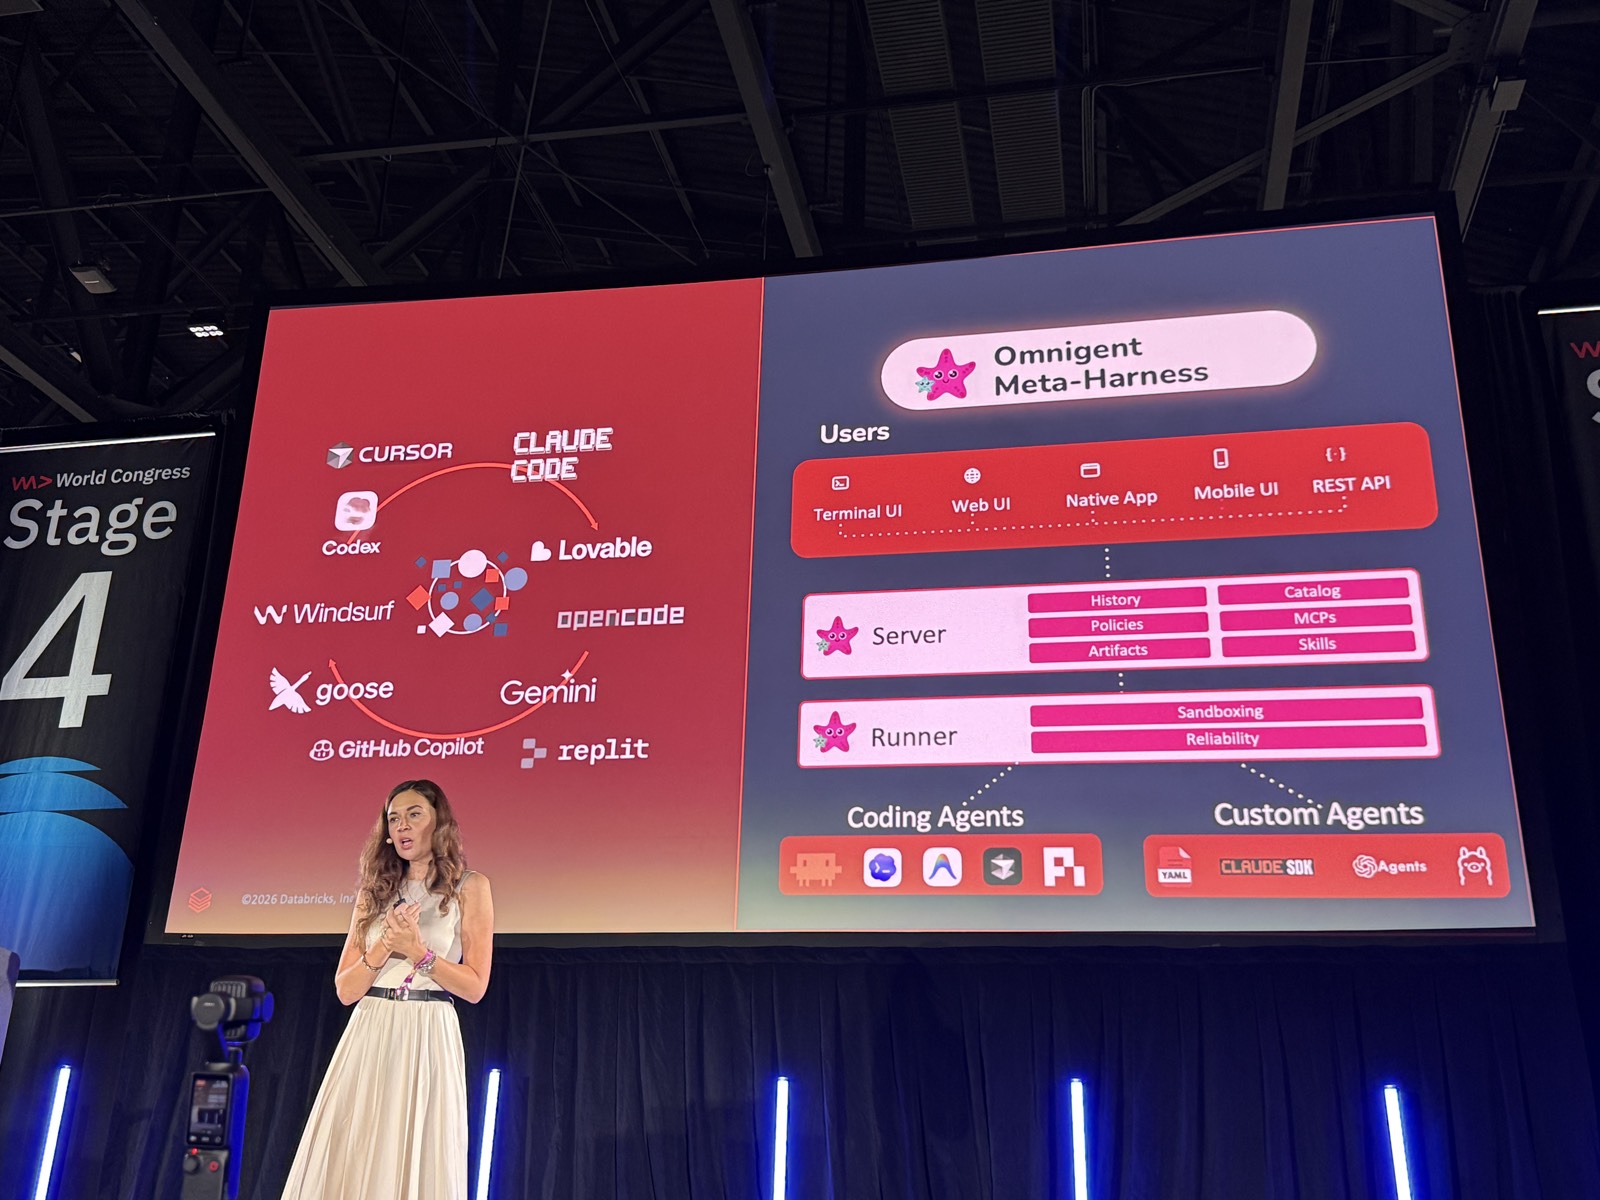
Nhìn vào kiến trúc, Omnigent cho thêm các lớp kiểm soát cho việc coding. Ở đó bạn đặt policy, đặt budget. Chị kể kinh nghiệm riêng: khi build, chị hay thấy agent bị kẹt trong vòng lặp, cứ retry một tool nào đó, chi phí tăng mãi mà không có hành động nào tiến triển. Nên chị đặt số vòng retry: được retry vòng này tối đa bao nhiêu lần trước khi dừng, được gọi một tool cụ thể bao nhiêu lần. Có rất nhiều kiểm soát ở mức task nhỏ như vậy mà bạn đặt được trong Omnigent, và bạn đặt chúng ở mức server, còn client là nơi bạn chạy các agent.
Chị tóm lại cách nghĩ về hai sản phẩm: Unity AI Gateway là nơi bạn chọn model cho từng request riêng lẻ, còn Omnigent là nơi quản lý việc thực thi của agent, tức là trajectory của các agent khác nhau trong lúc bạn build.
15. Demo Omnigent: Polly tự chọn model, policy $10 và cảnh báo mềm $1
Để dễ hiểu hơn, chị làm một demo rất đơn giản. Omnigent là open source, bạn cài được trên máy; trong demo chị dùng bản managed. Chị chọn smart routing và chọn Polly, một agent multi-harness nên có thể gọi nhiều harness khác nhau. Chị giao task: build một app đơn giản.
Đầu tiên Polly nhận diện: "đây là planning task, mức moderate, vì chị ấy muốn build một app đơn giản", và phác ra cách nó sẽ build app. Ngay lúc đó chị thấy được đã tốn bao nhiêu tiền. Trong Omnigent chị cũng đặt được policy riêng. Cho riêng task coding này, chị đặt policy không chi quá $10: một app rất đơn giản thì $10 là quá đủ. Và chị muốn nhận cảnh báo nếu chi quá $1.
Rồi chị bảo: "ok, specification tốt đấy, đi build đi". Vì đây là app rất đơn giản, Omnigent xác định dùng model Sonnet và xếp task vào mức moderate. Khi bắt đầu build, vì build đơn giản nên chỉ có một agent, chị thấy được trên biểu đồ. Nhưng bạn cũng thấy nó dừng lại, vì đã chạm mức $1. Giờ nó hỏi chị: "bạn có muốn tiếp tục không?", vì chị có đặt soft warning. Chị trả lời: "ok, không sao, tôi thấy tiến độ của bạn rồi, cứ build tiếp". Chị có thể kiểm tra chi phí bất cứ lúc nào. Toàn bộ việc dựng app tốn hơn $1 một chút.
Nếu có nhiều agent, bạn sẽ thấy Polly chia việc ra thành nhiều agent, và mỗi sub-agent dùng model khác nhau tuỳ task nó đang giải. Tiếp theo chị yêu cầu: "đi audit những gì bạn vừa build, investigate đi". Omnigent xếp việc này là complex task, và giờ nó dùng tới Opus. Bạn thấy nó spin up agent thứ hai, agent thứ hai được dựng lên, rồi validate: mọi thứ ổn, tìm thấy vài issue, và kết thúc như vậy.
Cuối cùng chị có ba task: planning task, building task và testing task. Tuỳ từng task, chị không phải làm cái bài tập trí óc "chọn model nào", chị chỉ cần dùng smart routing.
16. Key takeaways và tài nguyên để bắt đầu
Key takeaways của Viktoria: thứ nhất, đừng mặc định dùng model thông minh nhất. Hãy thật sự build evaluation set và xác định cái gì hợp lý về return on investment. Thứ hai, govern việc dùng model: đặt spend policy, chia traffic giữa các model. Thứ ba, khi có một task mới mà bạn chỉ muốn thử nghiệm, hãy dùng smart routing.
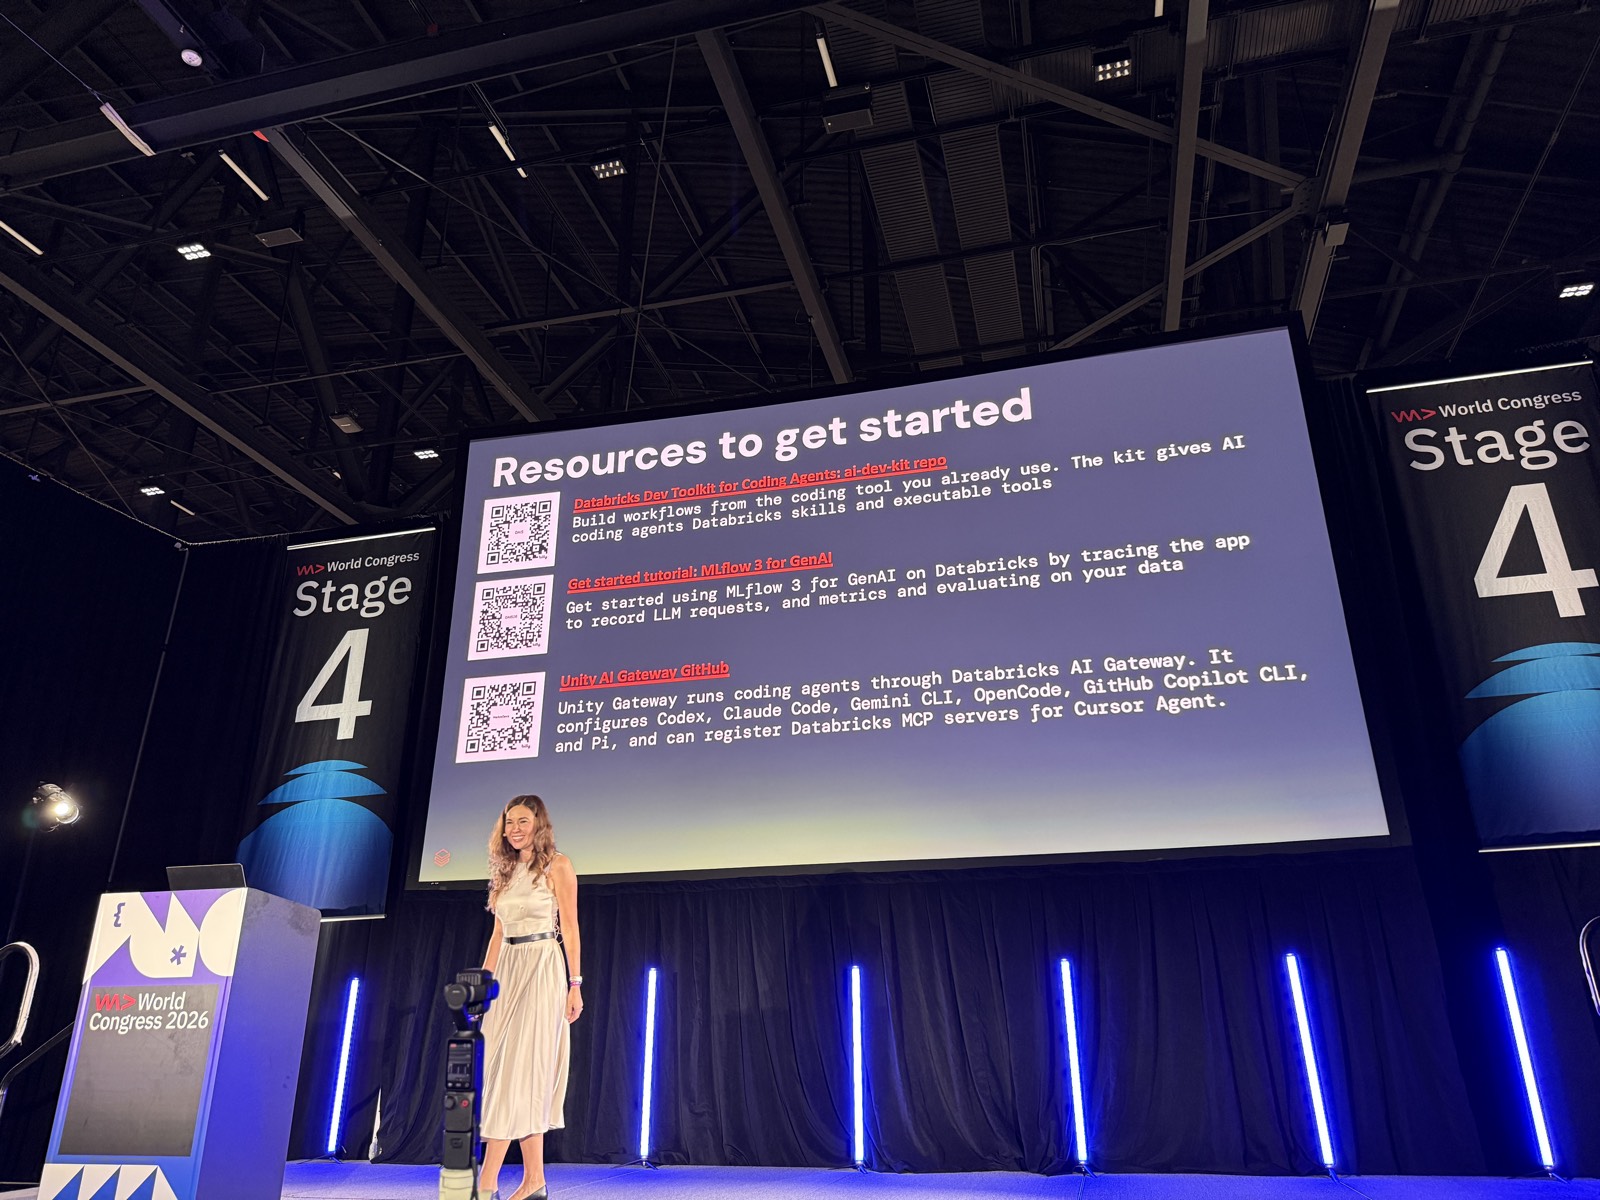
Rồi chị đưa tài nguyên để bắt đầu. Một thứ chị thật sự thích là Databricks Dev Toolkit: chị đưa nó cho coding agent của mình, và agent build được những demo tuyệt vời, nên chị không phải tự build. Làm việc và build trên Databricks nhờ vậy rất dễ. MLflow 3 là open source, bạn dùng được kể cả khi không dùng Databricks. Omnigent cũng vậy: chị bổ sung rằng omnigent.ai, harness đó cũng là open source, bạn có thể tự chạy và thử.
Chị cảm ơn khán giả, đùa hỏi ban tổ chức "cho tôi thêm thời gian được không? Không à, okay", rồi nói chị sẽ đứng lại ở đây nếu ai có câu hỏi. Người dẫn chương trình cảm ơn chị và kết thúc session.
Nguồn và link
- Trang session chính thức WeAreDevelopers
- Unity AI Gateway: trang sản phẩm Databricks AI Gateway · AI Gateway docs
- System tables và budgets: System tables · Budgets · Genie
- MLflow: mlflow.org · github.com/mlflow/mlflow · MLflow for GenAI docs · Get started: MLflow 3 for GenAI · Evaluate and monitor
- Omnigent: omnigent.ai · github.com/omnigent-ai/omnigent
- Databricks Dev Toolkit: github.com/databricks-solutions/ai-dev-kit
- Số liệu AI spend trên slide: Ramp AI Index, August 2026
- Cursor Composer: cursor.com/blog/composer (chi tiết "fine-tune từ Kimi" và "giảm 86% cost per task" là lời speaker, chưa tìm được nguồn chính chủ xác nhận)
- Case study Mirakl: databricks.com/customers/mirakl
- Chưa tìm được nguồn: repo GitHub chính chủ "Unity AI Gateway" trên slide cuối; các số 81% doanh nghiệp dùng ít nhất năm model, open-weight rẻ hơn 78%, khoảng cách ba tháng.
Related talks
Tools, Sandboxes, and the Plumbing of Agentic Development
Oleg Šelajev · Docker · 34 min
Dựng một coding factory để thoát khỏi vai điều phối toàn thời gian: mỗi agent một role, CLI và model riêng, chạy trong sandbox, dùng kits và skills.
Parallelize your development with GitHub Copilot
Pamela Fox · Microsoft · 32 min
Chạy nhiều coding agent song song theo ba chiều environment, timing, ownership: worktree, port, staging riêng từng branch, background agents và sub-agents.
Acquired Live Interview: Amjad Masad (Co-founder & CEO, Replit)
Amjad Masad · Replit · 27 min
Amjad Masad kể hành trình Replit: từ Python trong browser tới Replit Agent, doanh thu 2 lên 10 triệu, và vì sao switching costs nằm ở rails quản lý agent.