Understanding LLM Architectures: Inside the Design of Modern Models
Đọc LLM hiện đại theo component (GQA, MLA, local attention, MoE, Gated DeltaNet) và biết phải đo gì khi swap model trong production.
1. Đọc một model theo từng component: GPT-2, Llama 3, Mistral
Phần này Jofia đi qua bảng "Modern models by their components". Ý của slide: mỗi model có một cái tên khác nhau, nhưng nếu tách ra theo component thì ở cột nào cũng là cùng một câu hỏi engineering. Bảng có năm cột: sequence mixing (cách các token "nhìn" nhau, tức là attention), position (cách model biết thứ tự token), feed-forward (lớp FFN sau attention), normalization, và cột cuối "what changed".
Chị bắt đầu từ GPT-2 làm baseline. GPT-2 dùng multi-head attention (MHA) cổ điển, học position embedding (learned absolute position, mỗi vị trí một vector được học), và dùng một lớp FFN dense với GELU, normalization là LayerNorm. Đó là "baseline decoder Transformer", điểm xuất phát để so mọi thứ đến sau.
Rồi tới Llama 3: cái gì đổi? Chị nói thẳng: chỗ đổi là shape của KV. Llama 3 dùng grouped-query attention (GQA), tức là nhiều query head dùng chung một cặp key/value head, nên KV được chia sẻ. Cùng lúc đó FFN chuyển sang dạng gated hiện đại (SwiGLU), position chuyển sang RoPE, normalization sang RMSNorm. Slide tóm cột "what changed" của Llama 3 là "KV sharing + gated FFN".
Tiếp theo là Mistral 7B. Mistral cũng dùng GQA, và thêm sliding window attention: mỗi token chỉ attend vào một cửa sổ các token gần nó thay vì toàn bộ lịch sử. Kết quả slide ghi là "faster decode, windowed attention". Chị nhấn: nhìn bảng theo hàng dọc là thấy được sự thay đổi kiến trúc qua từng model.
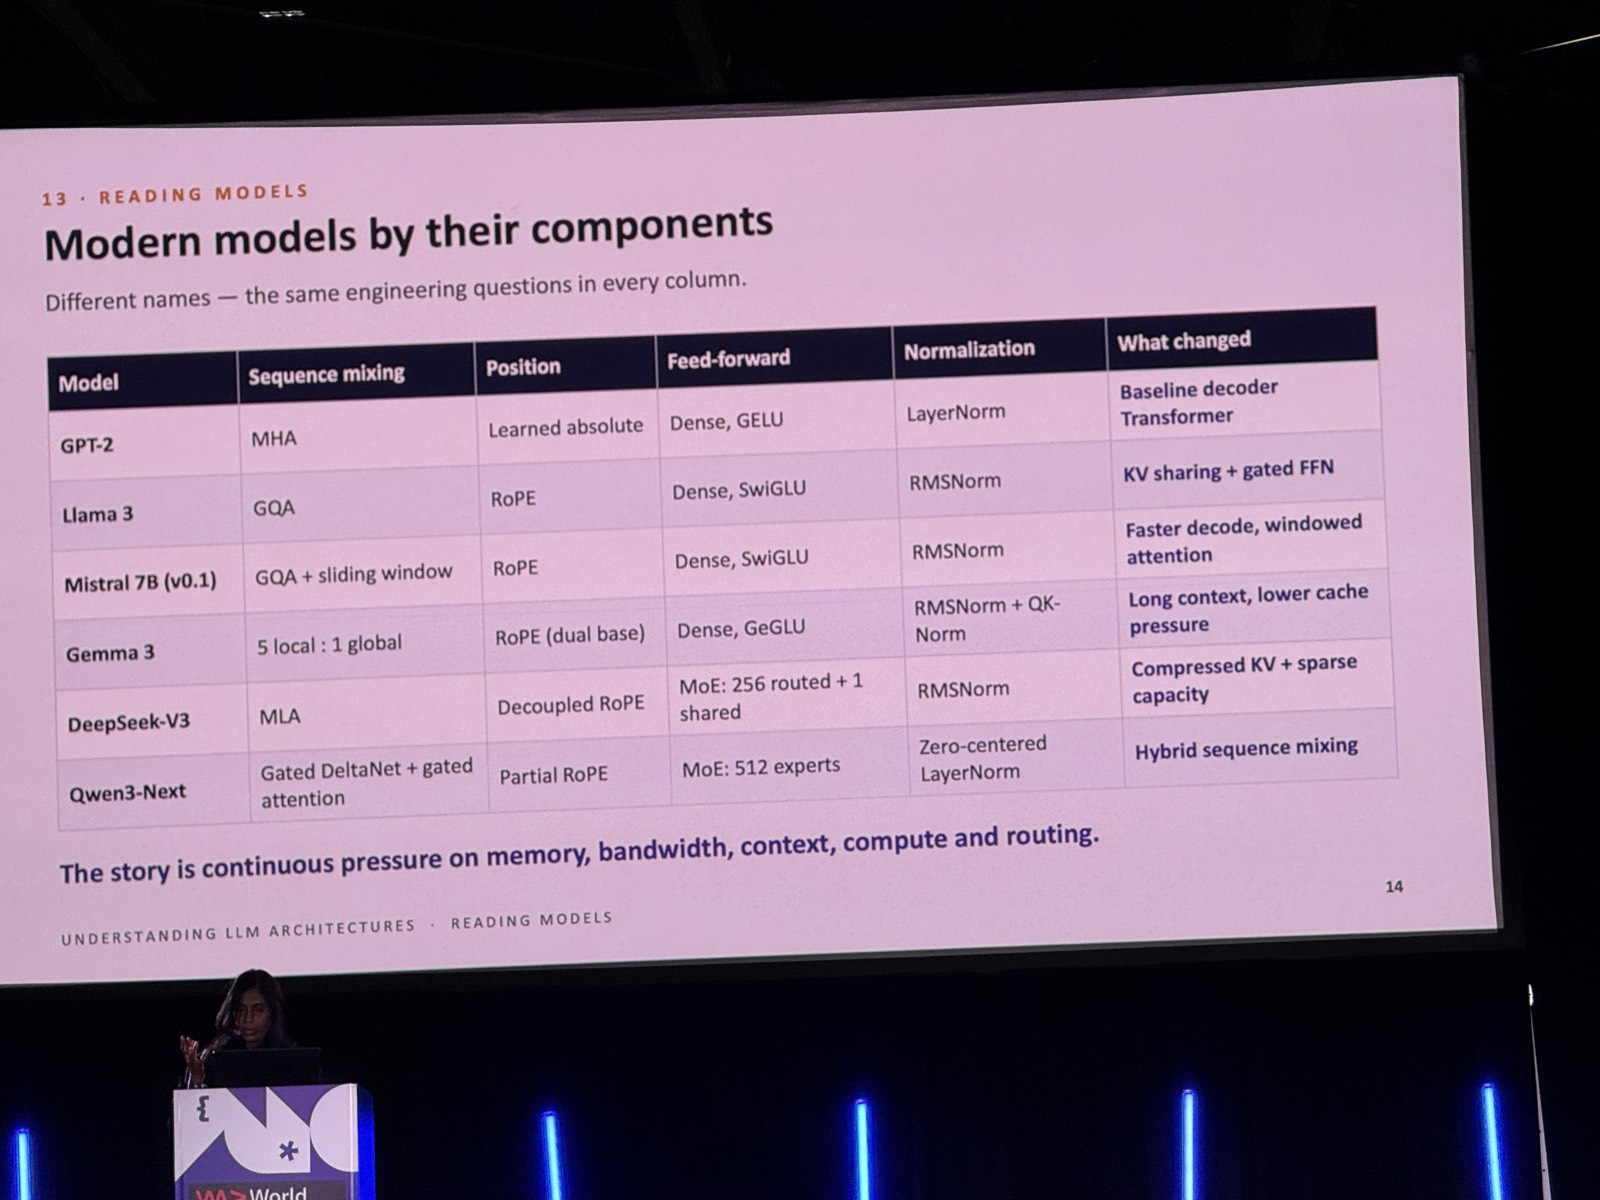
Hai hàng Gemma 3 và DeepSeek-V3 trên slide Jofia để khán giả tự đọc, nhưng chúng quay lại ở phần production phía dưới: Gemma 3 là ví dụ của cách trộn local/global attention, còn DeepSeek-V3 là ví dụ của multi-head latent attention (MLA), nén KV thành một latent vector nhỏ hơn, cộng với Mixture-of-Experts. Nguồn gốc từng kỹ thuật: GQA (Ainslie et al., 2023), RoPE (RoFormer), SwiGLU (GLU Variants Improve Transformer), RMSNorm (Zhang & Sennrich, 2019), sliding window ở Mistral 7B paper.
2. Qwen3-Next và Gated DeltaNet: có cần full attention không?
Có một model chị nói là chưa bàn kỹ trong talk: Qwen3-Next. Qwen3-Next đi một hướng khác, dùng Gated DeltaNet. Cách chị giải thích: thay vì mỗi token mới phải nhìn lại từng token trước đó (như attention thường làm), model giữ một running state ở dạng compact, giống như một bản nén của những gì đã đọc. Token mới chỉ cập nhật và đọc từ state đó.
Chị nói bản thân chuyện này đã là một cuộc thảo luận kiến trúc riêng. Câu hỏi đằng sau là: chúng ta có thật sự cần full attention ở mọi lớp không? Qwen3-Next trả lời bằng một thiết kế hybrid: phần lớn các lớp là Gated DeltaNet (linear attention, state cố định), xen kẽ một số lớp gated attention đầy đủ. Đó là ý của cột "hybrid sequence mixing" trên bảng.
Nguồn: paper Gated Delta Networks: Improving Mamba2 with Delta Rule, và model card Qwen3-Next-80B-A3B-Instruct (mô tả layout hybrid Gated DeltaNet + gated attention và MoE 512 experts).
3. Swap model trong production: long-context RAG và KV cache
Rồi chị chuyển sang phần production workload. Chị nhắc lại điều đã nói từ trước trong talk: trong thực tế chúng ta liên tục swap model. Vậy khi swap, chúng ta thực sự đạt được gì? Slide đặt câu hỏi: "When you swap the model, which bottleneck moves?", với dòng phụ: kiến trúc không bảo đảm kết quả tốt hơn, nó chỉ cho bạn biết phải đo ở đâu.
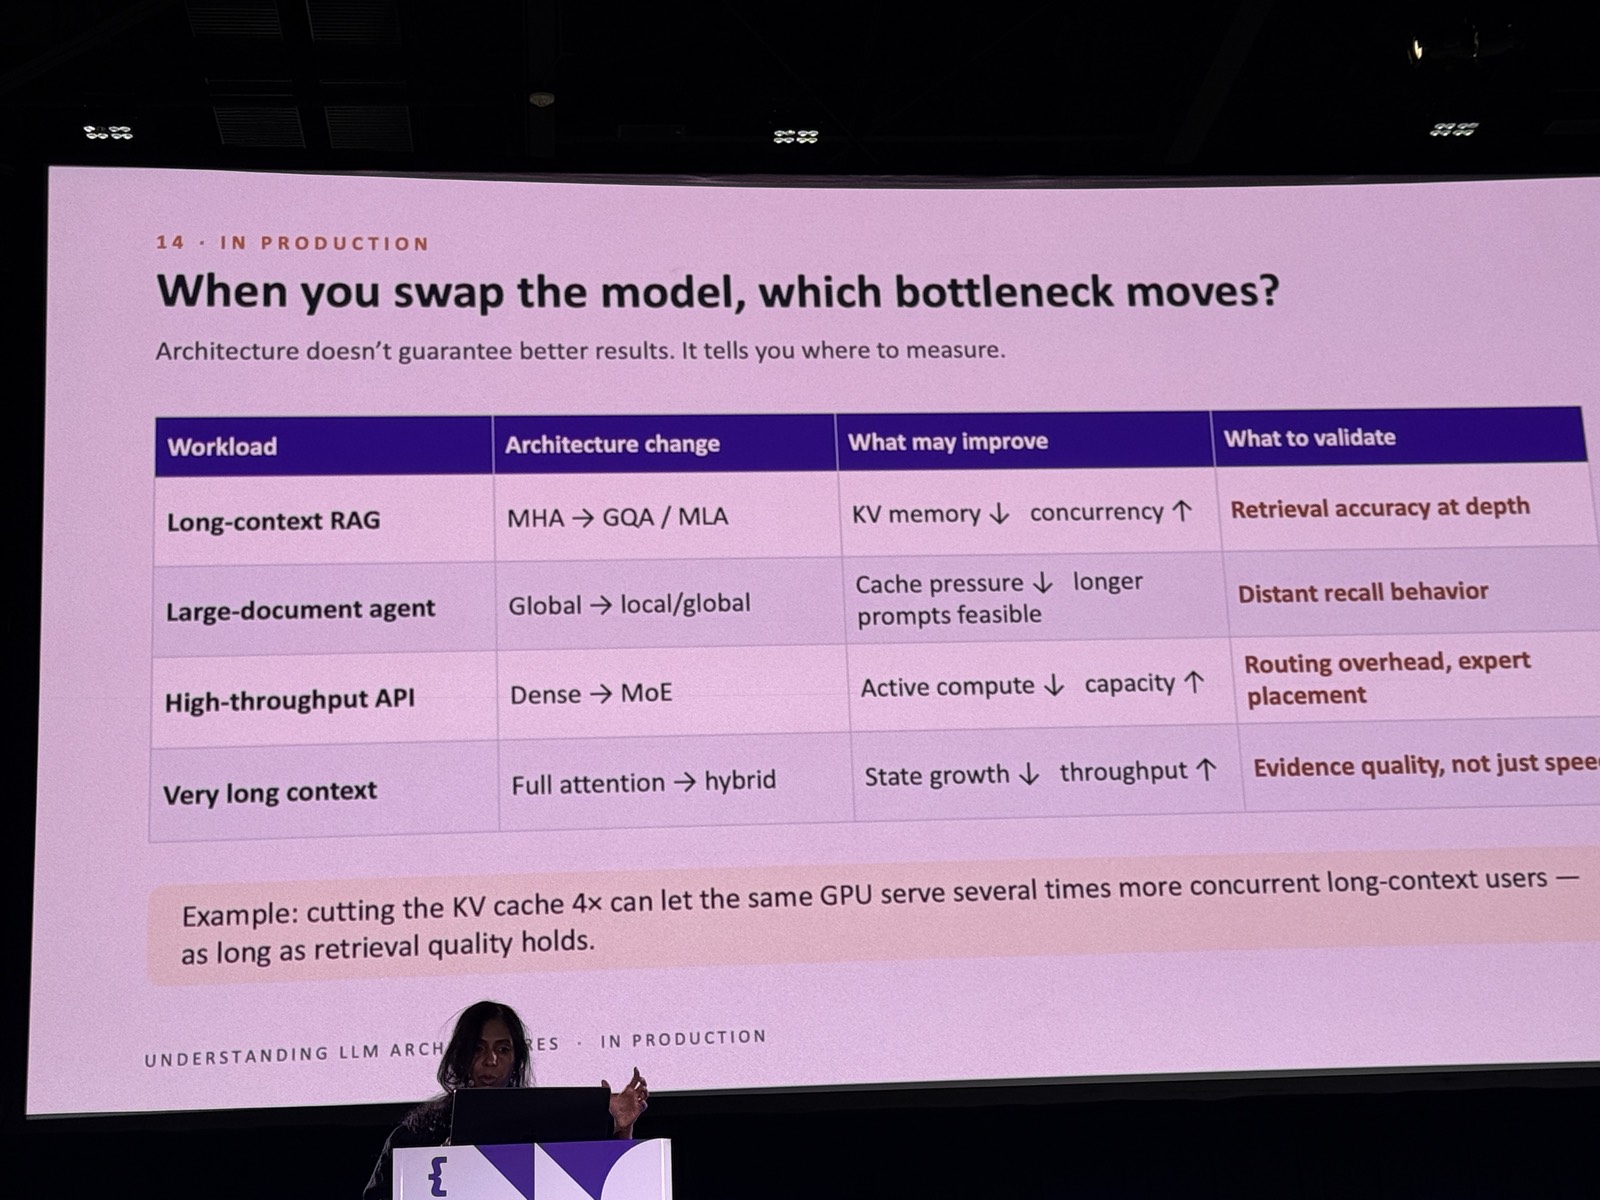
Ví dụ đầu tiên là long-context RAG. Prompt của một hệ RAG rất dễ tích lũy tới hàng chục nghìn token (các đoạn tài liệu retrieve được nhét vào context). Với hệ như vậy, giữ cho KV cache hiệu quả là việc quan trọng. Đó là lúc có thể nghĩ tới một thay đổi kiến trúc: từ multi-head attention sang grouped-query attention, hoặc sang multi-head latent attention.
Nó giúp gì? Nó kéo KV cache xuống. Nhưng chị cảnh báo ngay: vì chúng ta đang giảm phần memory đó, chúng ta phải validate lại retrieval accuracy, đặc biệt ở độ sâu (thông tin nằm sâu trong một context dài có còn được lấy ra đúng không).
Để thấy con số trong khung "cắt KV cache 4 lần" cụ thể ra sao, dưới đây là một phép tính minh hoạ dùng config công khai của Llama 3 8B: 32 layer, 32 query head, 8 KV head, head dimension 128, lưu bằng fp16 (2 byte). KV cache mỗi token = 2 (K và V) × 32 layer × 8 KV head × 128 × 2 byte = 128 KB. Nếu cùng model đó dùng MHA (32 KV head) thì là 512 KB mỗi token, tức gấp 4. Ở context 128K token, một request tốn khoảng 16 GB KV cache với GQA so với khoảng 64 GB với MHA. Đó chính là loại chênh lệch quyết định một GPU chứa được bao nhiêu user long-context cùng lúc. Nguồn MLA: DeepSeek-V2 paper và DeepSeek-V3 technical report; config Llama 3 trong The Llama 3 Herd of Models.
4. Large-document agent: từ global sang local attention, và recall
Ví dụ thứ hai là document-heavy agent, agent phải xử lý tài liệu dài và lịch sử dài. Ở đây local attention hoặc hybrid attention có thể giảm chi phí xử lý các tài liệu dài, lịch sử dài. Gemma 3 trong bảng ở phần 1 là một ví dụ: cứ năm lớp local (mỗi token chỉ nhìn một cửa sổ gần) thì mới có một lớp global.
Nhưng chị nhấn lại một điều, và đây là thông điệp xuyên suốt talk: mỗi khi đổi kiến trúc, mỗi khi swap model, chúng ta phải thật sự hiểu cái gì đang chạy bên dưới. Ví dụ với tài liệu dài, nếu chúng ta chuyển sang một model mà kiến trúc đổi từ global layer sang local attention, thì model đó không còn giữ toàn bộ memory nữa. Vậy chúng ta phải test recall behavior: model có còn lấy được thông tin cũ, thông tin nằm xa ở phần trước của tài liệu hay không.
Kết luận của chị cho phần này: khi swap model, hiểu kiến trúc là việc quan trọng. Chỉ khi hiểu kiến trúc, chúng ta mới biết mình đang đánh đổi cái gì và cái gì cần được evaluate trong production. Tham khảo kiến trúc Gemma 3: Gemma 3 Technical Report.
5. High-throughput API, very long context và agentic workflow
Tương tự với high-throughput API. Ở đây là chuyển sang expert model, tức Mixture-of-Experts: mỗi token chỉ đi qua một vài expert thay vì toàn bộ FFN dense, nên active compute giảm và capacity tăng. Đây là các workload real-time, ví dụ customer support. Cái chúng ta muốn tối ưu ở đó là throughput, vì bản chất nó là bài toán throughput, nên một model nhỏ là đủ tốt cho chỗ đó. Cái phải kiểm, theo slide, là routing overhead và expert placement (expert nằm ở GPU nào, phải gửi token qua lại bao nhiêu).
Ở đầu ngược lại là các tài liệu khoa học hay tài liệu review pháp lý. Ở đó chúng ta thật sự cần chiều sâu của tài liệu, tức là cần long-context behavior tốt. Nếu chuyển model (slide gọi là từ full attention sang hybrid, như Qwen3-Next ở phần 2), thì phải validate như chị nói ở trên. Cột cuối của slide nhấn: evidence quality, không chỉ tốc độ.
Vì vậy chúng ta cần biết rõ evaluation framework của mình phải gồm chính xác những gì khi swap model. Và với agentic workflow, state lại càng quan trọng: agent gọi nhiều tool call, đọc nhiều tài liệu, nên KV cache cứ tiếp tục lớn lên, và chúng ta phải duy trì được state đó qua cả quá trình.
6. Benchmark không đủ: bảy thứ phải đo trước khi lên production
Như chị nói, trước khi đưa một kiến trúc như vậy vào production, benchmark không phải là thứ duy nhất. Chị tả đúng cách mọi người thường làm: một model mới ra, cả nhóm vào xem benchmark, "OK, benchmark tốt hơn, vậy mình switch". Theo chị, cùng với benchmark, phải xem memory, latency, throughput, quality, depth, những thứ đã bàn trong talk.
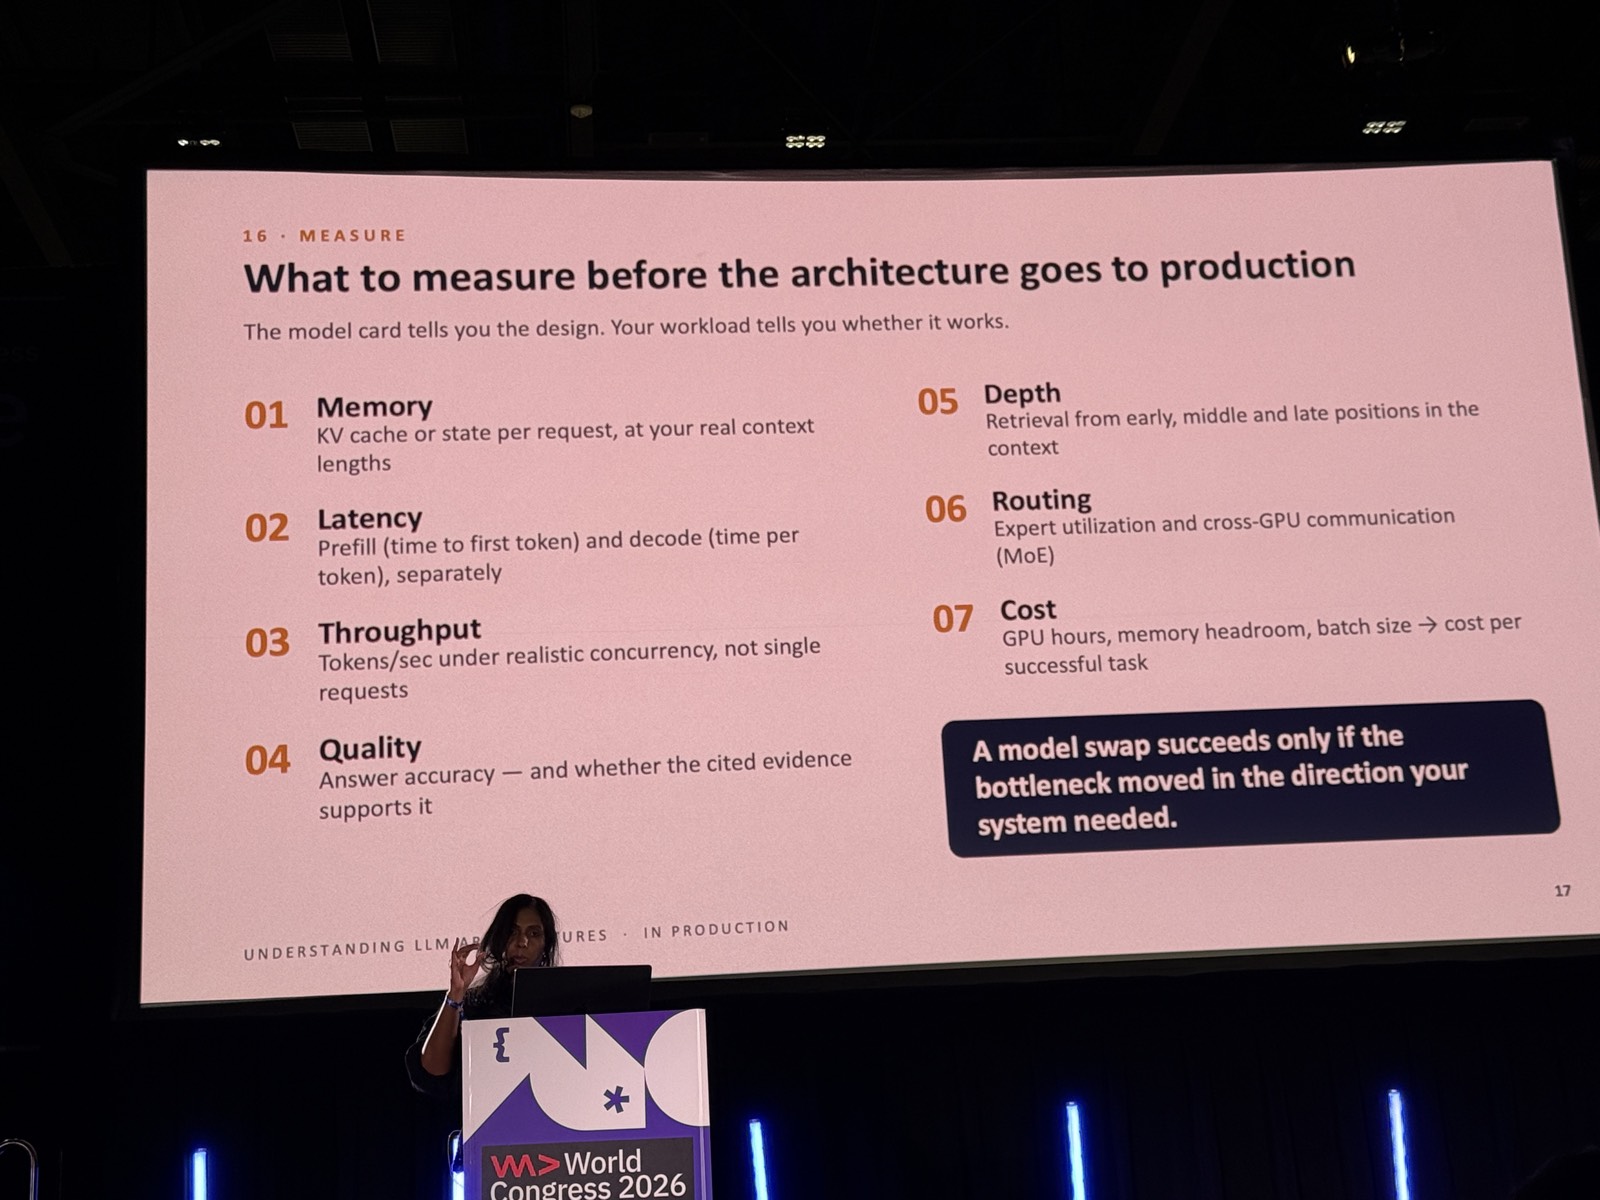
Bảy mục này nối thẳng về các phần trước: memory và depth là phần RAG và large-document agent, routing là phần MoE, quality với "evidence" là phần very long context. Mục cost đáng chú ý vì đơn vị không phải giá mỗi token mà là cost per successful task: model rẻ hơn mỗi token nhưng làm hỏng nhiều task hơn thì thực ra đắt hơn.
7. Takeaway: Transformer vẫn còn, các giả định đắt tiền đang đổi
Phần kết, chị tóm lại: phần khung cơ bản của cấu trúc cổ điển vẫn còn đó, position handling, multi-head attention. Ở các model mới, biến thể kiến trúc nằm ở cách xử lý attention, cách xử lý KV cache, và bottleneck nào đang được giảm. Toàn bộ ý ở đây là: khi một model mới xuất hiện, chúng ta cần xem nó đang giải quyết bottleneck nào trong production, và nó thực sự tác động ra sao lên latency, context quality.
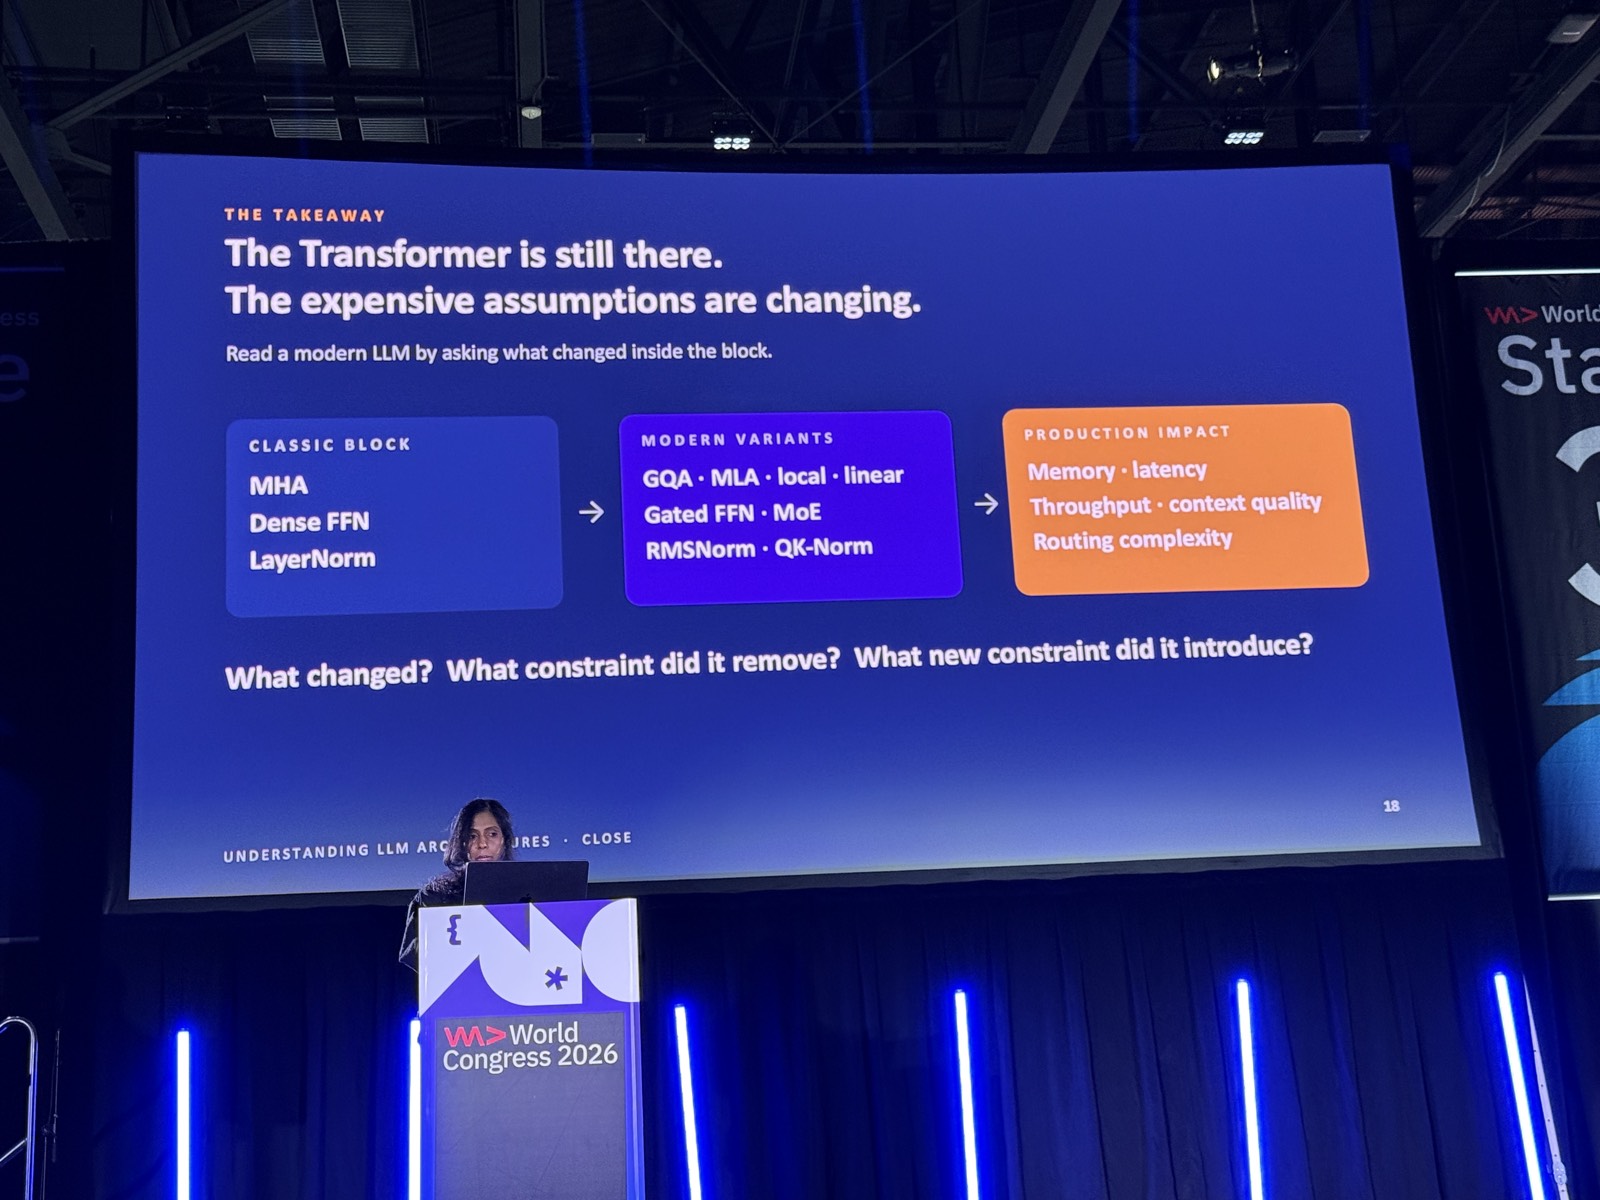
Đó là điều quan trọng nhất theo chị: hiểu kiến trúc sẽ giúp chúng ta validate được những thứ này, và map được nó vào chính công việc của mình. Slide cuối là danh sách reference. Chị nói gần hết giờ, ai có câu hỏi thì cứ liên hệ qua app của sự kiện, rồi cảm ơn khán giả.
MC lên cảm ơn: "That was awesome", nói bản thân học được rất nhiều từ session, và hy vọng khán giả cũng mang về được nhiều thông tin có ích, rồi chuyển sang phần tiếp theo của Stage 9.
Nguồn và link
- Trang session chính thức: Understanding LLM Architectures: Inside the Design of Modern Models. Speaker trên LinkedIn: Jofia Jose Prakash.
- GPT-2: Language Models are Unsupervised Multitask Learners
- Llama 3: The Llama 3 Herd of Models · Mistral: Mistral 7B · Gemma 3: Gemma 3 Technical Report
- DeepSeek MLA và MoE: DeepSeek-V2, DeepSeek-V3 Technical Report
- Qwen3-Next: model card · Gated DeltaNet: Gated Delta Networks
- Component: GQA · RoPE (RoFormer) · SwiGLU / GeGLU · RMSNorm
- Chưa tìm được nguồn: slide deck gốc và danh sách reference của speaker.
Related talks
Anatomy of an AI Request: Where Latency and Cost Are Really Born
Dan Fu · Together AI · 35 min
Sáu stage một AI request đi qua (routing tới decode) và sáu lever giảm latency, cost: kernels, disaggregation, parallelism, routing, speculative decoding, quantization.
Tools, Sandboxes, and the Plumbing of Agentic Development
Oleg Šelajev · Docker · 34 min
Dựng một coding factory để thoát khỏi vai điều phối toàn thời gian: mỗi agent một role, CLI và model riêng, chạy trong sandbox, dùng kits và skills.
Building an AI-Native Development Workflow
Vanessa Minik · GitHub · 20 min
AI native khác AI embedded: nghĩ lại SDLC quanh một workforce nhiều agent, context engineering, và việc cần làm ngay sáng thứ Hai.