Anatomy of an AI Request: Where Latency and Cost Are Really Born
Sáu stage một AI request đi qua (routing tới decode) và sáu lever giảm latency, cost: kernels, disaggregation, parallelism, routing, speculative decoding, quantization.
1. Không phải "API request" mà là "AI request"
Speaker là Dan Fu, VP of Kernels ở Together AI. Tên talk là "Anatomy of an AI Request", không phải "API Request" như MC suýt đọc nhầm, và theo MC điều đó còn thú vị hơn nhiều.
Chủ đề của Dan là AI request inference: khi bạn nói chuyện với ChatGPT hay một model nào đó, thứ gì thật sự chạy qua pipeline, và các token đi qua những bước nào để được xử lý.
Speaker: Dan Fu, trang cá nhân danfu.org; trang session chính thức: WeAreDevelopers World Congress North America.
2. Vì sao người ta chuyển sang open-source model: chuyện cost
Trong lúc chờ kỹ thuật xử lý slide, Dan bắt đầu bằng bối cảnh chung. Talk này nói về hai thứ: nói chung các token được xử lý thế nào, và riêng ở Together thì họ nghĩ về chuyện đó ra sao, nhất là với open-source AI.
Chức danh của anh ở Together AI là VP of Kernels. Anh dẫn một đội research và performance. Cả ngày họ nghĩ về một việc: có rất nhiều model mới mà người ta đang muốn dùng, như DeepSeek, Kimi, MiniMax, GLM và nhiều model khác. Họ thấy mức sử dụng các model này tăng rất mạnh và rất thú vị, và cái tăng đó có vài động lực.
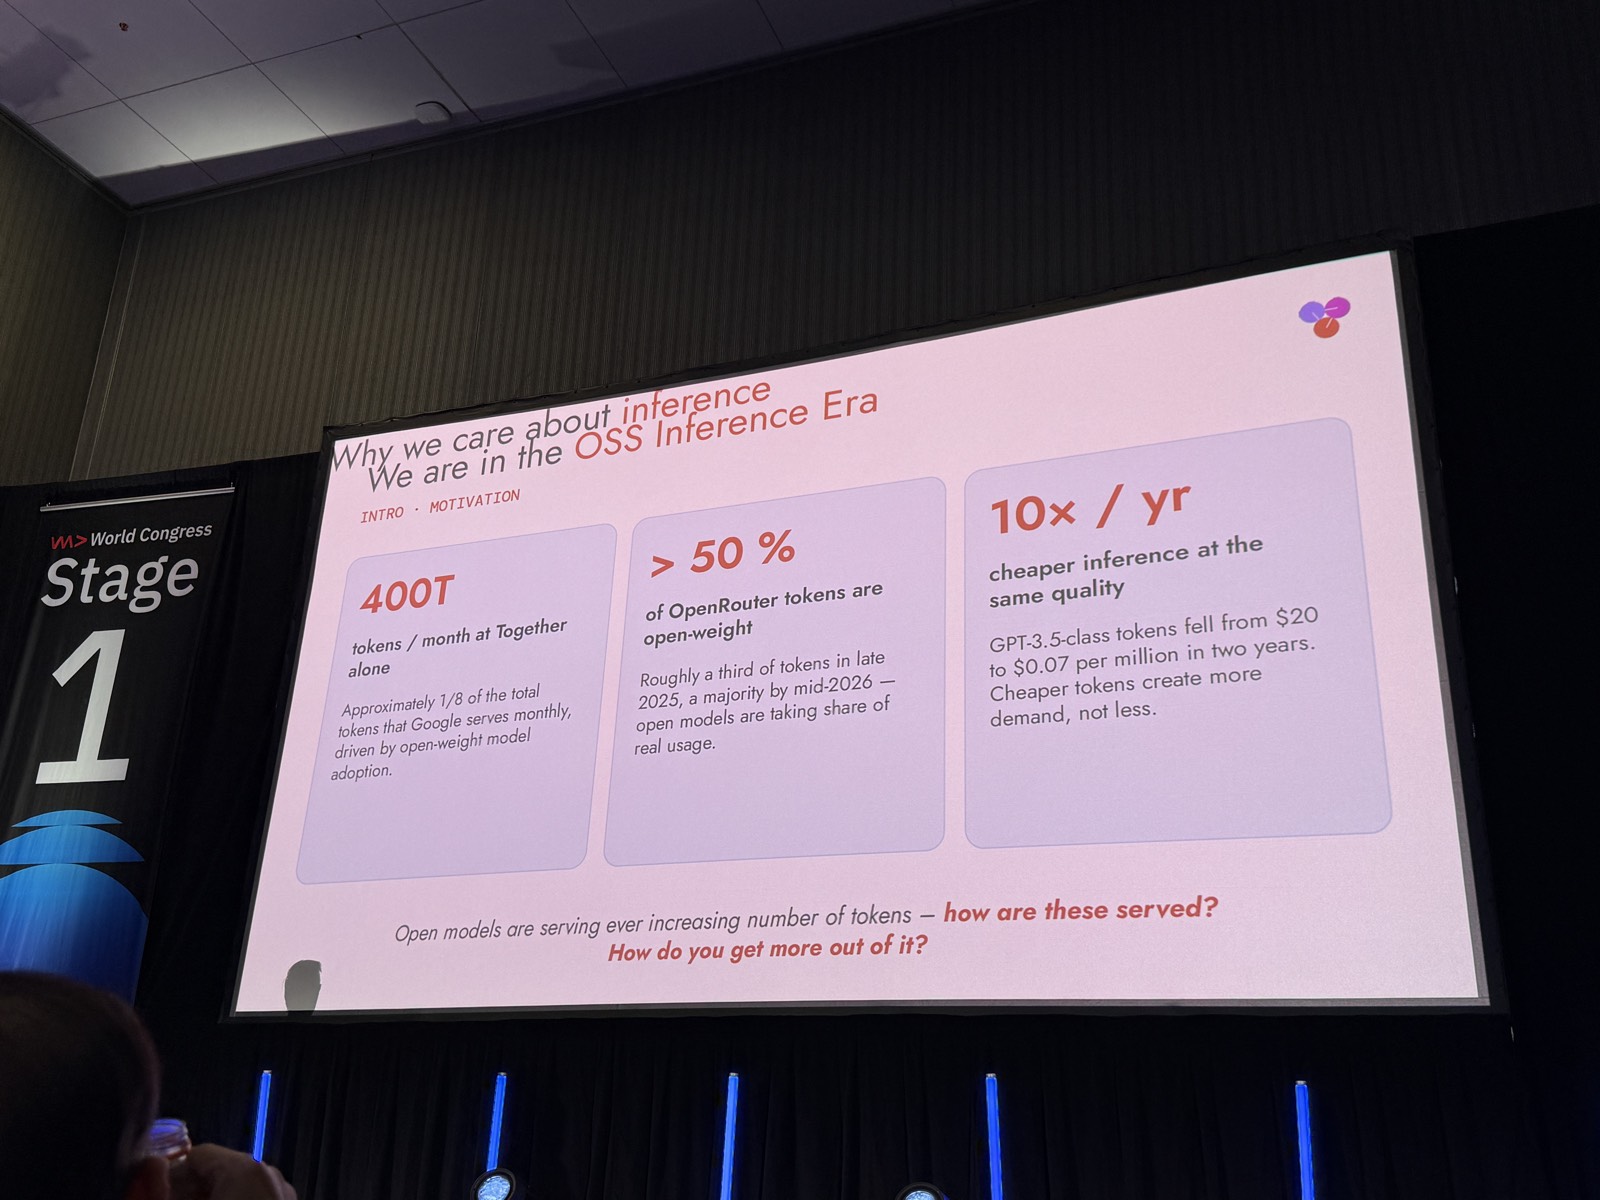
Động lực đầu tiên là cost. Anh nói nhiều người trong phòng chắc đang dùng ChatGPT hay Claude hằng ngày trong workflow của mình. Tới một lúc nào đó bạn sẽ để ý, hoặc CFO và bộ phận tài chính của bạn sẽ để ý: "Này, mình đang tiêu rất nhiều tiền cho mấy AI token request này." Chính ở thời điểm đó người ta bắt đầu nhìn sang open-source model. Đây là những model có thể có chất lượng tương đương closed-source model nhưng được phục vụ với giá chỉ bằng một phần nhỏ.
Anh kể một phần lớn đội của anh đã dogfood Kimi cho việc code nội bộ, dùng nó cho rất nhiều request trong công ty. Và những thách thức khi phục vụ các model đó, tức là tìm ra cách serve chúng ở quy mô lớn, hóa ra rất thú vị.
Anh xem trước nội dung trong khi slide vẫn chưa lên: khi bạn gửi một request tới một API kiểu này, nó sẽ đi qua vài stage. "Stage đầu tiên là..." và đúng lúc đó slide hiện lên, "Oh, there we go", MC reo theo "All right, all right".
Slide đầu tiên là "lifecycle of a token": talk sẽ nói điều gì thật sự xảy ra khi bạn gửi một request như vậy, và Together nghĩ thế nào để làm nó nhanh hơn. Về động lực, anh nhắc lại chuyện cost ở trên và đưa ra con số: Together hiện đang serve 400 nghìn tỷ (400 trillion) token mỗi tháng. Fun fact: con số này bằng khoảng một phần tám tổng số token Google serve, và anh nghĩ con số của Google đã tính cả Google Search. Tức là khi bạn search Google và cái hộp Gemini nhỏ hiện lên, cộng với mọi sản phẩm Gemini AI khác của họ.
3. Together AI, AI-native cloud, và mỗi workload một kiểu SLA
Dan nói tiếp về con số thứ hai: trên các router như OpenRouter, những router hướng tới người dùng cuối mà nhiều người trong phòng có thể biết, hơn một nửa số token hiện đã chạy qua open-source model. Tức là rất nhiều người đang chuyển sang open model. Có nhiều lý do, nhưng động lực chính vẫn là cost: bạn có được chất lượng gần bằng, hoặc bằng, với giá chỉ bằng một phần nhỏ.
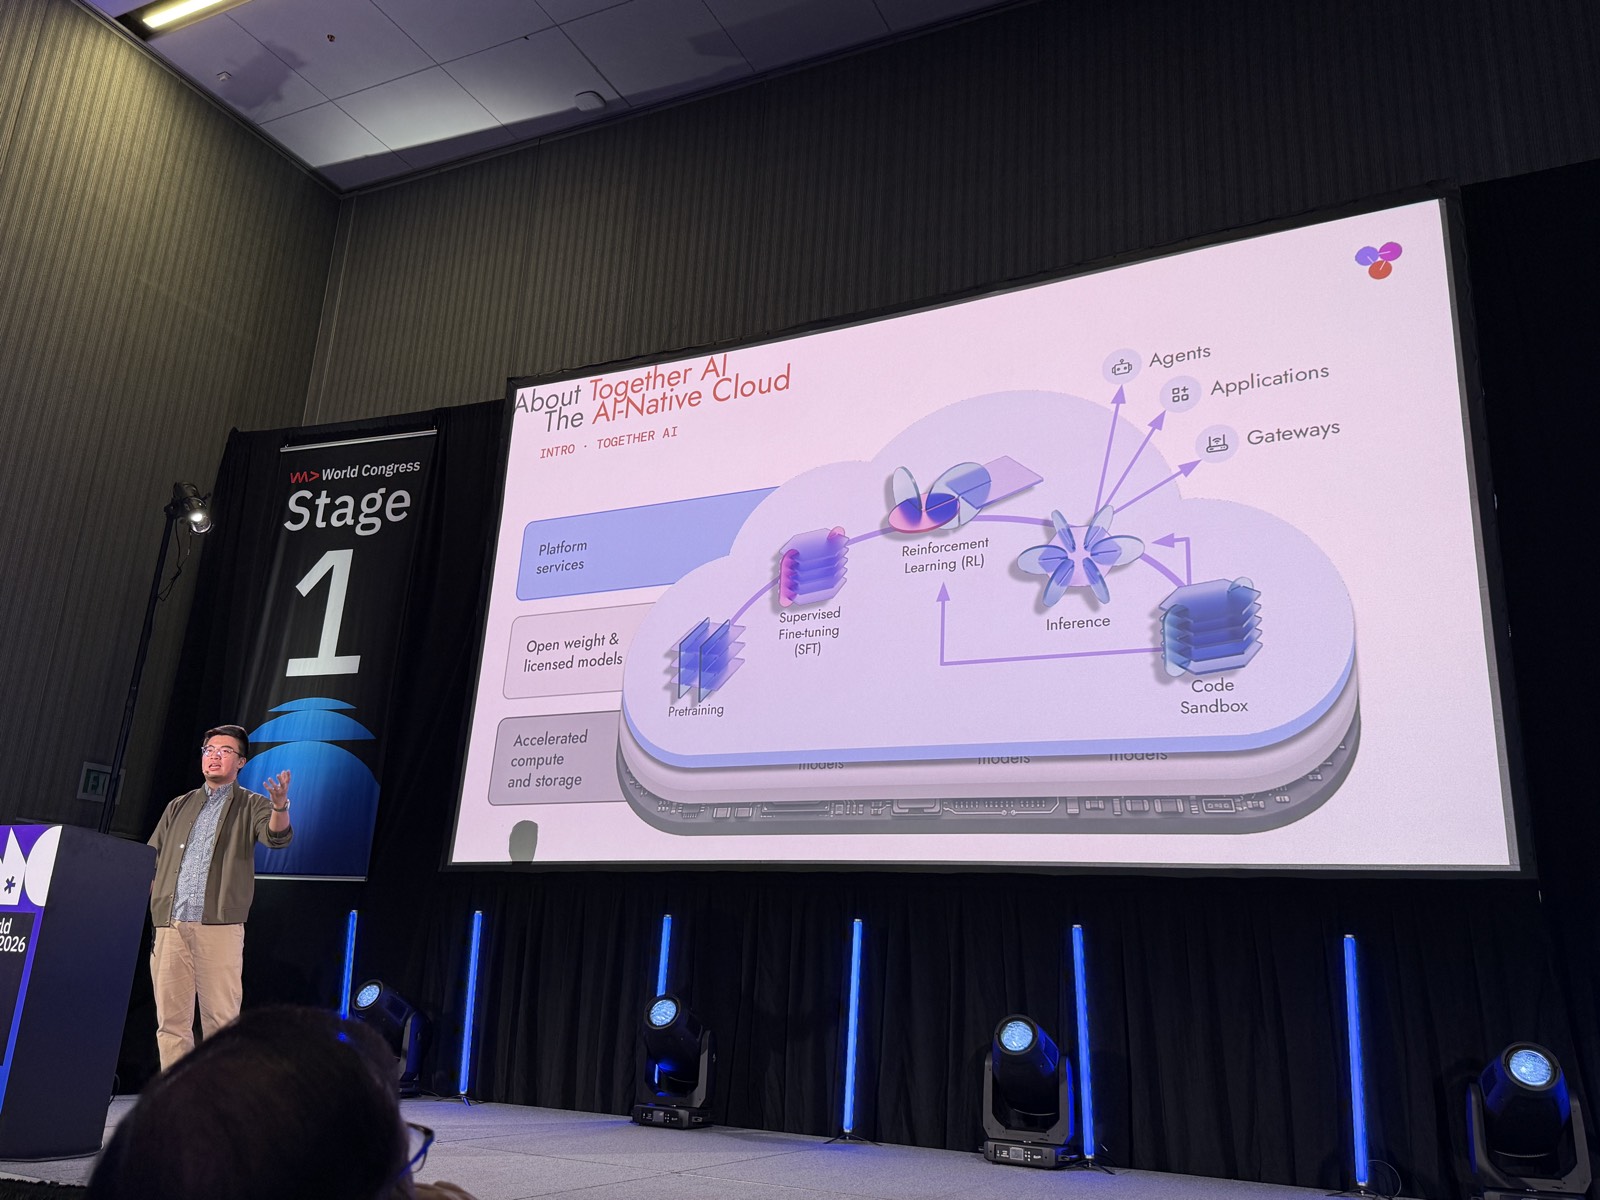
Rồi anh giới thiệu công ty. Together AI là một AI-native cloud: họ xây nền tảng trên cloud để phục vụ tương lai AI-native. Anh so sánh với AWS: ở AWS bạn có database, monitoring, CPU cluster và đủ các mảnh ghép; Together thì đang xây đủ các mảnh ghép tương ứng cho một cloud AI-native. Inference là phần anh vừa nói, nhưng còn có cả việc customize model cho mục đích riêng của bạn.
Together có một đội performance rất mạnh, khoảng hơn 80 researcher, nhiều người có PhD, chuyên làm efficiency và performance cho AI ở mức hàng đầu.
Cả ngày họ nhìn gì: workload và SLA
Vậy đội này làm gì cả ngày? Họ nhìn vào các workload khác nhau và các SLA khác nhau.
Ví dụ nếu bạn làm một voice app, dùng ElevenLabs hay Cartesia hay một API tương tự, bạn gần như chắc chắn có yêu cầu time to first token (TTFT) rất gắt. Khi bạn nói chuyện với các API này, bạn muốn chúng trả lời ngay lập tức, nên TTFT phải rất thấp.
App khác thì quan tâm nhiều hơn tới TPS (tokens per second) mà người dùng cảm nhận. Nếu bạn viết nhiều code, để model viết nhiều code và sinh ra rất nhiều token, thì thứ quan trọng với bạn là cả pipeline end-to-end chạy nhanh tới đâu.
Workload cũng khác nhau về hình dạng. Nếu bạn chạy một workload agentic coding, bạn sẽ gửi lên cùng một context rất nhiều lần: bạn upload và xử lý codebase một lần, rồi bắt đầu sửa từng chút nhỏ. Kiểu chat dài hạn này có workload rất khác với giao diện ChatGPT quen thuộc, nơi bạn vào hỏi vài câu rồi thôi. Hằng ngày đội của anh dành rất nhiều thời gian để nghĩ về những câu hỏi này và giải quyết chúng lần lượt từng cái một.
4. Sáu stage từ request tới response, bắt đầu từ routing
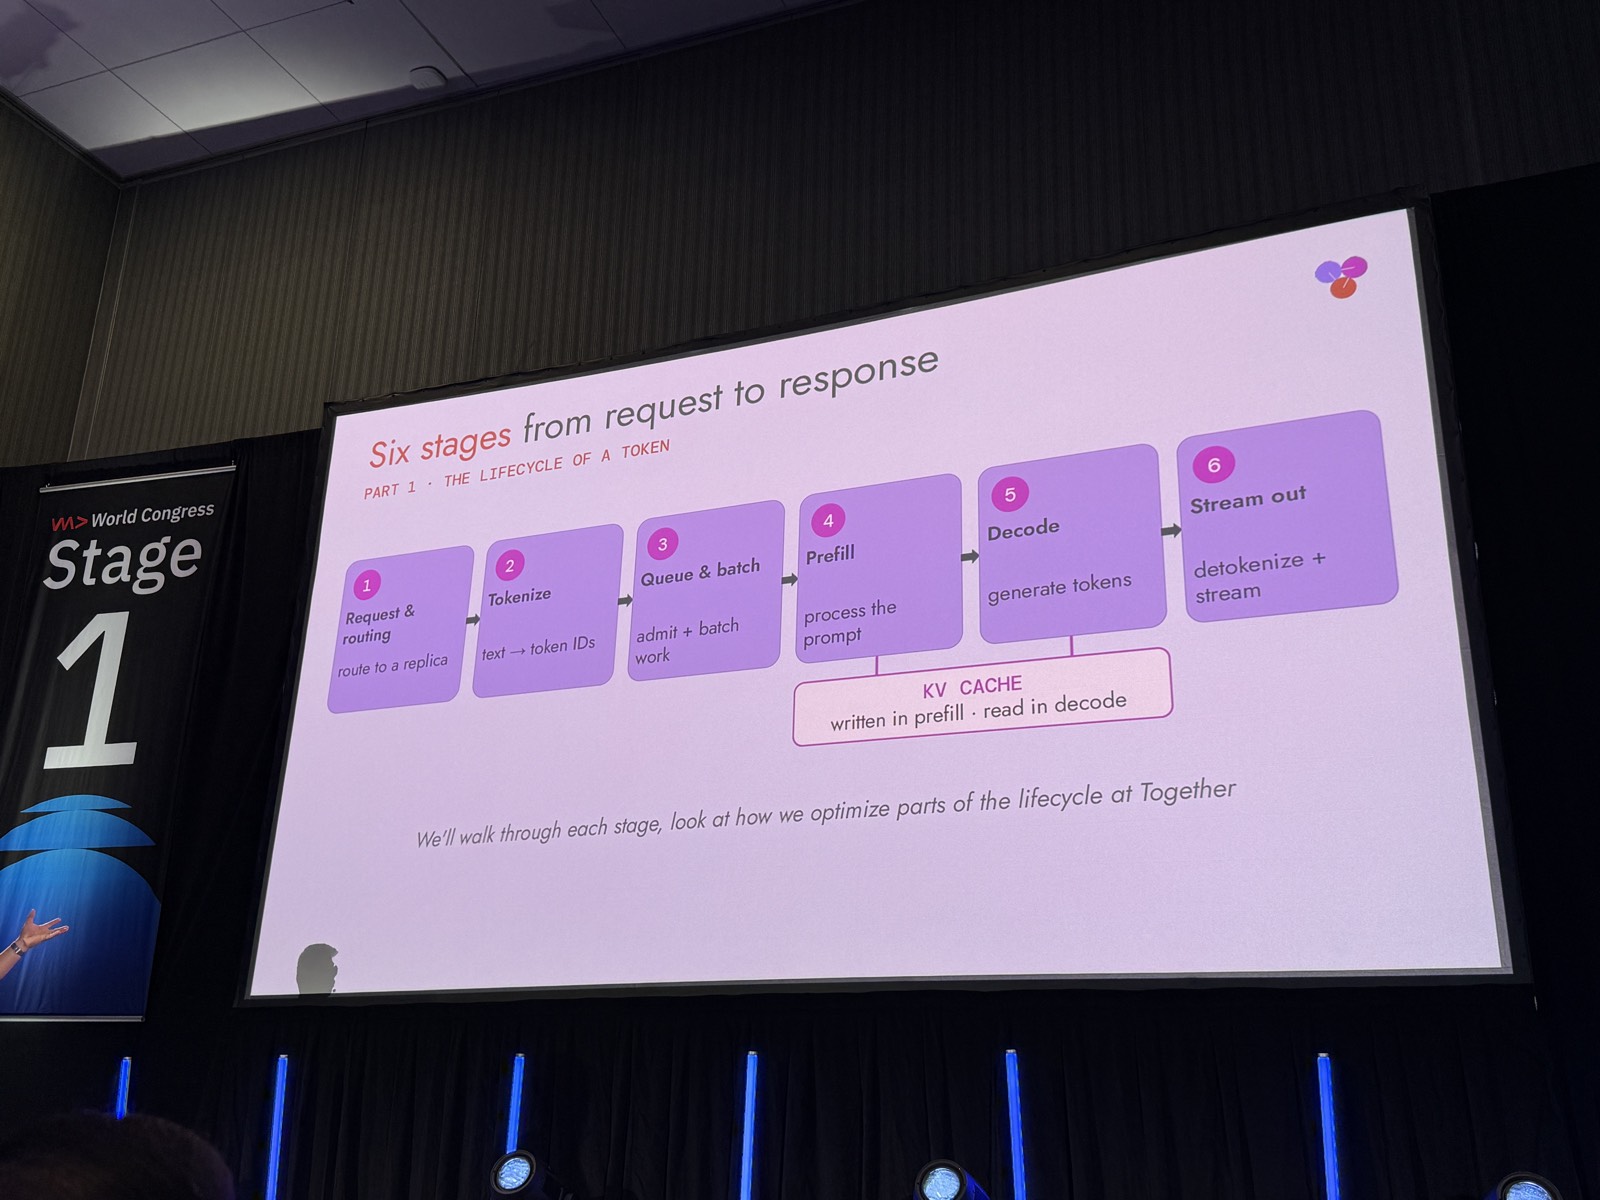
Trong talk này, trước hết Dan đi qua lần lượt: khi một request tới, nó đi qua những stage nào của pipeline. Đại khái có routing; có tokenization và tool calling; có một vòng queuing và batching; rồi tới thứ mà ta có thể coi là phần "nuts and bolts" của code GPU. Phần đó gồm prefill, tức là khi bạn gửi vào một prompt lớn thì nó được xử lý ra sao, và decode, tức là khi model sinh ra từng một đến ba token mỗi lần thì quá trình đó chạy thế nào. Cuối cùng, dĩ nhiên, bạn nhận token ra.
Anh sẽ đi qua từng stage, và nói ở Together họ nghĩ gì về việc tối ưu từng phần bằng các sáng kiến và insight research của họ.
Stage 1: routing, một bài toán distributed system quen thuộc nhưng có twist
Khi request vừa tới, bạn gặp một bài toán gần như rất kinh điển: bài toán load balancing và routing của một web service lớn, phân tán. Nhưng có vài điểm khác.
Cách nghĩ cơ bản: bạn có những data center lớn với rất nhiều GPU, tất cả đều có thể phục vụ request. Có rất nhiều request đổ về. Bạn không muốn một replica nào đó bị "nóng" quá, tức là gánh quá nhiều traffic, vì khi đó sẽ có user phải chờ rất, rất lâu, và bạn không đạt được các SLA vừa nói ở trên.
Nhưng serve AI token có thêm một twist: khi xử lý request, sẽ có lợi nếu request của cùng một user được xử lý trên cùng một replica. Nếu chính những GPU đó đang xử lý request từ một user mà chúng đã gặp trước đây, bạn tiết kiệm được rất nhiều compute, phục vụ được nhiều traffic hơn, có tốc độ nhanh hơn, SLA tốt hơn, và "tokenomics" tốt hơn.
Nên stage đầu tiên này là request routing: có một phần là load balancing cổ điển mà bạn đã quen, nhưng còn có phần routing biết cache (cache-aware) và biết user (user-aware). Và điều này có thể hiện ra ngay trong request end-to-end của bạn, ví dụ ở cache hit rate. Nó ảnh hưởng tới số tiền bạn trả với tư cách user, và cả trải nghiệm bạn nhận được.
5. Tokenize, tool calling, và vòng queue & batch
Stage 2: tokenization và tool calling
Khi đã route tới một replica cụ thể, bạn phải lấy đống text "vô định hình" của con người, những ký tự đó, và dịch chúng thành thứ mà GPU và model thật sự dùng được. Đó là bước tokenization: lấy câu tiếng Anh này, biến nó thành một chuỗi token.
Nhưng ở đây bạn cũng bắt đầu quản lý những thứ như tool calling. Trong mọi AI pipeline hiện đại, bạn không chỉ nhờ máy trả lời một yêu cầu. Bạn còn truyền vào: "này, tôi có một lệnh bash, một lệnh grep, một lệnh search, hay thậm chí một khả năng web search". Và model có thể chọn trong năm tới mười thứ đó để gọi như những tool call khác nhau. Tool calling cho phép model nối ra thế giới bên ngoài theo những cách then chốt.
Ở Together, họ dành rất nhiều thời gian để bảo đảm lớp tool call này chạy đúng. Họ dogfood chính dịch vụ của mình, có người thật làm việc này: khi đưa một bản deploy mới lên, một trong những việc đầu tiên họ làm là bắn một phần traffic coding nội bộ vào bản deploy đó để chắc chắn mọi thứ chạy tốt.
Stage 3: core executor loop, queue và continuous batching
Tiếp theo là cái có thể gọi là core executor loop. Lúc này bạn có một loạt request. Chúng bắt đầu xếp hàng, bạn bắt đầu gom chúng thành batch và xử lý trên một replica cụ thể. Có một cơ chế continuous batching trộn lẫn hai thứ: những gì replica đang xử lý dở, và những request mới đang đổ vào. Cách bạn làm scheduling sẽ định hình các quyết định của engine, lượng tải bạn phục vụ được, và các SLA đã nói ở trên.
Tới phần "AI" thật sự: prefill và decode
Giờ mới tới phần mà bạn có thể coi là phần AI cốt lõi của workload. Đây là chỗ bạn thật sự có một model bắt đầu xử lý text và hình thành một "ý kiến thông minh" về chuyện đang diễn ra. Phần này chia làm hai: prefill và decode.
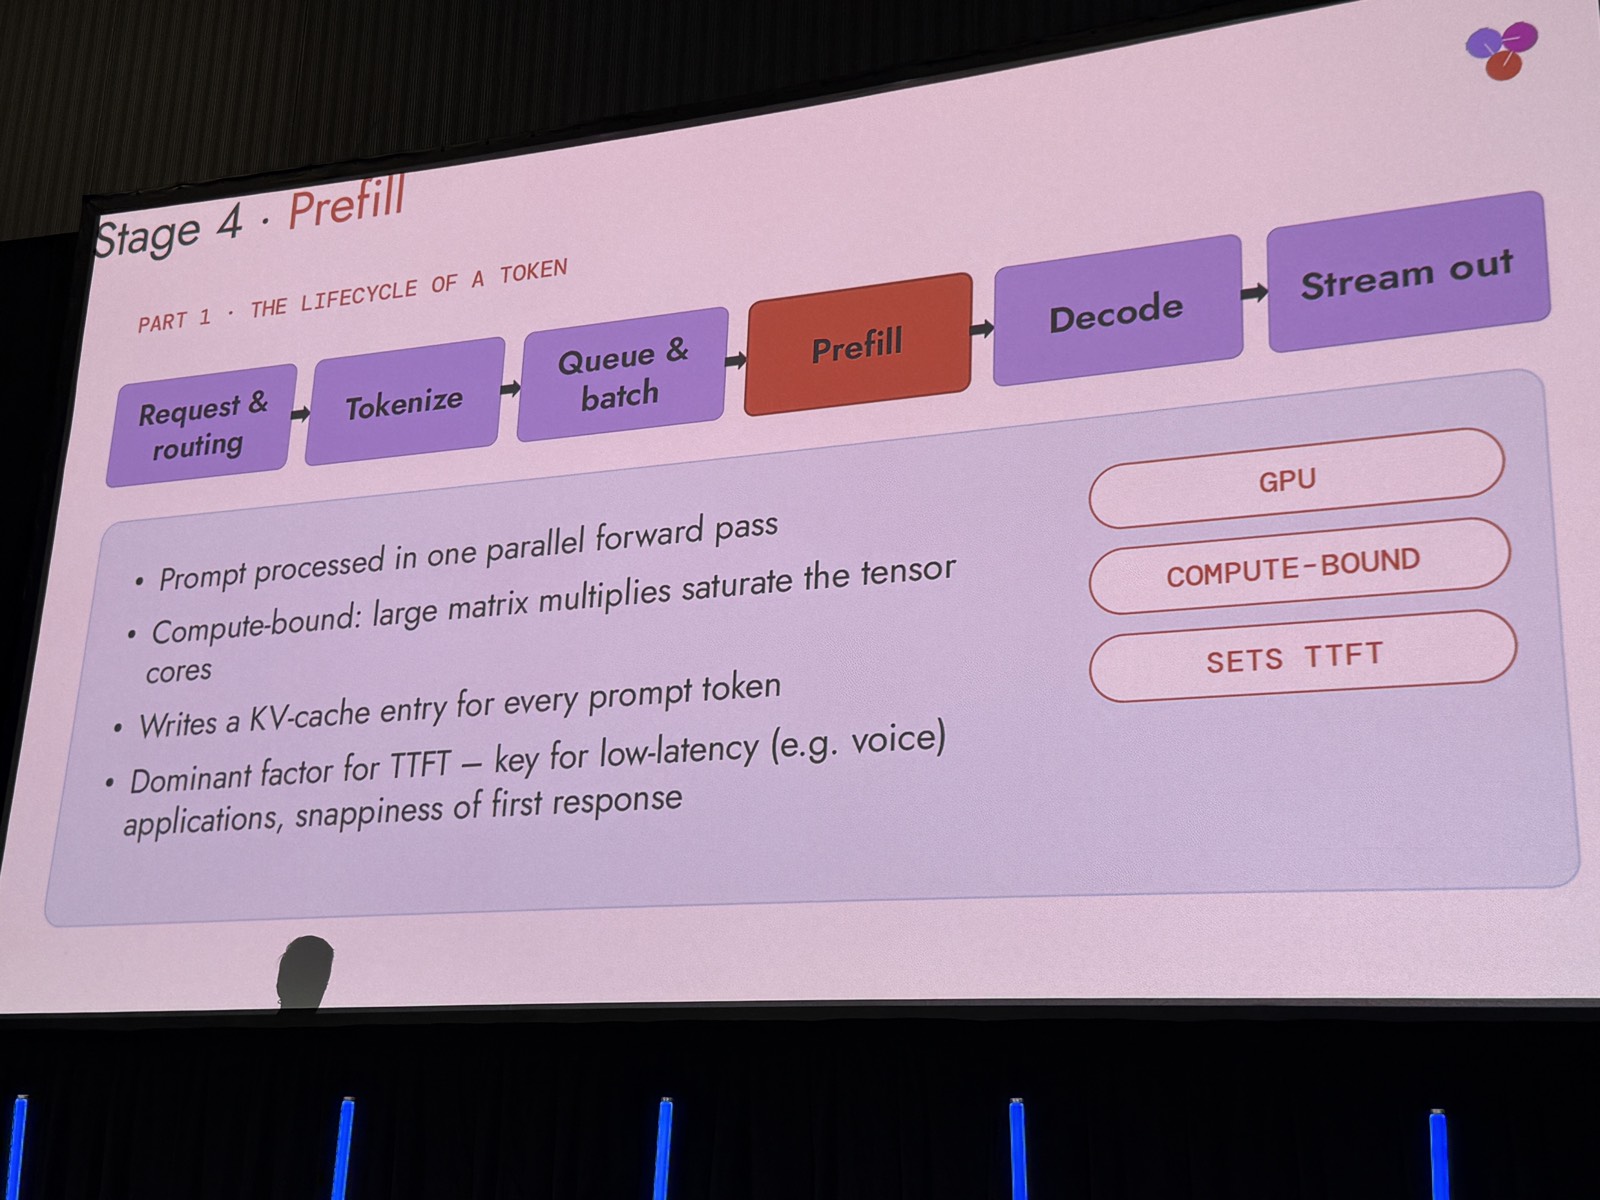
Prefill là lúc xử lý prompt. Ví dụ bạn gửi vào 100.000 token: toàn bộ codebase của bạn, câu hỏi của bạn, và thêm context từ vài file khác. Tất cả được xử lý song song trong một lần parallel forward pass.
6. Prefill ghi KV cache, decode bị memory-bound
Stage 4: prefill là compute-bound
Điều cần nhớ về prefill: đây là một workload compute-bound rất điển hình. Nó vận dụng hết các đơn vị nhân ma trận (matrix multiplication unit) trên GPU hiện đại. Nó làm toàn bộ phần xử lý song song đó chỉ để tìm ra mọi tương tác giữa tất cả các từ khác nhau trong prompt lớn của bạn.
Một việc prefill làm mà Dan muốn chỉ ra: nó ghi xuống một entry KV cache. Có thể hiểu thế này: một khi đã làm xong khối tính toán đắt đỏ đó, lúc sinh token mới bạn không cần phải nghĩ lại quan hệ giữa các từ ở phần đầu prompt nữa. Bạn chỉ cần lấy kết quả tính toán đó và cache lại ngay tại chỗ.
Nhờ vậy, khi có một request mới tới mà mang cùng prompt đó, ví dụ bạn gửi codebase, model sửa một chỗ, rồi bạn hỏi thêm một câu follow-up, thì bạn có thể bỏ qua phần tính toán prefill. Đây là một trong những cần gạt lớn nhất để lấy thêm performance từ GPU.
Stage 5: decode, mỗi token lại phải đọc cả model
Stage thứ hai của phần GPU là decode. Đây là lúc model chỉ sinh từng token một, và đây là một workload rất khác.
Một cách nghĩ: mỗi lần sinh một token, bạn phải nạp toàn bộ model từ GPU memory vào đơn vị tính toán. Các model này có thể có tới hàng nghìn tỷ parameter, tức là hàng chục hay hàng trăm gigabyte dữ liệu mà bạn phải đọc vào mỗi lần sinh ra chỉ một token. Nên phần tính toán này rất memory-bound. Thay vì những phép nhân ma trận song song khổng lồ, bạn chủ yếu bị giới hạn bởi tốc độ đọc memory.
Nhưng stage decode lại quyết định số output token per second mà bạn thấy. Khi nói chuyện với một model thông minh hơn hay lớn hơn, bạn để ý nó trả lời chậm hơn, text chạy ra chậm hơn, đó là vì model lớn hơn, cần nạp nhiều memory hơn, nên phản hồi end-to-end chậm hơn. Ngược lại, nếu bạn dùng một model "instant" hay model nhỏ hơn...
7. Stream out, và sáu cần gạt để inference nhanh hơn
...thì bạn nhận text về nhanh hơn nhiều. Về bản chất, đó là vì model nhỏ phải nạp ít dữ liệu hơn cho mỗi token nó sinh ra.
Stage 6: stream out
Cuối cùng, dĩ nhiên, bạn lấy những token ID đó, một danh sách số nguyên, đổi ngược lại thành text người đọc được, và trả về cho bạn. Đây là phần computer science rất cổ điển, kiểu API web developer "old fashioned" quen thuộc.
Làm hệ thống phức tạp này hiệu quả hơn: "hiệu quả" nghĩa là gì
Vậy làm sao lấy hệ thống phức tạp này và làm nó hiệu quả hơn? "Hiệu quả hơn" có thể mang vài nghĩa. Với Together, họ nghĩ nhiều về việc phục vụ được bao nhiêu user, bao nhiêu token trên cùng một lượng phần cứng. Với ứng dụng cuối, nó có thể là: tôi nhận được response nhanh tới đâu, token ra nhanh tới mức nào.
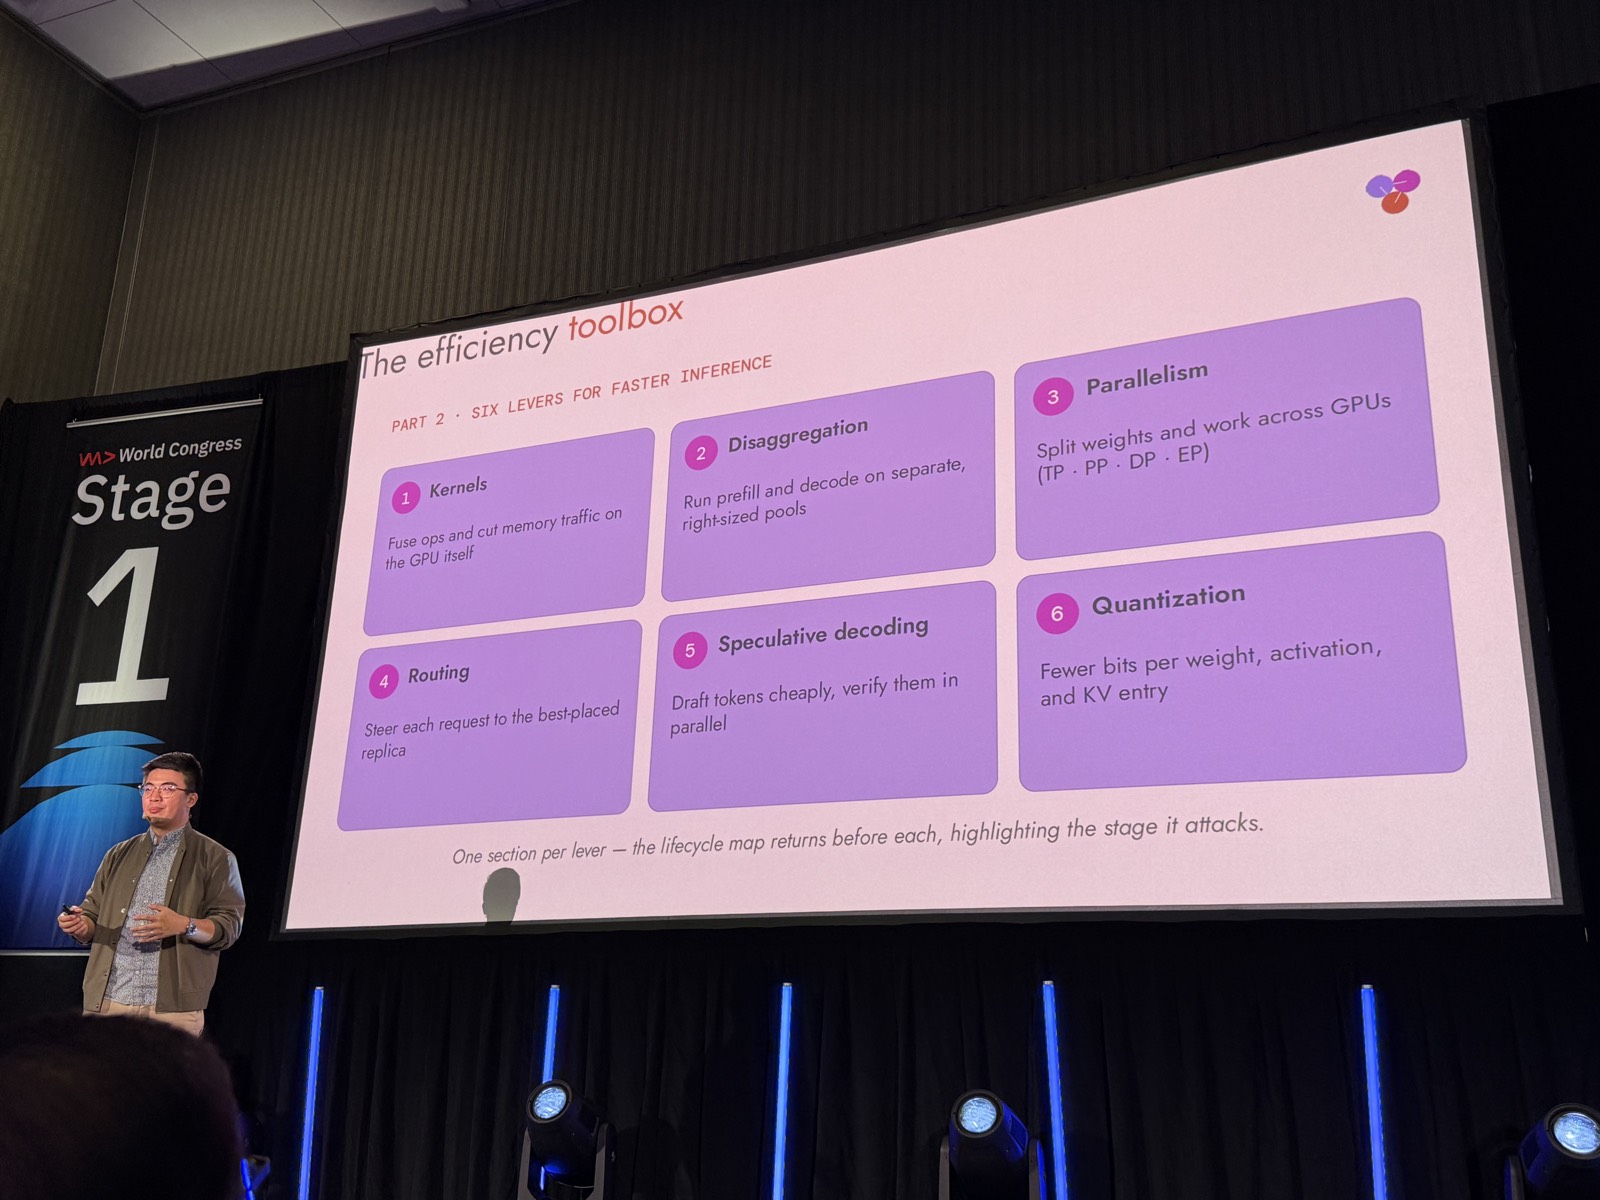
Dan sẽ nói về vài cần gạt (lever), đi qua từng cái và chỉ ra nó tối ưu phần nào của pipeline:
- Kernels. "Kernel chỉ là một từ nghe sang cho GPU program."
- Disaggregation. Prefill và decode khác nhau rất nhiều, vậy nên đặt workload nào lên compute nào?
- Parallelism. Các model này rất lớn: một model có thể có tới cả terabyte weights, trong khi mỗi GPU chỉ chứa được vài trăm gigabyte. Chia phần tính toán đó ra thế nào?
- Routing. Một số tối ưu cho lớp routing đầu tiên, nơi phải cân bằng cả load balancing lẫn việc biết KV cache nằm ở đâu.
- Speculative decoding. Anh vừa nói ta chỉ sinh được một token mỗi lần, nhưng thật ra có mẹo để sinh 3, 4, 5, thậm chí 10 token mỗi lần.
- Quantization. Làm sao để model chiếm ít chỗ hơn, để dùng ít GPU hơn cho cùng lượng traffic, mà không hy sinh chất lượng.
Kernels là gì
Đầu tiên là kernels. Kernel đánh thẳng vào phần xử lý GPU cốt lõi: prefill và decode. Vậy kernel là gì, và vì sao phải tối ưu nó? Có thể nghĩ kernel là cách ta lấy những phép toán rất phức tạp và ánh xạ chúng lên workload thật trên GPU.
8. Lever 1: kernels, memory hierarchy của GPU, và Together Compiler
Một trong những mẹo phổ biến nhất: ta nhìn vào ba hay bốn operation. Riêng từng cái có thể đều memory-bound. Vậy có thể cache kết quả trung gian của chúng ở một tầng cao hơn trong memory hierarchy không?
Nếu bạn từng làm systems engineering, chắc bạn có sẵn hình ảnh trong đầu: network thì rất xa; disk gần hơn; RAM của CPU còn gần hơn; rồi tới L1 cache ngay trên CPU. Trên GPU có một memory hierarchy y hệt như vậy. Chỉ khác là ở đây thứ "rất xa" chính là RAM của CPU. Thứ gần hơn một chút là GPU memory. Rồi có những tầng cao hơn nữa, như bộ nhớ on-chip của GPU, tương tự L1 cache của CPU.
Kernel là chuyện: làm sao lấy những mảnh tính toán cấp cao này và cache một phần kết quả trung gian của chúng, để dùng compute hiệu quả hơn.
Tự động hóa việc tối ưu kernel: Together Compiler
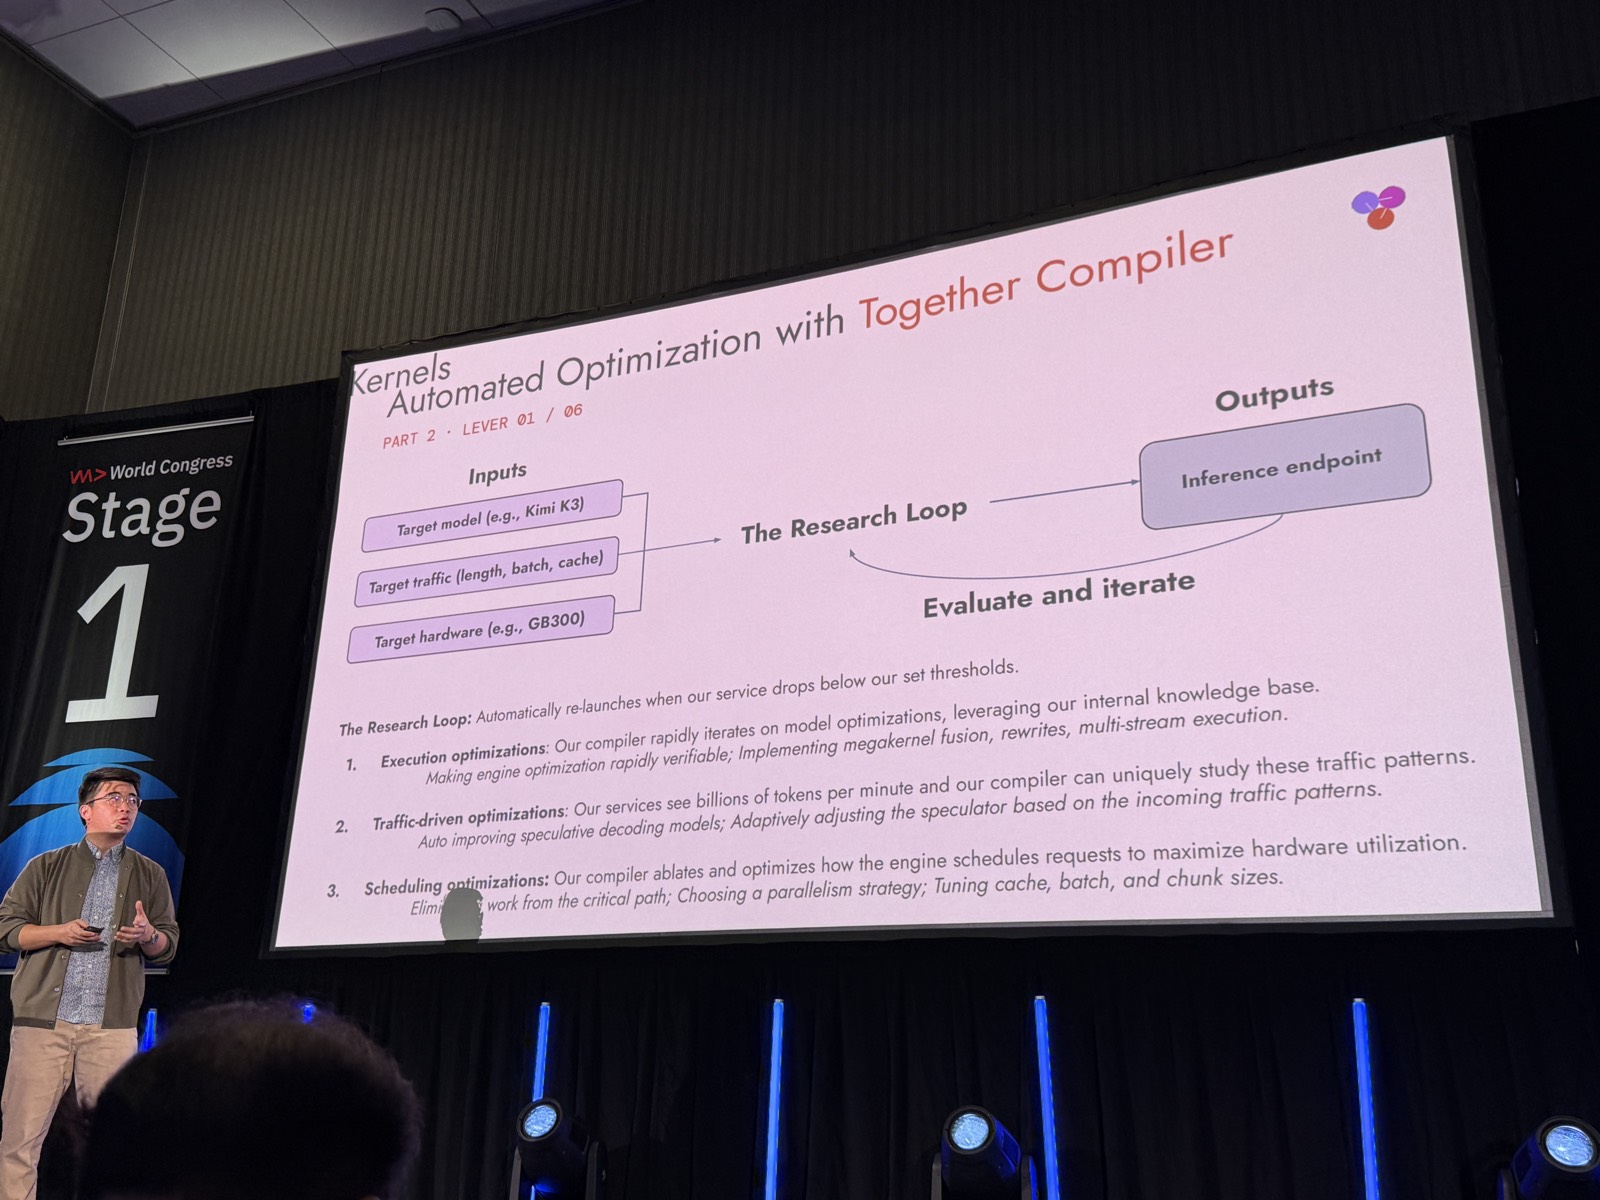
Theo cách cổ điển, bạn cần một đội rất lớn để làm tất cả việc này. Ở Together có khoảng 20 tới 30 người mang chức danh GPU engineer, dành rất nhiều thời gian nghĩ về chuyện này. Nhưng gần đây họ đầu tư vào vài hướng research mới để tự động hóa phần lớn pipeline tối ưu.
Họ xây một thứ gọi là Together Compiler. Nó không giống các compiler kiểu cũ như LLVM. Nó giống một compiler được xây cho machine learning model, và ở lõi là một vòng research: đánh giá, rồi lặp (evaluation, iteration loop).
Cách làm: lấy một model, một endpoint, một traffic pattern; dựng nó lên; profile; tìm ra mọi nút cổ chai. Có thể kernel A, B và C chưa chạy tốt như chúng có thể. Rồi, dựa trên insight của chính đội, nhưng cũng dựa vào agentic workflow, họ cho một nhóm agent sửa các kernel đó, tune engine, làm phần lớn việc tối ưu tay mà trước đây họ tốn rất nhiều thời gian. Việc này gồm nhiều mảnh: có thể sửa execution loop, có thể đổi config cho các loại traffic deploy khác nhau, có thể viết kernel mới. Và họ đã deploy được cách này trên cả fleet, tự động hóa được phần lớn việc tối ưu kernel.
9. Lever 2: prefill-decode disaggregation, và bản cache-aware
Mảng thứ hai có đòn bẩy rất lớn là cách tối ưu prefill và decode. Đây là hai loại workload rất khác nhau: prefill rất compute-bound, decode rất memory-bound. Nếu đặt chúng lên cùng một thiết bị, bạn nhận "the worst of both worlds": các operation lẽ ra compute-bound lại bị kẹt ở memory, và các operation memory-bound lại phải chờ compute rảnh.
Một kỹ thuật rất kinh điển: "OK, tôi lấy workload prefill đặt lên một nhóm GPU, lấy workload decode đặt lên một nhóm GPU khác." Đó là prefill-decode disaggregation. Giờ nó đã thành chuẩn, và rất nhiều bên serve inference làm điều này khá nhanh.
Thứ cơ bản nhất nó mang lại: bạn có thể chọn đúng cỡ (right-size) cho phần deploy prefill theo lượng compute cần làm, và chọn đúng cỡ cho phần decode theo băng thông memory cần có. Còn có nhiều cơ hội về chuyện dùng các loại phần cứng khác nhau: có thể đặt prefill lên một loại phần cứng như GPU, và cân nhắc đặt decode lên một loại phần cứng khác. (Ý tưởng tách prefill và decode cũng được trình bày trong bài DistServe.)
Cache-aware prefill-decode disaggregation
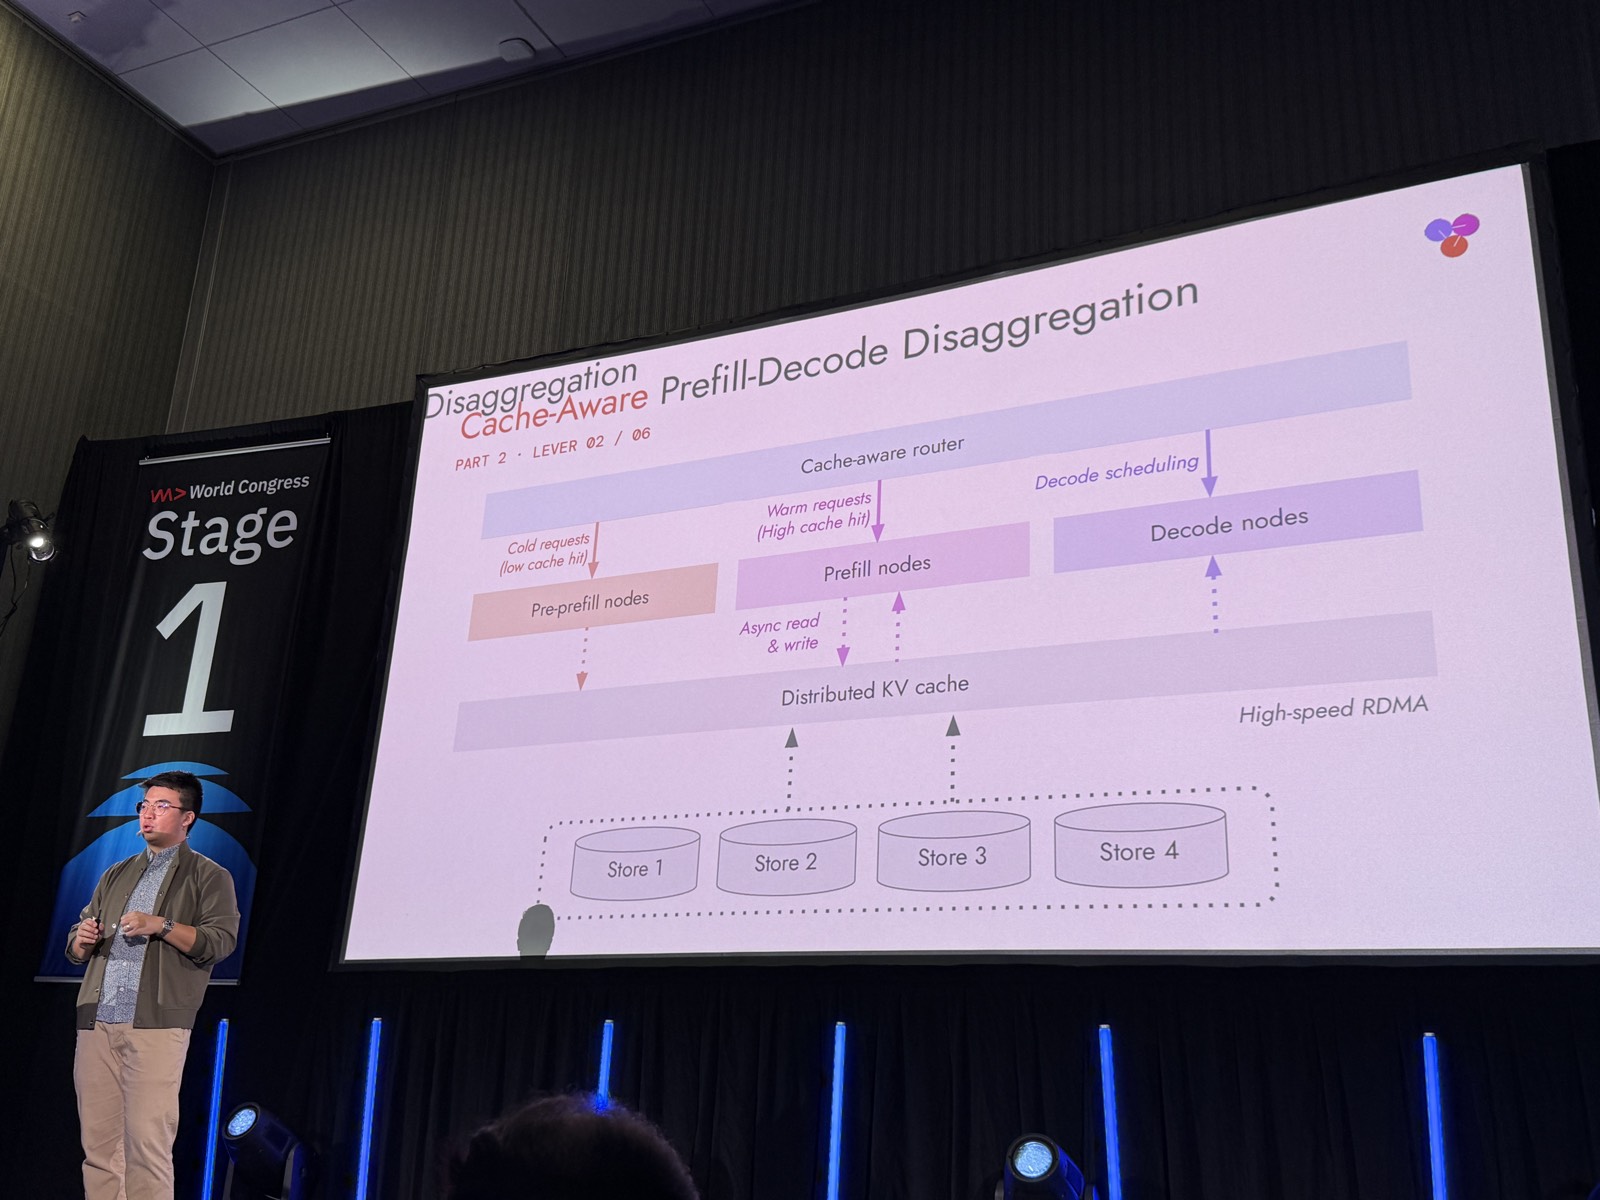
Ở Together họ còn làm các cải tiến thuật toán cho kỹ thuật này. Một cái họ công bố cách đây không lâu là cache-aware prefill-decode disaggregation. Ý tưởng cơ bản: ngay bên trong disaggregation, bạn có thể tách workload thêm một lần nữa để được lợi nhiều hơn.
Ý "cache-aware" ở đây là: khi có một request mới tinh tới, mang một đống text bạn chưa bao giờ thấy, đó sẽ là rất nhiều tính toán. Bạn không muốn nó chạy trên cùng phần cứng với, ví dụ, một câu hỏi mới trong một cuộc chat đã kéo dài, nơi chỉ có một chút tính toán mới cần làm. Vậy hãy tách hai loại workload đó ra, để request "dễ" không bị đẩy xấu ở P95, P99, mà bạn vẫn có đủ compute để phục vụ những request dài. Hóa ra nếu làm đúng và ghép lại với nhau, bạn có thể đạt throughput cao hơn tới 40% so với prefill-decode disaggregation chuẩn.
10. Lever 3: parallelism, rack 72 GPU, và mixture of experts
Mảng tiếp theo, vẫn thuộc nhóm tối ưu GPU cốt lõi, là parallelism. Parallelism qua nhiều GPU là một kỹ thuật gốc của mọi thứ họ làm trong inference. Động lực cơ bản: model đang trở nên rất, rất lớn. Bạn không thể nhét cả model lên một GPU, nên phải chia model thành nhiều mảnh.
Có vài cách:
- Mỗi layer của model có một lượng weights. Bạn chia weights của layer đó qua nhiều GPU, và làm all-reduce, một bước giao tiếp, ở hai đầu của vài operation then chốt. (Tensor parallelism, TP.)
- Hoặc bạn nói: tôi lấy vài layer này, chia chúng qua các GPU khác nhau. (Pipeline parallelism, PP.)
- Hoặc bạn nói: tôi xử lý nhóm request này trên một GPU, nhóm request kia trên GPU khác, và nhân bản một phần weights qua các GPU. (Data parallelism, DP.)
Mỗi cách có trade-off riêng. Khi đưa endpoint mới lên, khi làm việc với khách hàng mới và nhìn vào workload của họ, đội anh dành rất nhiều thời gian tune các cấu hình này để tối ưu theo nhu cầu và SLA của khách.
Máy mới của Nvidia: 72 GPU nói chuyện với nhau
Một thứ họ đặc biệt quan tâm là cách tận dụng những máy mới, lớn hơn mà Nvidia bắt đầu tung ra. Khoảng một năm trước Nvidia bắt đầu đưa ra các hệ Blackwell cỡ nguyên rack (GB200 NVL72, và sau đó GB300 NVL72). Cách nghĩ về chúng: cho tới khoảng hai năm trước, mỗi GPU nhiều nhất chỉ nói chuyện được với bảy GPU khác bằng interconnect thật nhanh. Giờ người ta bắt đầu xây máy cho phép 72 GPU nói chuyện với nhau qua interconnect rất nhanh. Điều đó mở ra nhiều lựa chọn hơn hẳn về cách chia workload, vì bạn không còn bị nghẽn nặng ở giao tiếp nữa.
Expert parallelism và mixture of experts
Một trong các ý tưởng đó là expert parallelism. Trong mọi model mới nhất, những open-source model tốt nhất hiện nay, tất cả đều là mixture of experts (MoE). Mỗi layer có thể có khoảng 48 bộ "expert" độc lập, mỗi bộ xử lý token theo cách khác nhau. Khi một request tới, có một chút logic nói: token này tôi sẽ route tới expert A, B, C. Ví dụ tôi có hai expert về khoa học, và tôi biết đây là câu hỏi hóa học...
11. Expert parallelism, node failure, và bài toán của router
...nên tôi route token đó tới phần đó của model. Ý tưởng cơ bản của expert parallelism là lấy 40, 48 thứ khác nhau đó và rải chúng ra nhiều GPU hơn hẳn. Điều này cho parallelism cao hơn nhiều, có thể throughput cao hơn nhiều, decode nhanh hơn nhiều. Nên khi Together đưa ra một thứ như một fast endpoint cho Kimi K3, họ có thể đang dùng một phần các kỹ thuật này.
72 GPU thì cũng 72 lần khả năng hỏng
Giờ nghĩ thêm: nếu một model duy nhất được chia qua 72 GPU khác nhau, thì ai từng dùng GPU đều biết chúng có tỷ lệ hỏng khá cao. Chúng có thể chết vì đủ lý do: ai đó cắm nhầm connector, máy quá nóng, một bug phần mềm, đủ kiểu.
Nên một việc họ dành rất nhiều thời gian là resiliency và node failure. Nếu có 72 GPU và một cái chết, bạn không muốn cả 72 GPU cùng fail và sập theo. Câu hỏi họ nghĩ rất nhiều: nếu một nhóm nhỏ trong các GPU này hỏng, làm sao vẫn dùng các GPU còn lại một cách có ích, vẫn phục vụ traffic.
Lên tầng hệ thống: routing phải vừa cân tải vừa biết cache
Giờ Dan bước ra khỏi tầng tối ưu GPU cốt lõi, lên các tối ưu ở tầng hệ thống. Cái đầu tiên là routing. Như đã nói, một việc then chốt của routing dĩ nhiên là load balancing: bạn không muốn replica nào quá nóng. Nhưng nó cũng phải biết prefix cache (prefix-cache aware).
Nhớ lại stage prefill: tôi đã gửi codebase 100.000 token vào, một GPU cụ thể đã xử lý nó và lưu toàn bộ kết quả tính toán vào memory của chính nó. Tôi không muốn request tiếp theo của mình bị gửi sang một GPU khác, rồi GPU kia phải xử lý lại tất cả từ đầu, vì đó là một khối tính toán thêm mà lẽ ra không cần làm.
Nên có một trade-off cơ bản. Mặt kia là: tôi có thể là một power user, tôi có thể đang spam API này với quá nhiều...
12. Lever 4: ThunderAgent routing; Lever 5: speculative decoding
...request. Nếu làm routing theo prefix cache một cách ngây thơ, chính tôi có thể tạo ra một replica "nóng" mà ta muốn tránh.
ThunderAgent routing
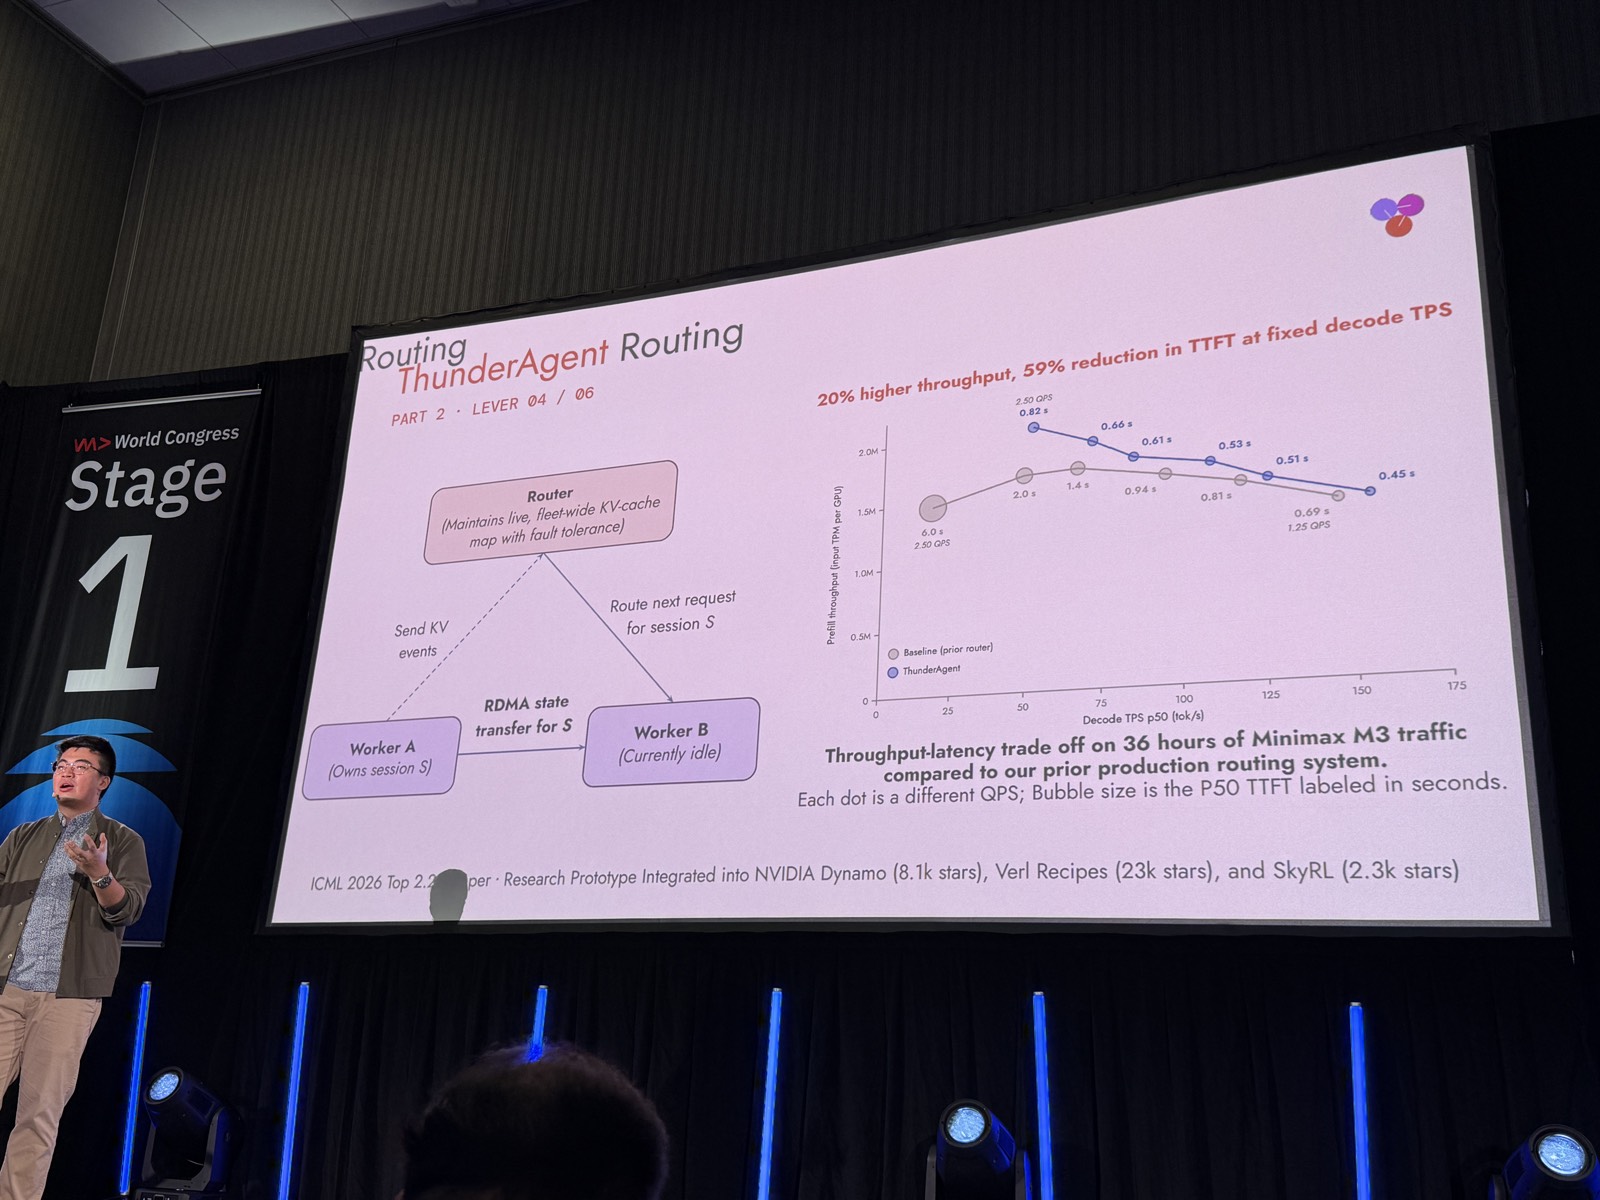
Một thứ họ công bố gần đây (Dan đùa là đầu anh đang che mất phần chữ trên slide) là một paper được xếp vào top khoảng 2% ở ICML: thuật toán ThunderAgent routing. Đây là một thuật toán routing mới, cân bằng hai lực đang kéo ngược nhau. Một là ý tưởng load balancing cơ bản. Hai là bạn muốn tiếp tục tái dùng KV cache, không làm lại phần tính toán không cần làm.
Ý tưởng cơ bản: ta có cách khác để chuyển phần tính toán đã cache từ replica này sang replica khác mà không cần tính lại. Tính lại luôn là một lựa chọn. Nhưng giả sử ta biết có worker B đang rảnh, còn tôi là user đang gửi nhiều request quá mức một worker gánh nổi. Ta có thể route request của tôi tới worker mới mà không phải tính lại những gì đã tính cho tôi: chỉ cần dùng giao tiếp GPU tới GPU để chuyển state từ worker này sang worker kia.
Nếu làm đúng, bạn có thể được throughput cao hơn 20% và giảm khoảng 60% time to first token trên một số workload thật. Ví dụ trên slide là trên traffic MiniMax.
Speculative decoding: để model nhỏ đoán, model lớn kiểm
Một thứ nữa có thể làm là speculative decoding. Ý tưởng: ta có một model rất lớn. Nó rất thông minh, làm được rất nhiều thứ. Nhưng nếu tôi hỏi nó câu gì đó ngớ ngẩn như "thủ đô của Pháp là gì?", thì có một model nhỏ hơn nhiều cũng trả lời đúng được.
Nên trong speculative decoding, bên cạnh model rất lớn, ta chạy thêm một model rất nhỏ cố đoán các token tiếp theo sẽ là gì. Do cách các model này được train, nếu đoán đúng, ta có thể trả chúng ra ngay từ model lớn. Về cơ bản bạn chỉ cần model lớn kiểm tra "đúng hay không", và việc đó rẻ hơn nhiều so với sinh từng token một. Thực tế bạn có thể...
13. Các biến thể speculative decoding, và Lever 6: quantization
...sinh ra 3, 4, 5, 10 token mỗi lần. Model nhỏ sinh chúng nhanh hơn nhiều, và việc kiểm tra xem chúng có đúng không cũng nhanh hơn nhiều so với để model lớn tự sinh từng token.
Ở Together họ làm rất nhiều cải tiến quanh speculative decoding. Vài ý tưởng: có thể để model nhỏ cũng sinh từng token một; hoặc có thể train model nhỏ sinh năm token một lần. Mỗi phương pháp có trade-off riêng, và họ dành nhiều thời gian để tìm ra nên train cái gì, nên deploy cái gì, cho từng model và từng use case. (Slide Together Compiler ở phần 8 cũng nhắc việc tự cải thiện speculator theo traffic đang tới.)
Lever 6: quantization, thu nhỏ model mà không mất chất lượng
Mảng cuối cùng Dan nói, và trên bản đồ lifecycle giờ KV cache cũng được tô cam, là quantization. Ý tưởng: bạn có thể có một model 3 nghìn tỷ parameter; ở dạng gốc mỗi parameter có thể tốn 1 byte, 2 byte, hay 4 byte để lưu. Thay vào đó, ta có thể thu gọn footprint xuống một byte mỗi parameter, hoặc ít hơn. Nhưng dĩ nhiên bạn mất một ít thông tin khi làm vậy.
Nên một câu hỏi Together nghĩ rất nhiều: làm sao thu nhỏ footprint của model mà không mất chất lượng. Họ đã xây một pipeline đo lường và lặp cho quantization rất chắc, để bảo đảm có thể quantize model, lấy được mọi lợi ích về throughput, mà không hy sinh chất lượng.
Một thành tích của họ ở mảng này: họ quantize được MiniMax xuống một checkpoint FP4 trước mọi provider khác. Dan kể lần này khá vui, vì chính MiniMax cũng chưa quantize được model đó xuống 4 bit mỗi parameter, nhưng Together làm được.
14. Tổng kết, lời mời, và MC khép lại
Tóm lại, hôm nay Dan đã nói về tất cả các stage mà một request đi qua khi bạn gửi nó đi và khi các token thật sự được xử lý: routing, tokenize và tool calling, queue và batch, prefill, decode, stream out. Anh cũng nói về cách Together nghĩ để tối ưu từng chặng trên bản đồ đó, và một số nỗ lực research của họ: kernels và Together Compiler, cache-aware disaggregation, parallelism trên rack 72 GPU, ThunderAgent routing, speculative decoding, và quantization.
Cuối cùng là một lời mời nhỏ. Nếu bạn thấy những tối ưu kiểu này thú vị, hãy tới làm cùng họ: mã QR trên slide dẫn tới trang careers của Together nếu bạn muốn build những thứ này. Còn nếu bạn đang dùng AI trong ứng dụng và tò mò về open source, mã QR thứ hai dẫn tới form liên hệ sales. "So with that, thank you so much."
MC quay lại: "Awesome. All right, give it up for Dan. Thank you, Dan." Chị báo talk tiếp theo sẽ bắt đầu đúng giờ sau khoảng 10 phút, mọi người cứ đi nghỉ giải lao, lấy cà phê, nhưng nhớ quay lại phòng sau 10 phút cho talk kế tiếp. "Thanks, folks."
Nguồn và link
- Trang session chính thức: Anatomy of an AI Request · Dan Fu, VP of Kernels, Together AI · danfu.org
- Together AI · Together AI blog · Together AI docs · Careers
- Together AI blog: Cache-aware prefill-decode disaggregation (CPD)
- Together AI blog: ThunderAgent
- Nơi ThunderAgent được tích hợp theo slide: NVIDIA Dynamo · verl · SkyRL
- Phần cứng rack-scale: NVIDIA GB200 NVL72 · NVIDIA GB300 NVL72
- Bài nền: Fast Inference from Transformers via Speculative Decoding · PagedAttention / vLLM · DistServe (prefill-decode disaggregation)
- Số liệu share token của open-weight model: OpenRouter rankings
- Chưa tìm được nguồn: bài blog riêng của Together về việc quantize MiniMax sang FP4, và số liệu "khoảng 1/8 số token của Google".
Related talks
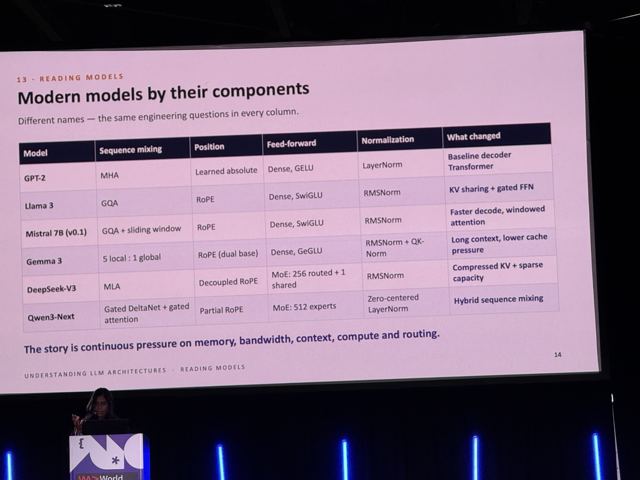
Understanding LLM Architectures: Inside the Design of Modern Models
Jofia Jose Prakash · Humanity + AI · 30 min
Đọc LLM hiện đại theo component (GQA, MLA, local attention, MoE, Gated DeltaNet) và biết phải đo gì khi swap model trong production.
AI and Video games: The Evolution
Jack McCauley · Oculus · 35 min
Từ render Terminator 2 trên 20 workstation tới GPU và AI sinh asset bằng lời: vì sao game sẽ photoreal và một người làm được việc của cả studio.
From Software Agents to Physical Devices: Inside the Agentic Hardware Stack
Michael Yuan · Second State · 35 min
Vì sao attention là nút cổ chai khi chạy nhiều agent, và cách VibeKeys dùng Wi-Fi, MQTT, vibetty để báo trạng thái agent chạy trong Docker Sandbox.